Command Palette
Search for a command to run...
以模型自身的劣化版本引导扩散模型
以模型自身的劣化版本引导扩散模型
Tero Karras Miika Aittala Tuomas Kynkäänniemi Jaakko Lehtinen Timo Aila Samuli Laine
摘要
图像生成扩散模型的主要关注维度包括图像质量、生成结果的多样性以及与给定条件(如类别标签或文本提示)的对齐程度。目前广泛使用的无分类器引导方法利用无条件模型来引导条件模型,从而在降低多样性的代价下同时获得更好的提示对齐和更高的图像质量。这些效应似乎本质上相互耦合,难以独立控制。我们提出了一个令人意外的发现:通过使用模型自身的一个更小、训练更不充分的版本(而非无条件模型)来引导生成,可以在不牺牲多样性的前提下实现对图像质量的解耦控制。该方法在 ImageNet 上带来了显著提升,仅使用公开可用的网络即取得了 64×64 分辨率下 FID 为 1.01、512×512 分辨率下 FID 为 1.25 的创纪录结果。此外,该方法同样适用于无条件扩散模型,可大幅提升其生成质量。
一句话总结
NVIDIA 和 Aalto University 提出 Autoguidance,该方法使用同一个模型更小、训练更少的版本而不是无条件模型来引导扩散模型的生成,从而在不牺牲变化性的情况下实现对图像质量的解耦控制,并在 ImageNet 的 64×64 和 512×512 分辨率上分别取得 1.01 和 1.25 的 FID 纪录。
核心贡献
-
本文提出一种引导方法:用同一条件模型的一个更小、训练更少的版本替代无条件模型,从而在保留样本变化性的同时实现对图像质量的解耦控制。
-
对 classifier-free guidance 的分析将其图像质量提升解释为自适应截断,即把样本从欠拟合区域推向隐含的高质量分布。简单的各向同性 score 放大则会均匀拉长 score 向量,从而降低变化性并过度简化细节。
-
实验表明,使用公开可用的网络在 64×64 和 512×512 上分别得到 1.01 和 1.25 的创纪录 ImageNet FID 分数;同一引导方法也能显著提升无条件扩散模型。
引言
去噪扩散模型通过学习到的 score function 迭代去除噪声来生成图像,并通常以标签或文本提示作为条件来控制输出。实践中,它们通常采用 classifier-free guidance 进行采样;这是一种标准做法,通过对比条件去噪估计与无条件去噪估计来降低生成温度,从而改善提示词对齐程度和图像质量。然而,classifier-free guidance 仅适用于条件生成;由于引导模型求解的是另一项任务,它可能把样本推向偏离目标条件分布的区域;它还会把质量提升与提示词遵循程度提升耦合在一起。本文提出 autoguidance,改为在相同条件下使用同一模型的一个更弱版本来引导采样,例如降低容量或训练预算的版本。该方法保留质量提升效果,避免任务不匹配问题,支持无条件生成,并改善以 FID 及类 FID 指标衡量的图像质量。
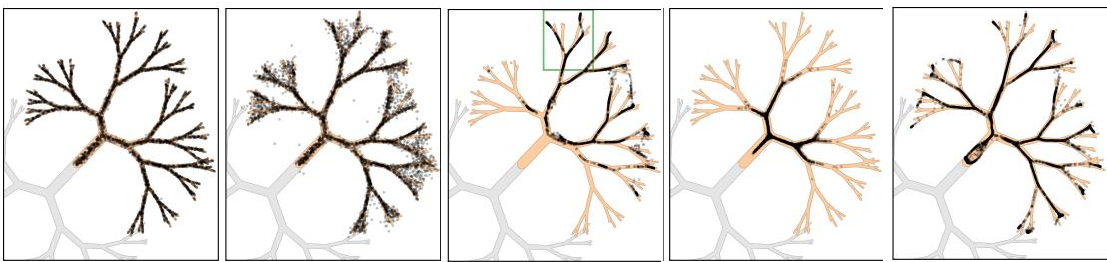
方法
本文利用 autoguidance,通过同一个模型的一个刻意更弱版本来引导强扩散模型,从而提升生成质量。该方法使用两个去噪器,分别记作 D1 和 D0。D1 是目标高质量模型,而 D0 是在同一任务、相同条件接口和相同数据分布上训练的退化模型。较弱模型与较强模型的区别在于存在额外的质量限制,例如更低容量、更少训练迭代次数、更低训练质量,或在推理时施加合成扰动。
在推理时,标准去噪器输出被替换为增强强弱预测差异的引导输出。按照 w=1 对应无引导强模型这种权重约定,引导后的去噪器可以写成
D~(xt,t,c)=D0(xt,t,c)+w[D1(xt,t,c)−D0(xt,t,c)].等价地,
D~(xt,t,c)=D1(xt,t,c)+(w−1)[D1(xt,t,c)−D0(xt,t,c)].其中,xt 是当前噪声样本,t 是扩散时间步,c 是可选条件信号,w 控制引导强度。在采样过程中,每一步都会评估 D1 和 D0,二者的差异为去噪器预测提供修正方向。该修正不引入外部分类器、单独条件分支或不同的目标分布。
其动机在于,有限的模型容量和欠训练往往会让扩散模型产生特征性错误。在容量受限的情况下,score matching 往往会过度关注数据分布中的低概率或欠表示区域。具体失效模式取决于架构、数据集和训练细节,但同一模型的更弱版本通常会在相似区域产生大体相似的错误,只是错误更明显。autoguidance 利用 D1 与 D0 的分歧来估计强模型可能出错的位置,并把样本推离那些退化预测。当两个模型一致时,修正较小;当它们不一致时,差异表明一个与样本质量提升相关方向。
为了使该方法有效,两个模型必须经历相容的退化。主模型 D1 与引导模型 D0 应针对相同数据分布,并产生同一类通用误差。二者的质量差距也必须足够大,使引导造成的系统性密度外扩超过随机初始化、数据打乱顺序和独立训练轨迹等随机差异。实践中,D0 可以构造为更小的网络、早期训练快照,或带有受控扰动的基础模型版本。
本文通过向一个充分训练的真实世界扩散模型施加受控合成退化来验证这一原则。未处理的基础模型作为参考,用于衡量引导是否恢复原始样本质量。在 dropout 设置中,使用轻度 dropout 变体作为 D1,更强 dropout 变体作为 D0。使用相容 dropout 强度进行 autoguidance 能够把性能恢复到接近未损坏基础模型的水平。在输入噪声设置中,D1 通过提高基础模型的输入噪声水平形成,并相应调整噪声条件,而 D0 使用更大的噪声增加。再次说明,相容的噪声扰动能够让引导把性能恢复到接近基础模型的水平。
当退化不匹配时,例如对 D1 使用 dropout 而对 D0 使用输入噪声,引导不会带来收益。在这种情况下,禁用引导,即对应 w=1,会得到最佳结果。这支持了核心设计约束:只有当两个模型共享共同的退化模式,从而存在有意义的质量方向时,autoguidance 才有效。
这种设计的一个关键架构结果是,引导不再依赖无关的条件模型或 null model。相反,它将图像质量修正与条件机制隔离开来。由于两个模型处理同一个分布,autoguidance 预计不会受到 classifier-free guidance 中观察到的高噪声限制影响;在后者的不同条件分布在内容上可能差异很大,并可能不必要地降低多样性。
实验
实验通过受控合成退化以及使用 EDM2 基线的 ImageNet 扩散基准来评估 autoguidance,比较主模型与较弱引导模型在相容或不匹配退化下的表现。结果表明,只有当引导模型复现与主模型相同的大类误差时,autoguidance 才有效,尤其是在其容量更小、训练时间更短的情况下。总体而言,该方法相较于 classifier-free guidance 提升了生成质量,同时更好地保留多样性、图像覆盖和视觉风格,并对无条件生成带来显著收益。
在两种 ImageNet 分辨率上,autoguidance 均优于基线和常见引导变体,提升了扩散模型的生成质量。当引导模型比主模型更小且训练时间更短时取得最佳结果;为两个模型使用独立 EMA 设置还能进一步提升效果。该方法在无条件生成中也带来显著收益;与条件情况相比,基线在此类任务中的性能弱得多。容量更小且训练预算更短的引导模型带来最强的质量改进。让主模型和引导模型共享相同 EMA 设置,相比使用独立 EMA 长度会使结果变差。autoguidance 显著改善了无条件 ImageNet 生成,而基线在这类设置中的表现更差。
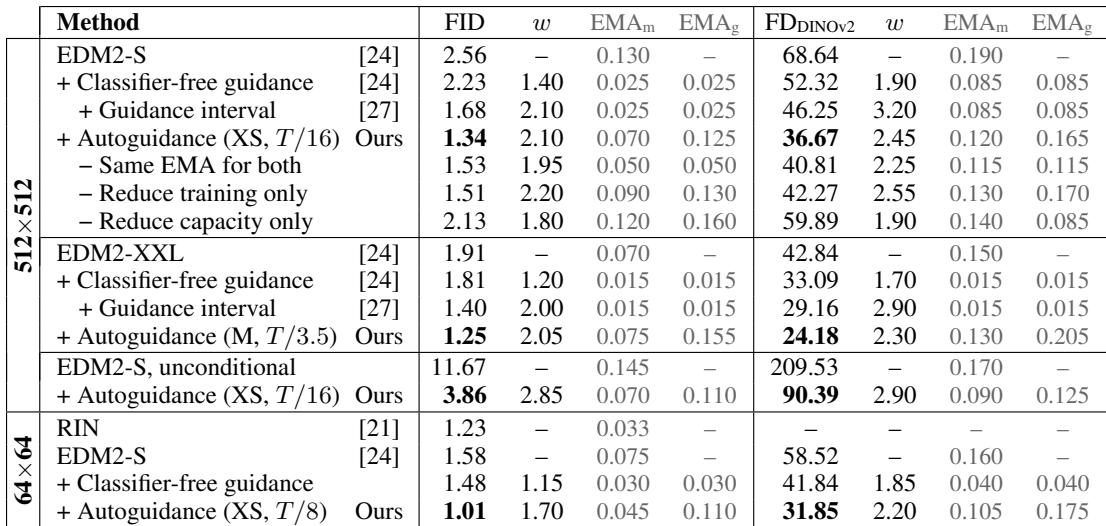
实验表明,autoguidance 相较于基线和常见引导变体能够改善不同 ImageNet 分辨率上的扩散模型生成效果,在基线性能较弱的无条件生成中收益尤其大。当引导模型比主模型更小且训练时间更短,且为两个模型使用独立 EMA 设置时,可取得最强质量提升。