Command Palette
Search for a command to run...
PRISM 对齐数据集:参与式、代表性及个体化人类反馈如何揭示大语言模型的主观性与跨文化对齐问题
PRISM 对齐数据集:参与式、代表性及个体化人类反馈如何揭示大语言模型的主观性与跨文化对齐问题
摘要
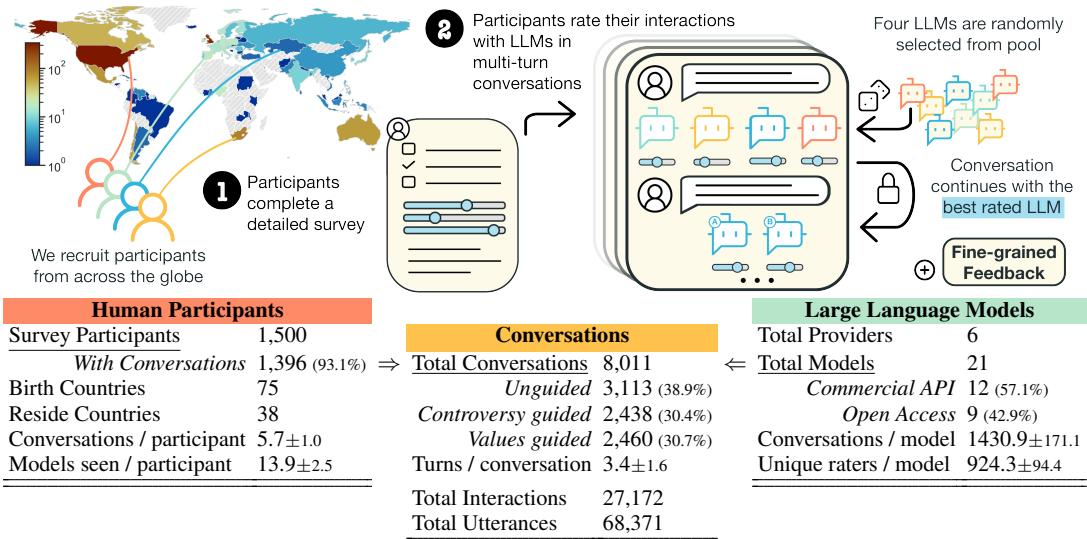
人类反馈是大语言模型(LLM)对齐的核心环节。然而,反馈过程在方法(如何)、领域(何地)、人群(何人)及目标(为何)等方面仍存在诸多开放性问题。为应对上述问题,我们提出了 PRISM 数据集,将来自 75 个国家的 1,500 名多样化参与者的社会人口统计特征和声明偏好,映射到他们在与 21 个大语言模型的 8,011 段实时对话中的情境偏好和细粒度反馈。通过 PRISM,我们实现了:(i)更广泛的地理和人口统计参与;(ii)两个国家(英国、美国)的人口普查代表性样本;(iii)与详细参与者画像关联的个体化评分,从而支持个性化处理及样本偏差归因。我们聚焦于价值负载和争议性议题上的主观性与跨文化视角,预期这些议题存在人际间和跨文化间的分歧。我们通过三个案例研究,展示了审慎考量由何人提供何种对齐数据的必要性。
一句话总结
牛津大学、宾夕法尼亚大学、博科尼大学等机构推出 PRISM,这是一个将来自 75 个国家的 1,500 名多样化参与者的社会人口学特征和陈述偏好,映射到与 21 个 LLM 进行的 8,011 次实时对话中的细粒度反馈的数据集,从而形成参与式、代表性和个体化的对齐数据,用于研究主观和多文化分歧。
核心贡献
- PRISM 是一个数据集,将来自 75 个国家的 1,500 名参与者的社会人口学特征和陈述偏好,与来自 21 个 LLM 的 8,011 次实时对话中的情境偏好和细粒度反馈关联起来。
- 该数据集扩大了地理和人口学参与范围,包含英国和美国的普查代表性样本,并提供与详细参与者画像关联的个体化评分,用于个性化和样本伪影归因。
- 论文在价值负载和争议性议题中的主观与多文化视角方面使用 PRISM 进行了三项案例研究,说明需要考察哪些人提供了哪些对齐数据。
引言
由于大型语言模型通过人类反馈进行对齐,反馈数据的设计会直接影响系统学到哪些偏好和价值观。现有反馈数据集通常依赖二元比较、狭窄的标注者群体、有限的参与者信息和薄弱的价值记录,可能将个人和文化情境压缩为简化标签。作者推出 PRISM,这是一个人类反馈数据集,将来自 1,500 名英语参与者的详细问卷回答、参与者画像、陈述偏好和实时 LLM 对话关联起来,其中包括英国和美国的普查代表性样本。该资源可用于个性化对齐、价值共识分析、福利研究,以及采样选择和分歧如何影响模型行为的研究。
数据集
-
作者介绍 PRISM,一个面向 LLM 对齐的人类偏好与元数据数据集,由通过 Prolific 招募的 1,500 名英语参与者构建。数据收集时间从 2023 年 11 月 22 日至 12 月 22 日,并采用知情同意、化名标识和 PII 检查。该数据集有意保持多样性,但仍偏向白人、西方、受过教育和英语使用者。
-
数据由两个相互关联的阶段构建。首先,每位参与者完成一份问卷,形成包含标准人口学信息、LLM 熟悉度与使用情况、自写的“宪法”或系统字符串、开放式价值描述,以及关于 LLM 行为的结构化陈述偏好的画像。人口学覆盖范围包括出生在 75 个国家的人群,84% 的参与者报告直接或间接使用 LLM。
-
问卷阶段使用筛选和质量控制:参与者必须年满 18 岁、给予知情同意、阅读简短的 LLM 入门说明,并被劝阻提交由 LLM 撰写的回答。陈述偏好使用 0 到 100 的视觉模拟量表评分,参与者看不到数值。开放式自我描述的种族和宗教被人工标注为更宽泛的类别,以便分析。
-
对话阶段收集对话现场偏好数据。参与者针对三类提示各完成两次对话,分别为无引导、价值引导和争议引导,总共完成六次对话。在每次对话中,参与者编写开场提示,并接收来自不同 LLM 的最多四个响应,每个响应按隐藏的 1 到 100 量表评分。
-
在每场对话中,开场回合得分最高的 LLM 会被锁定用于后续回合。参与者必须继续至少一个额外回合,总对话长度从 2 到 10 回合不等,平均为 3.4 回合。在后续回合中,参与者对选定模型生成的两个非确定性响应进行评分。
-
对话元数据包括模型身份、响应评分、提示类型、对话长度和细粒度的对话后反馈。参与者对表现陈述和选择陈述进行评分,并提供开放式对话反馈,平均为 29 个词。问卷阶段和对话阶段复用相同的行为属性,以比较陈述偏好和情境偏好。
-
模型响应来自 21 个 LLM,包括 9 个开放访问模型和 12 个商业 API 模型。为减少长度混杂和疲劳,系统提示指示模型将响应保持在 50 词或更少。数据集报告的毒性相对较低,为 0.06%,发布前未进行审核,以支持对话安全研究。
-
论文将 PRISM 用作偏好反馈数据集,而不仅仅作为通用提示响应语料。1 到 100 的基数评分可作为偏好强度分数,或转换为排名,用于奖励建模式分析。参与者画像与现场评分配对,用于研究个体特征与实时模型偏好的关系。
-
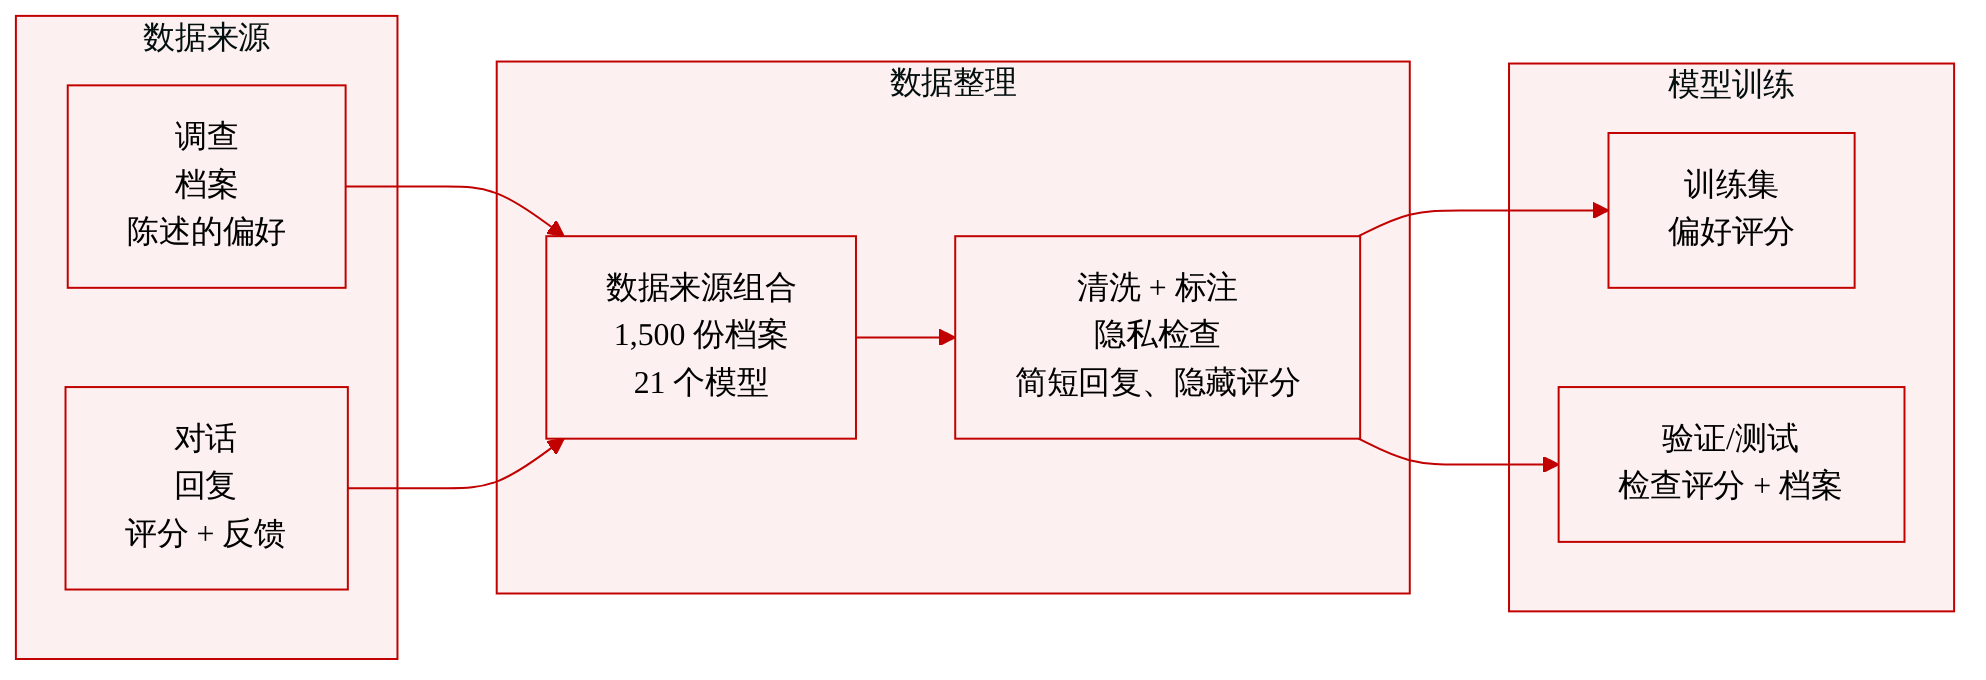
摘录未规定正式训练划分、混合比例或裁剪策略。主要处理细节包括问卷画像构建、人口学标注、PII 处理、隐藏数值评分、为后续回合固定选择顶尖模型、长度控制系统提示,以及收集开放式反馈作为对话元数据。
方法
该方法通过阶段性人类交互流程构建对齐数据集,而不是单一偏好标注任务。流程始于参与者问卷,在任何模型对话发生之前建立画像和陈述偏好。问卷收集关于先前接触和使用大型语言模型的信息,并要求参与者编写自定义系统字符串,称为“宪法”或模型应如何行为的治理原则集合。这一问卷阶段通过捕捉陈述偏好和个人价值,为后续对话评分创建情境。
问卷之后,参与者通过基于 Dynabench 平台构建的自定义界面进入与模型的实时对话。为鼓励客观与主观谱系上的多样性,参与者针对三种对话类型各完成两次对话,每位参与者产生六次对话。这些条件是无引导、价值引导和争议引导。无引导条件允许自由选择主题,而价值引导和争议引导条件促使参与者关注个人有意义的问题或社会上有争议的议题。该设计旨在引出比不受约束提示本身更广泛的人类价值和偏好信号。
每场对话的第一个回合是多模型比较步骤。参与者编写自由文本开场提示,并接收来自不同大型语言模型的最多四个响应。每个响应都使用从“糟糕”到“完美”锚定的视觉模拟量表评分。滑块位置被记录为 1 到 100 的数值分数,但参与者看不到该数字,以减少锚定效应和对话评分之间的依赖。作者选择这种基数反馈,因为它鼓励主观性,允许在需要时转换为排名,并捕捉超出二元选择与拒绝比较的偏好强度。随后,第一个回合中得分最高的模型会被锁定用于后续回合,得分相同时随机打破平局。
后续对话回合侧重于同一模型内部比较。参与者至少继续一个额外回合,鼓励总回合数在 2 到 10 之间,以避免引入人工长度偏差。平均对话长度为 μT=3.4,标准差为 σT=1.6。在后续回合中,参与者对同一选定模型使用非确定性解码生成的两个响应进行评分。由于两个响应来自同一模型,它们在风格和内容上比第一回合的响应更相似,分数差异通常更窄。这形成了与开场回合跨模型比较互补的信号。
对话结束后,流程收集情境化细粒度反馈。参与者首先评估第一回合中评分最高模型的某些属性表现,例如流畅性、事实性、安全性、多样性、创造性、有用性和价值对齐。然后他们评估这些属性对其在多个模型之间选择的重视程度。相同属性也作为陈述偏好出现在初始问卷中,从而可以比较抽象价值和情境依赖判断。如下方图所示,属性模式将问卷中的陈述偏好与每次对话后收集的表现属性和选择属性关联起来。
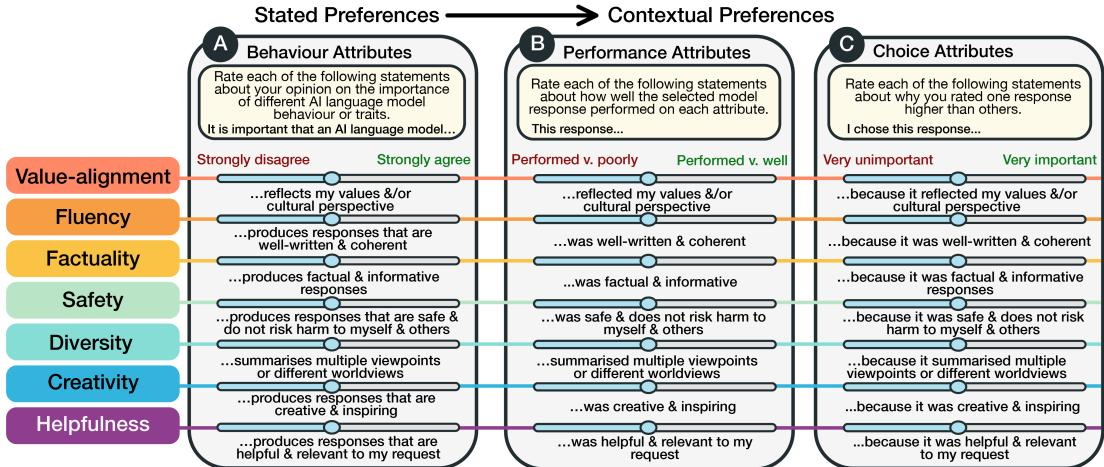
这种三部分属性设计使流程适用于奖励建模和偏好分析。陈述偏好在交互前捕捉宽泛态度,表现属性捕捉选定模型在特定质量上的满足程度,选择属性捕捉该模型相对于其他模型被偏好的原因。最终阶段还收集关于整体对话的开放式自然语言反馈,包括哪里表现良好、哪里表现不佳、缺少什么,以及如何改进交互。
系统设计还纳入采样和模型多样性,以减少最终训练信号中的偏差。参与者招募围绕两条互补路径组织:在有普查匹配配额可用时使用普查代表性样本,以及在国家专项研究按全球区域分配配额时使用平衡全球样本,以防止特别活跃的参与者群体过度代表。在可能的情况下,国家样本内追求性别平衡。对于模型选择,流程采用与模型无关的设置,使用 21 个大型语言模型,涵盖开放访问和商业 API 系列、不同参数规模,以及不同现有安全或对齐行为水平。为控制响应长度和参与者疲劳,系统提示要求模型保持响应不超过 50 词。这种受控但多样化的生成环境产生反映广泛人口学情境和多样模型行为的偏好数据。
实验
使用 PRISM 数据集的实验评估身份和情境如何塑造用户与 LLM 的初始对话、模型偏好,以及从采样反馈中选择模型对福利的影响。主题聚类和回归分析显示,人口学群体过度讨论特定问题,但多样化用户也共享共同语义空间;成对偏好聚合显示模型排名随对话主题和背景变化,某些风格特征只能解释部分评分差异。福利模拟进一步表明,较小或存在偏差的样本可能损害代表性不足群体的结果,并且没有任何单一模型能满足所有用户。