Command Palette
Search for a command to run...
随机化 Taylor 导数估计器:任意微分算子的高效摊销
随机化 Taylor 导数估计器:任意微分算子的高效摊销
Zekun Shi Zheyuan Hu Min Lin Kenji Kawaguchi
摘要
优化包含高维高阶微分算子的损失函数的神经网络代价高昂,因为导数张量的大小随 O(dk) 增长,且计算图的复杂度随 O(2k−1L) 增长,其中 d 为定义域的维度,L 为前向计算图中的算子数量,k 为导数阶数。已有工作通过随机化在优化过程中摊销计算,解决了关于 d 的多项式缩放问题;另有工作利用高阶自动微分(AD)解决了单变量函数(d=1)中关于 k 的指数缩放问题。本文证明,通过合理构造单变量高阶 AD 的输入切向量,可以高效地对多元函数任意阶导数张量执行任意缩并操作,从而高效地随机化任意微分算子。将该方法应用于物理信息神经网络(PINNs)时,相比使用一阶 AD 的随机化方法,实现了超过 1000 倍的加速和超过 30 倍的内存缩减,并可在单张 NVIDIA A100 GPU 上 8 分钟内求解一百万维的偏微分方程。本工作为在大规模问题中使用高阶微分算子开辟了新的可能性。
一句话总结
新加坡国立大学和 Sea AI Lab 的研究人员提出了 Stochastic Taylor Derivative Estimator(随机 Taylor 导数估计器),它构造面向单变量高阶自动微分的输入切向量,以高效缩并多元函数的任意阶导数张量,在使用物理信息神经网络求解高维 PDE 时,相比之前的随机化方法实现了 >1000× 倍加速。
核心贡献
- 论文提出 STDE,这是一种通用方法,通过单变量 Taylor 模式自动微分构造任意微分算子的随机估计器,从而高效计算高阶导数张量的任意缩并。
- STDE 将随机化与高阶自动微分相结合,降低了神经网络损失中高维高阶微分算子的成本,适用于物理信息神经网络,以及对抗攻击、特征归因和元学习等其他输入梯度问题。
- 在物理信息神经网络上的实验表明,相比使用一阶自动微分的随机化方法,实现了超过 1000 倍加速和超过 30 倍内存占用降低,并能够在单块 NVIDIA A100 GPU 上以 8 分钟求解一百万维 PDE。
引言
作者从事自动微分与物理信息机器学习的交叉研究,其中训练目标常包含神经网络关于其输入的高阶导数。使用重复反向模式自动微分计算这些导数时,其成本会随导数阶数和输入维度呈指数增长。而 SDGD、Hutchinson 迹估计器、有限差分和随机平滑等随机化方法可以降低成本,但通常依赖近似,主要适用于低阶或类似拉普拉斯算子的算子,并且可能对离散化或估计器方差敏感。
作者利用 Taylor 模式自动微分提出 Stochastic Taylor Derivative Estimator,该方法通过构造输入切向量来缩并高阶导数张量,并高效随机化任意微分算子。其方法推广了以往的随机估计器,阐明了 Hutchinson 类方法在四阶以上时的局限,并使 PINNs 的训练更快且内存效率更高,包括在单 GPU 上处理百万维 PDE 问题。
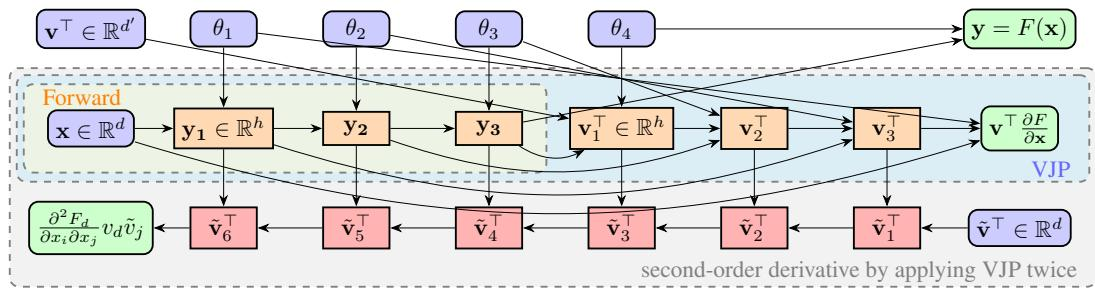
方法
作者首先引入 Stochastic Dimension Gradient Descent 作为算子近似步骤。微分算子 D 被分解为若干加性项,每一项只依赖于少数输入维度,并在每次迭代时采样一个随机子集:
D:=j=1∑NDDj≈∣J∣NDj∈J∑Dj:=D~J,其中 J 是采样索引集合。这降低了大输入维度 d 下微分的成本,但并未消除对导数阶数 k 的指数依赖。因此,主要方法构建在 Taylor 模式自动微分之上,并将高阶导数张量缩并转化为高效的射流传播过程。
核心数学思想是把单变量 Taylor 模式自动微分算子看作多元导数张量的缩并。点 a 处的 k 阶射流可写为
Jgk(t)=(g(t),v(1),…,v(k)),并将该射流通过函数 F 传播,可计算高阶弗雷歇导数。通过将某些切向量设为 0,可以选择导数张量的对角、混合或结构化元素。因此,k 阶微分算子可表示为导数张量与系数张量之间的缩并。对于标量函数 u:Rd→R,k 阶算子 L 可写为
Lu(a)=d1,…,dk∑Duk(a)d1,…,dkCd1,…,dk(L)=Duk(a)⋅C(L),其中 C(L) 仅在对应算子各项的多重索引处非零。拉普拉斯算子是一个简单例子,因为其系数张量是单位矩阵 I。
提出的 Stochastic Taylor Derivative Estimator 用随机缩并替代精确张量缩并。若随机射流的矩与系数张量匹配,即
E[vd1(v1)⋯vdk(vk)]=Cd1,…,dk(L),那么随机高阶射流的推前会给出无偏估计器:
EJgl∼p[∂lu(Jgl)]=Lu(a).实践中,作者通过对独立采样的若干射流进行推前并取平均来估计 Lu(a)。主要计算模块因此包括:随机射流采样器、Taylor 模式自动微分推前和样本均值估计器。这种设计避免了显式构造和存储完整的 k 阶导数张量 Duk。
推前的计算图是方法可扩展性的核心。如下图所示:
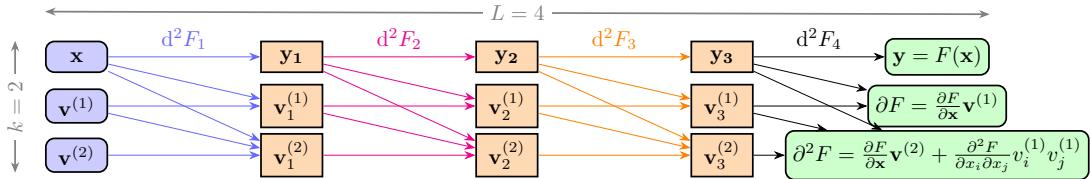
图示为通过一系列基本操作完成的二阶推前。左列包含输入 2 阶射流,其原值为 x,切向量为 v(1) 和 v(2)。每个基本操作将一个射流映射到下一个射流,因此前一阶段的输出成为后一阶段的输入。第一切向量分支对应雅可比向量积,第二切向量分支累加黑塞向量积和二次黑塞形式。由于同一层的所有切向量阶数可以并行处理,该方法不需要对导数阶数进行顺序展开。对于一次 dkF 调用,内存开销为 O(kd),计算开销为 O(k2dL),其中 L 是基本操作数量。当只需要导数方向的子集时,随机化还消除了对输入维度 d 的多项式依赖。
对于许多算子,作者构造稀疏随机射流。任何系数张量都可分解为基张量项:
C(L)=d1,…,dk∑Cd1,…,dked1⊗⋯⊗edk,其中 ei 是第 i 个标准基向量。该方法从这些基向量中构建稀疏射流,并以与相应系数项成比例的概率进行采样:
p(⊗i=1kedi)=ZCd1,…,dk,其中 Z 是归一化因子。归一化抵消了算子的加性形式。例如,拉普拉斯估计器采样索引 j,并使用第一切向量 ej,并令第二切向量为零执行二阶推前:
∇~J2uθ(a)=∣J∣dj∈J∑∂2uθ(a)(ej,0).对于高阶对角算子 L=∑j∂k/∂xjk,可采用相同模式:将第一阶切向量设为 ej,并将所有更高阶切向量设为零:
L~Juθ(a)=∣J∣dj∈J∑∂kuθ(a)(ej,0,…).对于二阶抛物型 PDE,扩散项可能包含非对角黑塞元素。作者通过变量替换消除这一困难,使算子化为如下形式的求和
∂2u(x,t)(σ(x,t)ei,0).随后,随机估计器针对由 σ(x,t) 的列生成的各项进行采样。
当混合偏导数无法通过这种重构消除时,作者提高射流阶数,并将每个目标张量元素编码为更高阶推前的输出。所需阶数取决于目标张量切片的非对角程度。如果所有被求导的维度互不相同,则需要更高阶射流,并通过从输出射流读取不同阶数的切向量并应用链式法则缩放因子来恢复相应的导数。这使得任意 k 阶导数张量元素都可以通过 Taylor 模式自动微分访问,而无需构造完整张量。
该方法也支持稠密随机射流。经典 Hutchinson 迹估计器作为特例可被恢复:其一阶切向量从满足 E[vv⊤]=I 的分布中抽取,并令第二切向量为零进行二阶推前。对于具有对称正则化系数张量的一般二阶算子
C′′=21(C+C⊤)+λI=UΣU⊤,作者通过抽取协方差为 Σ 的高斯切向量并减去与 λI 相关的校正项来构造估计器。稠密 STDE 对某些算子可能更高效,但并非在二阶以上普遍适用。稀疏版本仍具有一般性,而稠密版本可在特定情形下降低方差。
实验
实验评估了 STDE 用于摊销式 PINN 训练的情形,涉及不可分离、半线性抛物型、高阶和高维 PDE。结果表明,随机微分估计保持了 PINN 优化目标,同时相比标准反向模式方法大幅降低了训练计算量和内存占用。消融研究进一步将收益归因于实现选择和有利的扩展性;精确导数方法在高维下效果下降,而 STDE 仍保持更高效率。
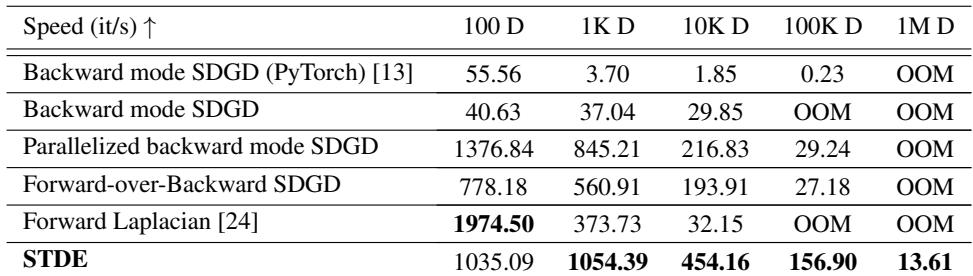
速度消融表明,实现和并行化选择显著影响两体 Allen-Cahn 方程的吞吐量。STDE 随维度的扩展性比 PyTorch 或顺序反向模式 SDGD 更稳健,并在许多基线因内存不足失败时仍可在极高维度下使用。Forward Laplacian 在低维下表现最佳,但扩展性较差,并在更高维度下失败。将反向模式 SDGD 从 PyTorch 迁移到 JAX 会带来大幅加速。并行化反向模式 SDGD 相比顺序 JAX 版本显著提升速度。Forward Laplacian 在低维下最快,但随着维度增长性能急剧下降。在所比较方法中,STDE 表现出最佳的高维可扩展性。据报告,STDE 相比最强 SDGD 基线在速度和内存上均有显著增益。
内存对比显示,随着输入维度增长,STDE 仍保持内存效率,而基线随机梯度方法和精确 Forward Laplacian 的扩展性较差。使用 JAX 重新实现原始方法并并行化采样维度工作,可使峰值内存相对原始 PyTorch 循环降低,但在极大维度下仍会出现内存不足。在高维设置中,STDE 使用内存远低于最强 SDGD 基线,并避免了精确拉普拉斯方法糟糕的扩展性。STDE 在最大测试维度下仍保持内存效率,而基线已失败。JAX 和并行化相比原始 PyTorch 实现降低了峰值内存。Forward Laplacian 仅在小维度下具有内存竞争力,并在高维下扩展更差。并行化反向模式和混合模式变体表现出相似的内存行为。STDE 相比最强 SDGD 基线实现了显著内存节省。
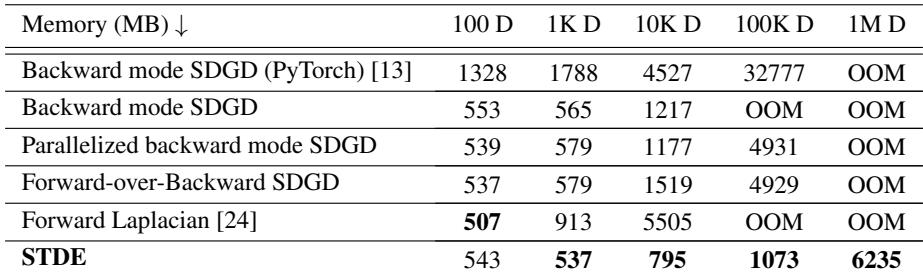
实验通过速度消融和内存对比评估了两体 Allen-Cahn 情形,验证了实现、并行化以及跨方法扩展行为的影响。速度结果显示,JAX 和并行化改进了反向模式 SDGD,Forward Laplacian 仅在低维下最快,而 STDE 扩展性最稳健,并在极高维度下仍可用。内存结果证实,STDE 避免了精确拉普拉斯方法糟糕的扩展性,并在与最强 SDGD 基线相比时实现了显著内存节省;同时,JAX 和并行化降低了峰值内存。