Command Palette
Search for a command to run...
并非所有 Token 都是预训练所必需的
并非所有 Token 都是预训练所必需的
摘要
现有语言模型预训练方法对所有训练词元统一施加下一词元预测损失。本文挑战这一常规做法,提出"语料中并非所有词元对语言模型训练同等重要"的观点。通过对语言模型词元级训练动态的初步分析,揭示了不同词元间截然不同的损失模式。基于上述发现,我们提出了一种新型语言模型 RHO-1。与传统语言模型学习预测语料中每一个下一词元不同,RHO-1 采用选择性语言建模(SLM),仅在与目标分布一致的有用词元上进行选择性训练。具体而言,该方法利用参考模型对词元进行评分,随后针对得分较高的词元施加聚焦损失来训练语言模型。在 15B OpenWebMath 语料上进行持续预训练时,RHO-1 在 9 项数学任务上的少样本准确率绝对提升最高达 30%。经过微调后,RHO-1-1B 和 RHO-1-7B 在 MATH 数据集上分别取得了 40.6% 和 51.8% 的最先进结果——仅使用 3% 的预训练词元即可匹敌 DeepSeekMath。此外,在 80B 通用词元上进行持续预训练时,RHO-1 在 15 项多样化任务上平均提升 6.8%,有效提高了语言模型预训练的数据效率与性能。
一句话总结
来自厦门大学、清华大学和上海人工智能实验室的研究人员提出 RHO-1,这是一种语言模型,它不同于均匀的下一 token 预测,引入了选择性语言建模(Selective Language Modeling, SLM),利用参考模型对 tokens 打分并过滤,以便聚焦损失计算,在 9 个数学任务上实现最高 30% 的绝对提升,并在 MATH 上达到与 DeepSeekMath 相当的 SOTA 结果,且仅使用预训练 tokens 的 3%。
核心贡献
- 对预训练动态的 token 级分析表明,大幅损失下降主要发生在被选中的 tokens 上,而许多容易的 tokens 和困难的 tokens 可能导致低效梯度更新。
- RHO-1 引入选择性语言建模,其中参考模型根据期望分布对 tokens 打分,而目标模型仅针对具有高参考模型分数或较大超额损失的 tokens 使用聚焦损失进行训练。
- 在 15B OpenWebMath 语料上进行数学持续预训练,在 9 个数学任务上带来最高 30% 的绝对少样本准确率提升,微调后的 RHO-1-1B 和 7B 在 MATH 上达到 40.6% 和 51.8%,其中 RHO-1-7B 使用预训练 tokens 的 3% 即与之相当。在 80B tokens 上进行通用持续预训练可将 15 项任务的平均结果提升 6.8%,自参考可在没有高质量参考数据的情况下带来最高 3.3% 的提升。
引言
大型语言模型通过扩大参数规模和数据规模来提升性能,但在所有可用 tokens 上训练并不总是最优,也不总是可行。现有数据过滤通常在文档级别进行,然而高质量语料库仍可能包含噪声、歧义或对齐较差的 tokens,这些 tokens 会增加无效的梯度更新并限制学习。已有工作还难以在移除 tokens 与保留含义和有用数据之间取得平衡。
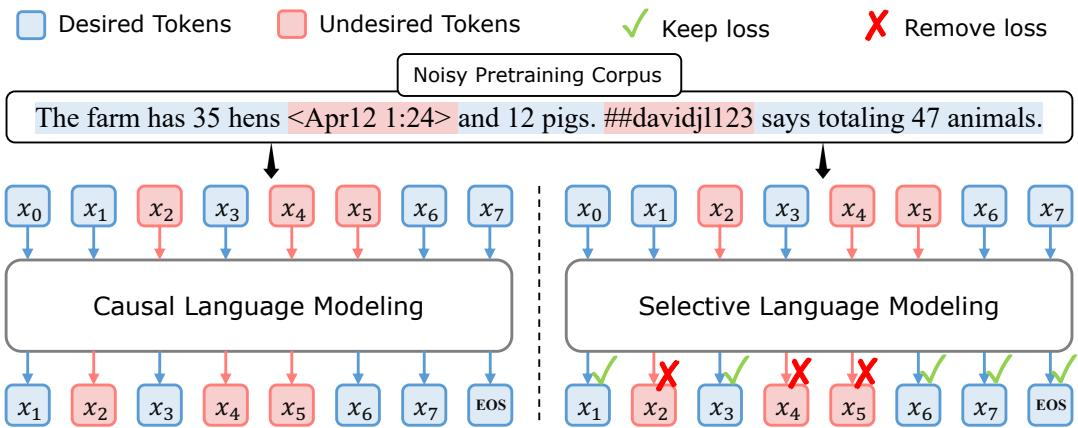
作者分析 token 级训练动态并表明,损失下降集中在信息量较高的一部分 tokens 上,而许多容易的 tokens 已经被学习,困难的 tokens 可能难以收敛。他们引入选择性语言建模(SLM),利用参考模型对 tokens 打分,然后仅对具有高超额损失的 tokens 进行训练,从而把更新聚焦于对下游任务最有帮助的 tokens。这种方法提升了 token 效率和性能,尤其是在数学持续预训练和通用持续预训练中。
方法
所提出方法围绕一个 token 级观察构建:在标准因果语言建模中,不同 tokens 对学习的贡献并不相等。作者首先考察预训练期间 token 级损失如何演化。他们在大规模语料上继续训练一个小语言模型,并在验证集上反复评估损失。请参考下图:
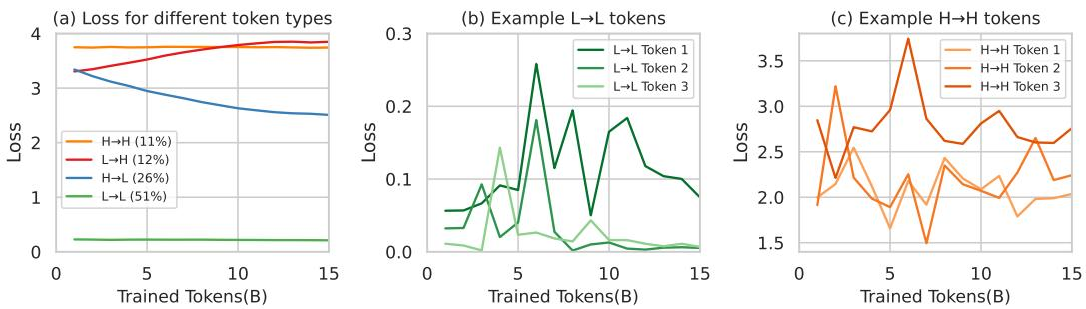
训练轨迹将 tokens 分成四类行为。一些 tokens 始终维持较低损失,表明它们已经被学习。另一些 tokens 从较高损失开始并显著降低,意味着它们仍能提供有意义的学习信号。数量较少的一组始终维持较高损失,这可能反映歧义或本身具有不确定性的内容。另一组最初损失较低,但在训练过程中上升,表明存在不稳定优化或噪声监督。此外,许多 tokens 表现出波动的损失而非平滑收敛,如果对所有 tokens 使用相等的训练权重,可能导致低效梯度更新。这促使设计一种选择性训练目标,强调具有更丰富可学习信号的 tokens,并抑制那些已经学习、无关或带噪声的 tokens。
为了落实这一洞见,作者提出选择性语言建模,这是一种三步训练流程,利用参考模型在语言模型预训练过程中指导 token 选择。框架图如下所示:
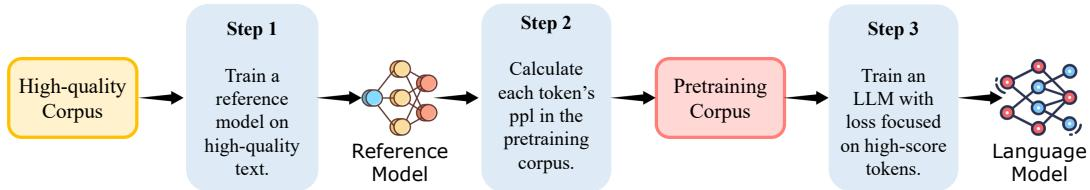
第一步是参考建模。参考模型在精选的高质量语料上训练,该语料代表期望的数据分布。这个参考模型充当打分模块,而不是最终部署模型。对于目标预训练语料中的每个 token xi,参考模型根据其在先前上下文 x<i 下为该 token 分配的概率计算参考损失:
LRM(xi)=−logP(xi∣x<i).这一参考损失刻画期望分布对该 token 的支持程度。较低参考损失通常表示 tokens 与高质量训练数据一致,而支持较差的 tokens 可能反映噪声、歧义或分布不匹配。
第二步是 token 打分。训练好的参考模型评估预训练语料中的每个 token,为整个训练数据生成参考损失分布。在实际预训练期间,训练模型也在参数 θ 下计算自身 token 级损失 Lθ(xi)。随后方法计算每个 token 的超额损失:
LΔ(xi)=Lθ(xi)−LRM(xi).该超额损失衡量当前训练模型预测与参考模型预期之间的差距。高超额损失 tokens 被视为更有用的学习目标,因为它们可能仍需适配,同时与参考分布相关。低超额损失 tokens 会被降权或排除,从而减少对已学习或缺乏信息 tokens 的不必要更新。
第三步是选择性预训练。模型不对所有 tokens 统一施加标准因果语言建模损失,而是只在高分数 tokens 的选定子集上优化交叉熵。给定一个长度为 N、选择比例为 k% 的 batch,选择性语言建模损失为:
LSLM(θ)=−N⋅k%1i=1∑NIk%(xi)logP(xi∣x<i;θ),其中指示函数为
Ik%(xi)={1,0,if xi ranks in the top k% by S(xi),otherwise.默认情况下,分数函数 S(xi) 为超额损失 LΔ(xi)。在实践中,每个 batch 中的 tokens 可按该分数排序,只有最高 k% tokens 对梯度有贡献。模型仍然处理完整输入序列,但对被认为收益较低的 tokens 掩蔽损失。该设计保留了自回归建模所需上下文,同时把优化努力集中在信息量最高的 token 目标上。
实验
实验通过在数学语料和通用语料上进行持续预训练来评估选择性语言建模,并与直接预训练基线及强公开模型在少样本推理、微调和广泛基准任务上进行比较。在数学训练中,该方法改进思维链和工具集成推理,同时展示高效数据使用以及对未见任务的一定迁移;在通用训练中,它也带来更广泛的基准增益,尤其是在代码和数学上。额外的自参考和消融研究验证了该方法能够在没有外部高质量数据的情况下选择信息量高的 tokens,所选 tokens 的损失能更好地跟踪下游性能,并且该方法主要保留相关且具有高学习价值的 tokens。
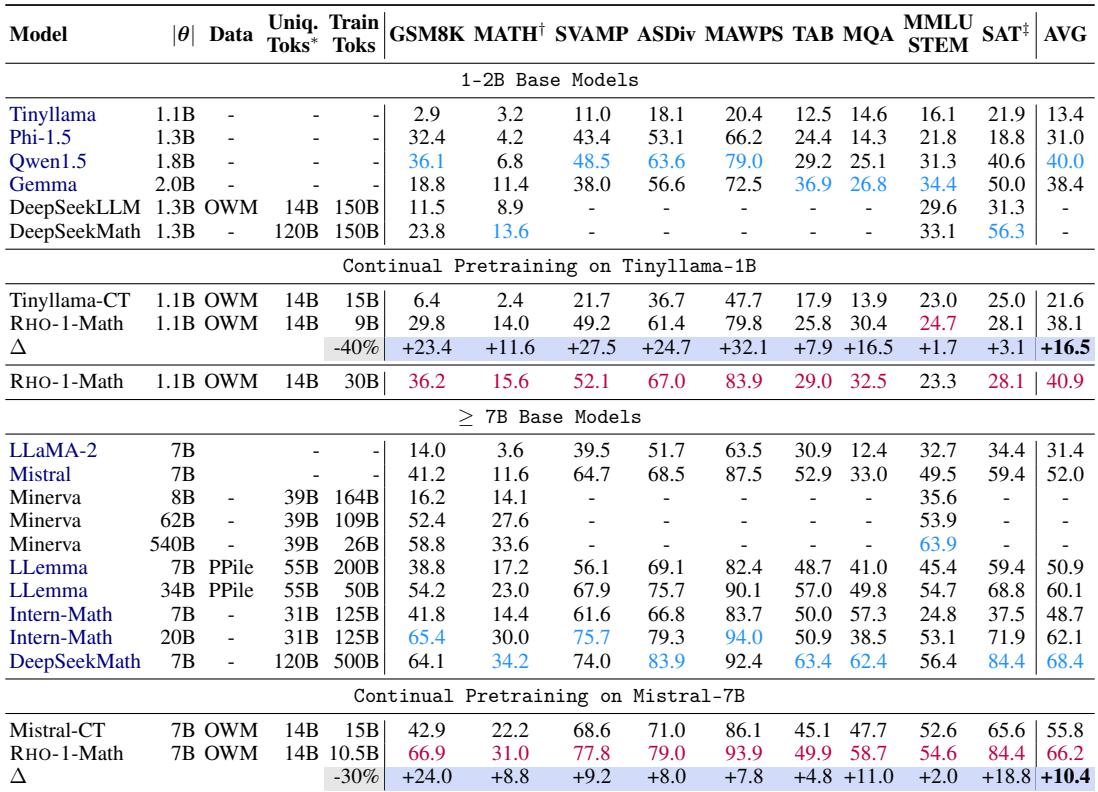
少样本思维链(CoT)评估显示,RHO-1-Math 相比直接持续预训练提升了数学推理准确率,在较小的 1B 模型上增益最明显。在 OpenWebMath 上增加训练轮数会进一步提高平均准确率。RHO-1-7B 在使用远少于其他基线的选定数学 tokens 的同时,达到可与更大 token 基线相当的性能。RHO-1-Math 相比直接持续预训练提升少样本 CoT 准确率,其中 1B 模型增益更强。在 OpenWebMath 上训练多个 epoch 会进一步提高平均性能。RHO-1-7B 在显著更小的选定 token 预算下达到与 DeepSeekMath-7B 相当的少样本结果。
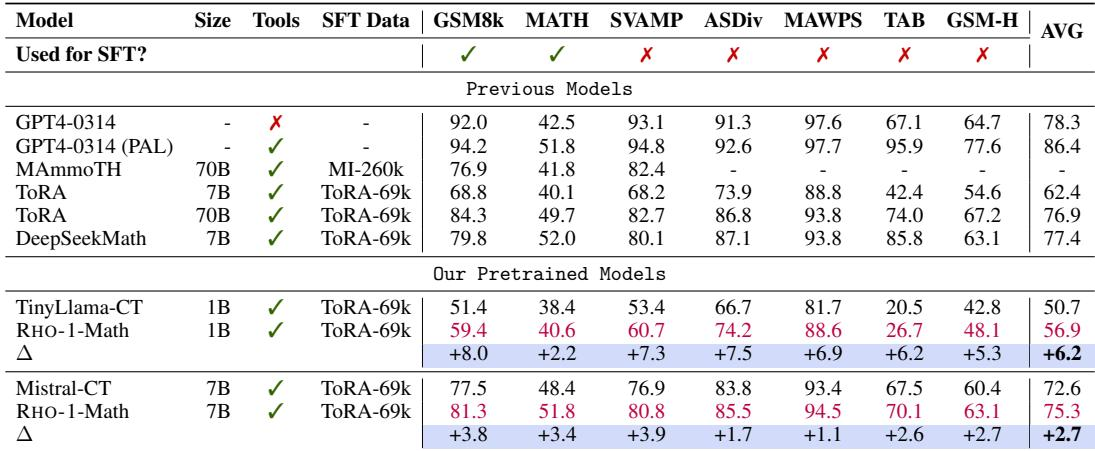
工具集成微调提升数学推理性能,RHO-1 模型在 1B 和 7B 规模上均实现较高 MATH 准确率。使用外部工具且具有更大参数规模的模型在所列数学任务上往往表现出更强的平均结果。RHO-1 也显示对未见数学任务的一定泛化能力,其中 1B 模型相比 7B 模型有更明显的相对增益。RHO-1 在小型和中型模型规模上均实现较强 MATH 准确率。工具使用和更大模型规模与更好的整体数学推理性能相关。
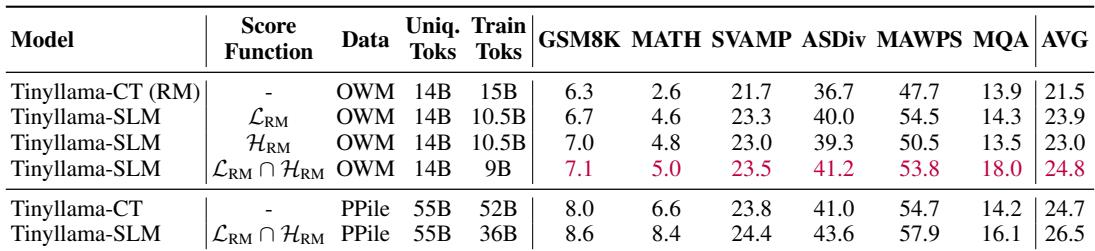
仅在 OpenWebMath 上训练的参考模型可以在同一语料上引导后续预训练,并在减少训练 tokens 的同时提升下游数学推理平均分。结合参考模型损失和 next token 熵进行 token 选择,相比仅使用其中一种分数带来更强提升;同一由 OWM 训练的参考模型也能用更少 tokens 提升 Proof-Pile-2 上的训练。由 OWM 训练的参考模型可在更少 token 训练下改进 OWM 预训练。仅使用熵评分带来的提升与参考模型损失相近。损失与熵选择交集可取得最佳 OWM 平均性能。由 OWM 训练的参考模型同样能以更少 tokens 改进 Proof-Pile-2 预训练。
实验通过少样本思维链推理、工具集成微调以及由参考模型引导的 token 选择来评估 RHO-1 的持续预训练。这些结果验证了以数学为重点的数据选择相比直接持续预训练能改进推理,并对较小模型带来更明显收益;工具使用和更大模型规模则进一步强化性能。同时,结果显示在 OpenWebMath 上训练的参考模型可以引导更有效的预训练,尤其是在结合损失与熵选择时;该方法在相关数学语料上仍然有用。