Command Palette
Search for a command to run...
生成对抗网络
生成对抗网络
Ian J. Goodfellow Jean Pouget-Abadie Mehdi Mirza Bing Xu David Warde-Farley Sherjil Ozair Aaron Courville Yoshua Bengio
摘要
我们提出了一种通过对抗过程估计生成模型的新框架。在该框架中,我们同时训练两个模型:一个捕捉数据分布的生成模型 G,以及一个估计样本来自训练数据而非 G 的概率的判别模型 D。G 的训练目标是最大化 D 犯错的概率。该框架对应于一个极小极大二人博弈。在由任意函数构成的 G 和 D 空间中,存在唯一解,其中 G 恢复训练数据分布,D 处处等于 1。当 G 和 D 由多层感知机构成时,整个系统可通过反向传播进行训练。在训练或生成样本的过程中,无需使用任何马尔可夫链或展开的近似推断网络。通过对生成样本进行定性和定量评估,实验展示了该框架的潜力。
一句话总结
蒙特利尔大学的研究人员提出生成对抗网络(Generative Adversarial Nets),这是一种通过极小极大二人博弈同时训练生成模型 G 和判别模型 D 的框架,能够在不使用马尔可夫链或近似推断网络的情况下估计数据分布。
核心贡献
- 该论文提出生成对抗网络,联合训练生成器 G 以捕获数据分布,并训练判别器 D 以估计样本来自训练数据还是来自 G。生成器的训练目标是最大化 D 将生成样本误分类的概率。
- 该方法将生成式建模表述为极小极大二人博弈,而不是基于似然的目标函数,其唯一解对应于 G 恢复训练分布且 D 处处等于 1。当 G 和 D 都是多层感知机时,整个系统可以通过反向传播训练,而无需在训练或样本生成期间使用马尔可夫链或展开的近似推断网络。
- 实验通过定性和定量评估生成样本,支持其学习生成模型的潜力。
引言
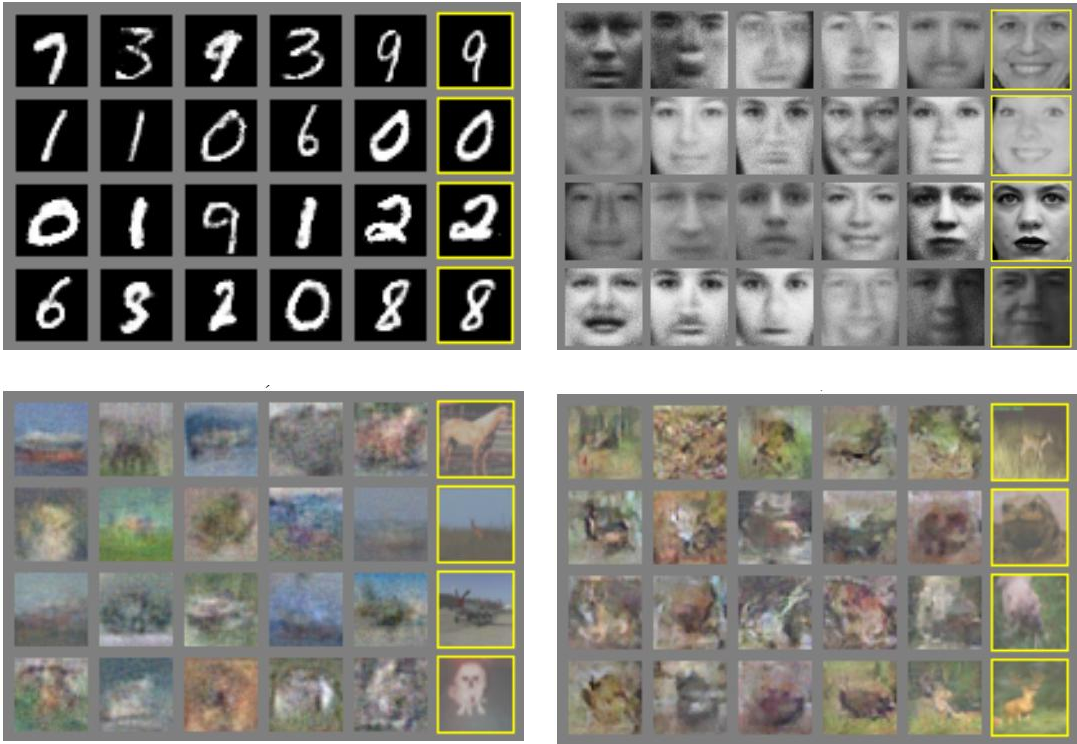
深度学习为判别任务产生了强模型,这类系统把图像或音频等复杂感知输入映射为标签,但生成建模发展滞后,因为它需要难以优化的复杂概率计算。早期方法常依赖不可处理的似然函数、近似推断、马尔可夫链或特殊密度估计,这使大型深度生成模型的训练不稳定或效率低下。作者利用一种对抗训练博弈,其中生成器产生样本,判别器学习将它们与真实数据区分开来。其主要贡献是一个框架,该框架使用标准反向传播和 dropout 训练两个网络,从而避免近似推断和马尔可夫链,同时实现可扩展的生成建模。
方法
对抗建模框架由两个可微多层感知机构成,二者通过二人极小极大优化进行训练。生成器 G(z;θg) 将噪声变量 z∼pz 映射到数据空间,从而隐式诱导模型分布 pg。判别器 D(x;θd) 输出一个标量分数,该分数可解释为输入 x 来自真实数据分布 pdata 而非来自生成器的概率。这两个组件的训练目标为:
GminDmaxV(D,G)=Ex∼pdata(x)[logD(x)]+Ez∼pz(z)[log(1−D(G(z)))].这里,D 被训练为最大化对真实样本和生成样本赋予正确标签的对数概率,而 G 被训练为通过最小化 log(1−D(G(z))) 来欺骗 D。等价地,生成器通过降低判别器对生成样本为假的置信度,把自己的样本分布推向更接近数据分布的区域。
优化过程可理解为从噪声到数据的映射与学习到的密度比估计器之间的耦合。参见框架图:
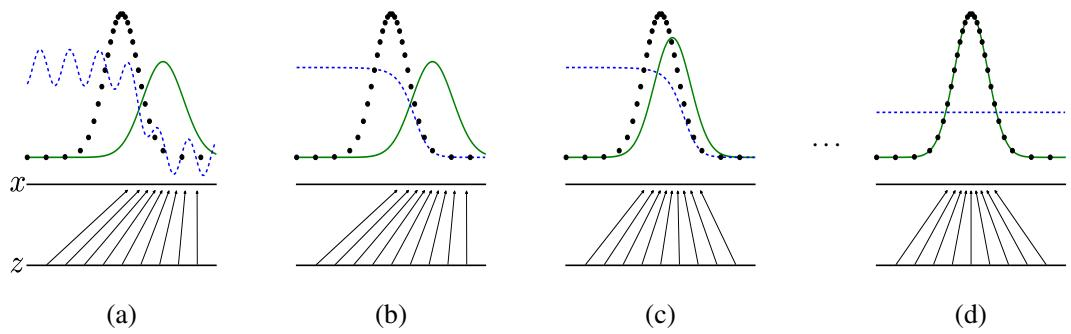
在这一视角下,来自简单噪声先验的样本经 G 变换为类数据样本。映射 G 在应获得更多概率质量的区域扩展,并在应获得更多概率质量之外的区域收缩。同时,D 自适应地分离生成分布 pg 与真实数据分布 pdata。随着训练推进,G 跟随 D 提供的梯度,把生成样本移向更可能被分类为真实的区域。
实践中,判别器不会在每次内部循环中完全优化到收敛。完全求解内部优化在计算上代价高昂,并可能导致在有限数据集上过拟合。相反,训练在 k 次判别器更新和一次生成器更新之间交替。这使 D 保持接近当前生成器对应的最优解,前提是 G 变化足够慢。因此更新调度是耦合的:生成器依赖来自 D 的信息性梯度,而 D 必须跟踪生成样本分布的变化。
标准极小极大公式中的目标在早期训练可能较弱。当 G 较差时,D 能以很高置信度拒绝生成样本,导致项 log(1−D(G(z))) 饱和,并为生成器产生很小梯度。为避免这种情况,作者把生成器目标修改为最大化 logD(G(z))。修订后的损失在 G 和 D 的联合动力学下具有相同的不动点,但在训练早期提供更强的梯度信号。
理论分析解释了为什么这个对抗目标瞄准数据分布。对于固定的生成器,最优判别器具有闭式解:
DG∗(x)=pdata(x)+pg(x)pdata(x).这意味着 D 实际上估计了样本来自真实数据与生成数据的后验概率。将该最优判别器代回目标后,得到可由 pdata 和 pg 之间的 Jensen-Shannon 散度表达的量:
C(G)=−log(4)+2JSD(pdata∥pg).由于 Jensen-Shannon 散度非负,且仅当两个分布相匹配时为零,理想化目标的全局最优出现在 pg=pdata 时。在非参数设定下,这解释了当模型类具有足够容量且更新以受控方式进行时,该方法为何能够恢复数据生成分布。
实际上,该方法不需要 pg 的显式密度模型、马尔可夫链采样,也不需要在学习过程中进行推断。梯度通过经过判别器的反向传播获得,这使 G 和 D 都能使用灵活的可微组件。主要训练设计选择是两个网络之间的同步:D 必须在 G 变化时保持接近最优,而 G 必须避免过快坍缩到有限的生成样本子集。
实验
评估结合了理论分析与基于图像的实验。理论验证了当生成器与数据分布相匹配时,极小极大目标具有全局最优,并且在强假设下,理想化的优化过程可以收敛到该最优。实验上,在图像数据集上训练的对抗网络产生的样本被认为具有竞争力,这表明尽管似然估计具有近似性,该框架仍能学习有用的生成行为。
结果使用基于 Parzen 窗口的程序比较多个生成模型在 MNIST 和 TFD 上的估计对数似然。对抗网络在 MNIST 上取得最佳估计表现,并在 TFD 上保持竞争力,其中 stacked CAE 给出最强的报告估计。该比较表明,尽管评估方法被认为方差较高,对抗训练产生的样本在估计似然上至少与现有生成模型具有竞争力。对抗网络在所比较模型中取得最高估计 MNIST 对数似然。在 TFD 上,对抗网络的表现接近最佳模型,而 stacked CAE 给出最强报告估计。似然值使用 Parzen 窗口估计,该程序被认为方差较高,且在高维空间中可靠性有限。
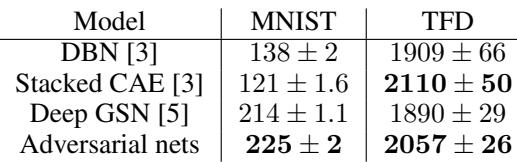
实验使用基于 Parzen 窗口的程序估计对数似然,在 MNIST 和 TFD 上评估多个生成模型。结果表明,对抗网络在 MNIST 上取得最强估计似然,并在 TFD 上保持竞争力,其中 stacked CAE 获得最佳报告估计。总体而言,对抗训练产生的样本具有与现有生成模型相当的似然估计,尽管评估受到高方差和有限可靠性的影响。