Command Palette
Search for a command to run...
基于神经网络的序列到序列学习
基于神经网络的序列到序列学习
Ilya Sutskever Oriol Vinyals Quoc V. Le
摘要
深度神经网络(DNN)是强大的模型,已在困难的学习任务上取得了优异的性能。尽管在有大规模标注训练集时 DNN 表现良好,但它们无法用于序列到序列的映射。本文提出了一种通用的端到端序列学习方法,对序列结构的假设极少。该方法使用多层长短期记忆网络(LSTM)将输入序列映射为固定维度的向量,然后使用另一个深度 LSTM 从该向量解码目标序列。主要结果是:在 WMT-14 数据集的英法翻译任务上,LSTM 生成的翻译在整个测试集上取得了 34.8 的 BLEU 分数,其中 LSTM 的 BLEU 分数在词表外单词上受到了惩罚。此外,LSTM 在处理长句时没有遇到困难。作为对比,基于短语的统计机器翻译(SMT)系统在同一数据集上取得了 33.3 的 BLEU 分数。当我们使用 LSTM 对上述 SMT 系统生成的 1000 条候选翻译进行重排序时,BLEU 分数提升至 36.5,接近此前的最优水平。LSTM 还学习到了合理的短语和句子表示,这些表示对词序敏感,且对主动语态和被动语态具有相对的不变性。最后,我们发现将所有源句中的词序反转(但不反转目标句)可以显著提高 LSTM 的性能,因为这样做在源句和目标句之间引入了许多短期依赖关系,从而使优化问题更容易求解。
一句话总结
谷歌的研究人员提出了一种通用的端到端序列到序列模型,该模型使用深度 LSTM 编码器-解码器,通过固定维度向量将输入序列映射到目标序列,在英法翻译上取得了 34.8 的 BLEU 分数,超过了基于短语的统计机器翻译,并发现反转源语言词序会引入短期依赖,从而便于优化。
核心贡献
- 这篇论文提出了一种用于序列学习的端到端编码器-解码器方法,该方法使用多层长短期记忆(LSTM)网络将输入序列映射为固定维度向量,并使用深度 LSTM 解码目标序列,同时对序列结构做出很少假设。
- 在 WMT’14 英法翻译任务上,LSTM 系统在全测试集上取得 34.8 BLEU(对未登录词进行惩罚),超过基于短语的统计机器翻译基线(BLEU 33.3)。通过对该基线输出的 1000 条候选进行重排序,BLEU 提升至 36.5。
- 在保持目标语言句子不变的情况下,反转源语言句子的词序显著提升了 LSTM 性能,因为它在源语言句子和目标语言句子之间引入了短期依赖。定性评估表明,学习到的表示对词序敏感,对主动语态和被动语态相对不变,并且能够翻译长句。
引言
深度神经网络在语音和视觉等任务上表现出色,因为它们能够学习复杂的固定大小映射;然而,许多重要问题(包括机器翻译和问答)都涉及长度未知的输入和输出序列。这种长度可变性使标准 DNN 的应用变得困难,早期神经方法往往难以处理长序列、依赖特殊的对齐假设,或者需要辅助现有统计翻译系统,而不是直接进行翻译。作者利用长短期记忆编码器和解码器:一个 LSTM 读取源序列并编码为固定向量,另一个 LSTM 根据该向量生成目标序列。作者还表明,反转源语言词序会引入更强的短期依赖,使训练更容易,并提升长句性能。这种简单的序列到序列方法使大型 LSTM 模型能够在英法直接翻译上取得很强结果,并超越成熟的基于短语的统计机器翻译基线。
数据集
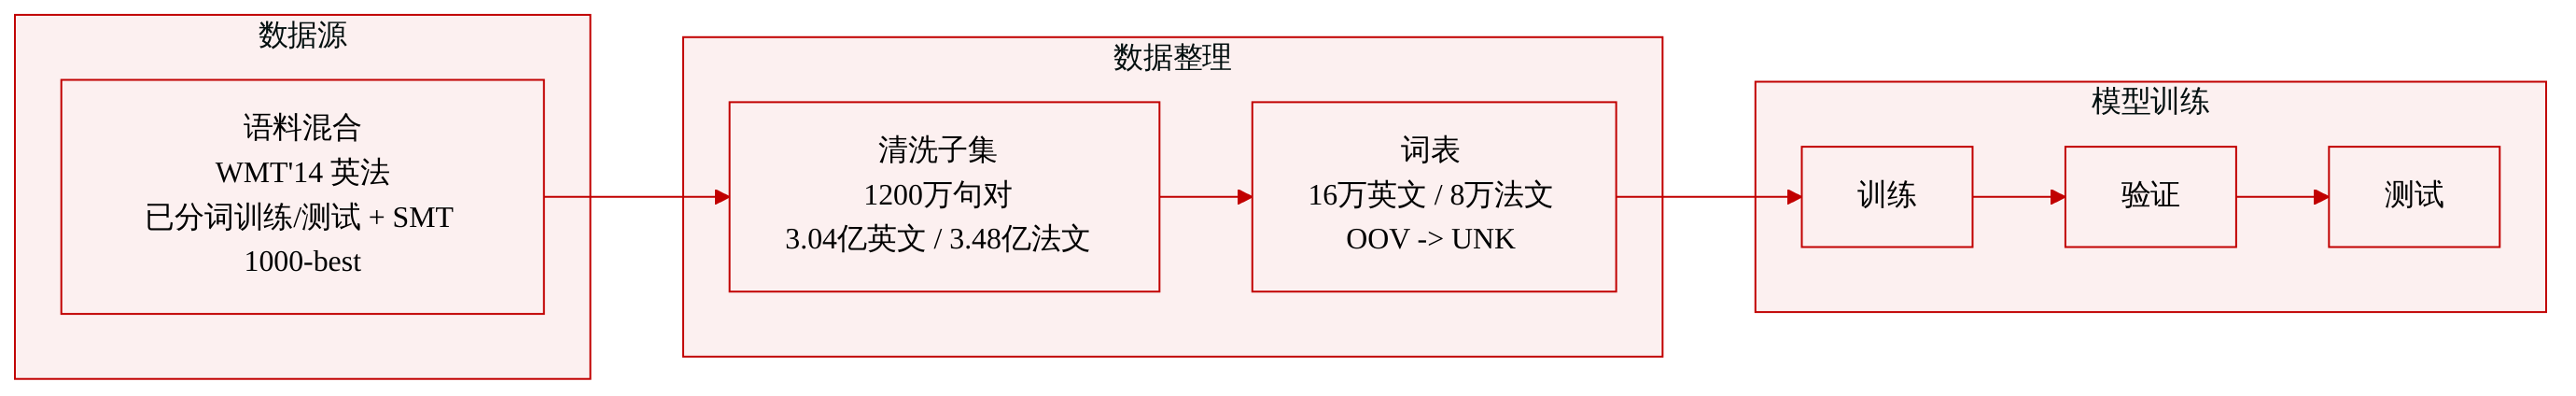
- 作者使用 WMT’14 英法机器翻译数据集。
- 训练使用经过清理的“selected”子集,其中包含 1200 万个句子对。
- 训练子集包含 3.48 亿个法语单词和 3.04 亿个英语单词。
- 选择该子集的原因是分词后的训练集和测试集公开发布,并包含来自基线 SMT 系统的 1000-best 列表。
- 处理过程中,两种语言均使用固定词表。
- 源语言英语词表包含出现频率最高的 160,000 个单词。
- 目标语言法语词表包含出现频率最高的 80,000 个单词。
- 所有未登录词均替换为特殊 “UNK” token。
方法
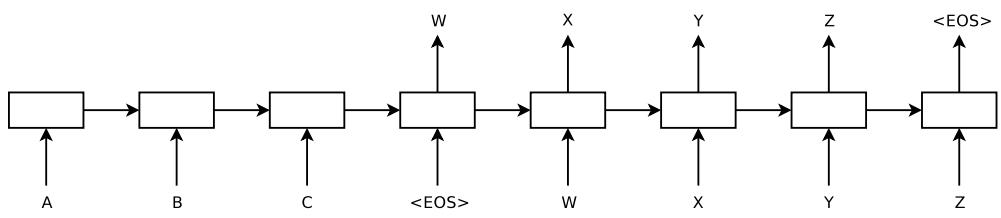
作者利用由长短期记忆网络构成的序列到序列编码器-解码器架构。模型接收输入序列 x1,…,xT,并产生输出序列 y1,…,yT′,两个序列可以具有不同长度,二者之间的映射也不必是单调的。该架构不要求预先建立输入与输出的一一对应关系,而是先将源序列压缩为固定大小向量,再使用该向量对语言模型进行条件化,从而逐词生成目标序列。
编码器一次处理一个时间步的输入序列,并输出一个隐状态作为摘要表示。解码器使用该表示初始化,并自回归地预测目标序列。在这项工作中,作者将编码器和解码器划分为两个独立的 LSTM 堆叠,从而在几乎不增加计算成本的情况下提升模型容量,并且更自然地支持在多个语言对上训练。每个输出分布都通过目标词表上的 softmax 建模,模型可以通过特殊的 end of sequence token 生成可变长度序列。
系统建模的条件概率写作
p(y1,…,yT′∣x1,…,xT)=t=1∏T′p(yt∣v,y1,…,yt−1),其中 v 是编码器产生的输入序列固定维度表示。下面的框架示意图展示了从源词到目标词以及最终停止 token 的整体流程。
反转源序列是训练和推理期间的一个关键设计选择。模型不是直接将源句映射到目标句,而是将反转后的源句映射到目标句。这缩小了相关源词和目标词之间的最小时间滞后,因为反转后源句的开头部分更靠近目标序列的开头。作者认为,这会引入许多短期依赖,使优化更容易,并有助于反向传播在编码器和解码器之间建立通信。
部署模型使用深度 LSTM 堆叠。编码器和解码器都是多层 LSTM,最终配置中各有四层。每层包含 1000 个单元,输入词嵌入为 1000 维。作者对源语言和目标语言使用不同词表,解码器通过在输出词表上施加朴素 softmax 来产生预测。参数量较大主要由于两个 LSTM 堆叠内部的循环连接。
训练最大化给定源序列时正确目标序列的对数概率。目标函数为
∣S∣1(T,S)∈S∑logp(T∣S),其中 S 是训练集,p(T∣S) 按上文所示分解计算。参数从均匀分布初始化。作者使用不带动量的随机梯度下降,初始学习率固定。学习率会在后期 epoch 期间定期降低,训练只进行有限数量的 epoch。小批次包含 128 个序列,计算得到的梯度会除以批次大小。为避免梯度爆炸,当梯度范数超过阈值时会进行裁剪。小批次内的句子也按相近长度分组,这减少了因句长差异较大而造成的无效计算。
为提升训练效率,系统在多个 GPU 上并行化。每个 LSTM 层可以放在单独的 GPU 上,激活值一旦计算完成就传递给下一层。softmax 计算也分布在额外 GPU 上,使大型输出投影能够更高效地处理。这种设计使得使用批量训练在大规模句对上训练非常大的深度 LSTM 成为可能。
在推理阶段,翻译结果通过搜索最可能的目标序列生成:
T^=argTmaxp(T∣S).作者实现了一个简单的从左到右 beam search 解码器。beam 维护 B 个部分假设,每个假设代表某个可能翻译的前缀。在每个解码步骤中,每个假设都会扩展候选目标词,并且只根据模型对数概率保留最可能的 B 个假设。当生成 end of sequence token 时,该假设从 beam 中移除,并存储为完整翻译。作者发现即使很小的 beam 大小也能取得较好效果,他们还使用 LSTM 对基线 n-best 列表进行重打分,方法是将基线假设分数与 LSTM 对数概率取平均。
实验
实验在 WMT’14 英法翻译任务上评估深度 LSTM 翻译系统,同时使用直接 beam search 翻译和对 SMT n-best 列表重打分。实验验证反转源句、增加模型深度以及使用 LSTM 集成能够显著提升翻译质量,而多 GPU 训练使大型模型得以可行。总体而言,结果表明纯神经翻译系统可以超过 SMT 基线并接近强系统,在长句上仍然有效,并学习到了对词序和语义敏感的表示。
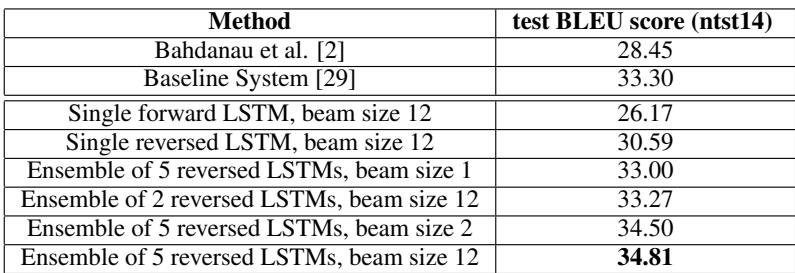
结果比较了 LSTM 模型在 ntst14 测试集上的英法翻译,使用 cased BLEU 分数。反转 LSTM 优于单个前向 LSTM,反转 LSTM 的集成给出了最强的纯 LSTM 分数。报告指出,小 beam 集成的成本低于用大得多的 beam 解码的单个模型。反转 LSTM 优于单个前向 LSTM。由五个反转 LSTM 组成、使用小 beam 的集成达到报告中的最佳纯 LSTM 分数。该集成系统接近基于短语的基线分数。
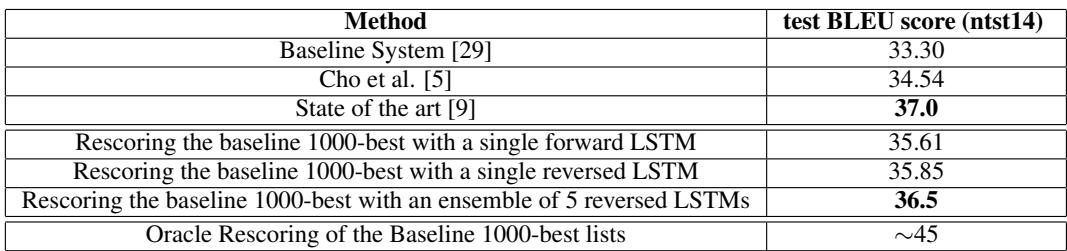
结果表明,基于 LSTM 的方法在英法测试集上优于基于短语的 SMT 基线,最大提升来自对基线 1000-best 翻译进行重打分。五个模型的集成达到最接近先前最优系统的表现,而 oracle 重打分表明基线候选列表仍有很大潜力。将神经网络与 SMT 系统结合的 LSTM 模型明显优于基线。使用反转 LSTM 集成对基线 1000-best 列表重打分后,结果非常接近先前最优系统。oracle 重打分表明,许多最佳翻译已经存在于基线候选列表中。
这些示例表明,LSTM 能够生成长句且基本合理的翻译,同时保留主要意思。输出有时会重排分句并改写细节,并且可能会用 unknown token 替换未知词或名称。整体上,这些翻译与真实参考在含义上接近,差异主要在于措辞和结构。长例句翻译通常能够传达源句的意图。部分输出会对专有名词或罕见术语使用 unknown token。这些翻译保留了整体主题,但在分句顺序和措辞上与真实参考不同。
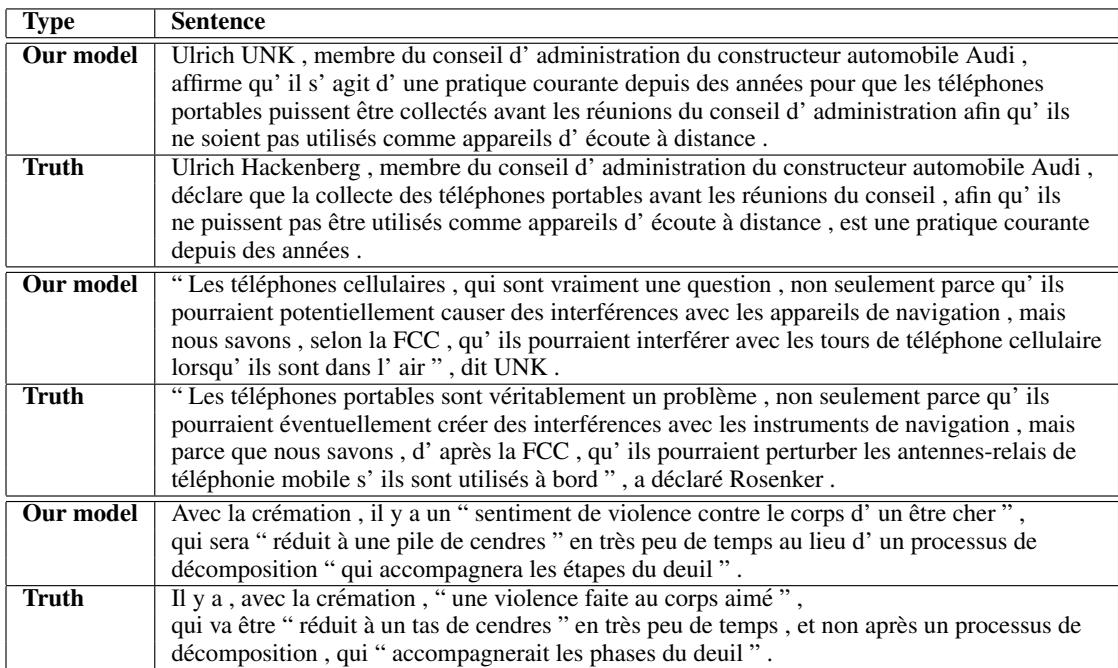
实验在 ntst14 测试集上评估英法翻译,结果显示反转 LSTM 架构和集成优于单个前向 LSTM,并接近基于短语的基线。对基于短语的 1000-best 列表进行混合 LSTM 重打分进一步超过基线,并接近先前最优系统性能;oracle 重打分表明仍有很大潜力。定性示例表明,长句翻译保留了主要内容和整体含义,尽管在分句顺序、措辞以及对罕见名称或术语使用 unknown token 方面存在差异。