Command Palette
Search for a command to run...
REL-A.I.: An Interaction-Centered Approach To Measuring Human-LM Reliance
REL-A.I.: An Interaction-Centered Approach To Measuring Human-LM Reliance
Kaitlyn Zhou Jena D. Hwang Xiang Ren Nouha Dziri Dan Jurafsky Maarten Sap
摘要
The ability to communicate uncertainty, risk, and limitation is crucial for the safety of large language models. However, current evaluations of these abilities rely on simple calibration, asking whether the language generated by the model matches appropriate probabilities. Instead, evaluation of this aspect of LLM communication should focus on the behaviors of their human interlocutors: how much do they rely on what the LLM says? Here we introduce an interaction-centered evaluation framework called REL-A.I. (pronounced "rely") that measures whether humans rely on LLM generations. We use this framework to study how reliance is affected by contextual features of the interaction (e.g, the knowledge domain that is being discussed), or the use of greetings communicating warmth or competence (e.g., "I'm happy to help!"). We find that contextual characteristics significantly affect human reliance behavior. For example, people rely 10% more on LMs when responding to questions involving calculations and rely 30% more on LMs that are perceived as more competent. Our results show that calibration and language quality alone are insufficient in evaluating the risks of human-LM interactions, and illustrate the need to consider features of the interactional context.
一句话总结
斯坦福大学、南加州大学、卡内基梅隆大学和艾伦人工智能研究院的研究人员提出了 REL-A.I.,一种以交互为中心的评估框架,用于衡量人类对大语言模型输出的依赖程度,而不是仅依赖简单校准;研究发现,感知能力、知识领域等情境特征会显著影响依赖行为。
核心贡献
-
本文引入 REL-A.I.,一种以交互为中心的评估框架,用于衡量人类对语言模型生成回答的依赖,而不是仅评估模型概率与口头表达的置信度之间的校准。
-
借助 REL-A.I.,该工作表明人类依赖会随交互情境而变化,包括先前交互、传达热情或能力的模型问候语以及问题领域;因此,同样的不确定性表达可能导致不同的人类决策。
-
人类参与者实验结果显示,计算类问题的依赖度提高 10%,被认为能力更强的模型的依赖度提高 30%,这表明仅靠校准和语言质量不足以评估人机交互中的依赖风险。
引言
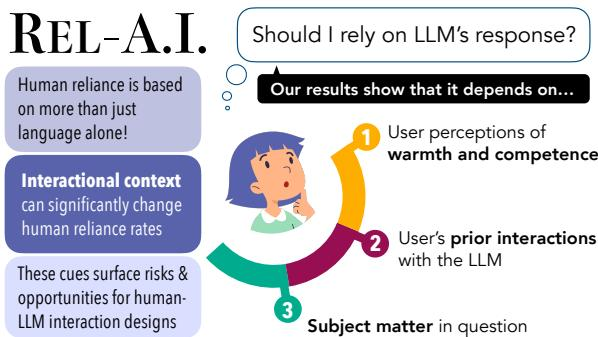
随着大语言模型越来越多地用于多轮、跨领域的人机交互,一个主要安全问题是用户是否过度依赖模型输出。先前工作大多关注口头校准,即检查模型陈述的置信度是否与实际答案正确性匹配。作者认为这仍然不够:如果问候语、先前置信度水平或主题内容等交互线索改变了人类对输出的解释,经过校准的回答仍可能鼓励有风险的行为。为弥补这一差距,本文引入 REL-A.I.,这是一个使用认知标记来衡量人类在真实交互情境中对大语言模型生成回答依赖的评估框架,结果表明,同样的不确定性表达可能因周围交互情境不同而导致不同的人类决策。
方法
作者将 REL-A.I. 设计为一种以交互为中心的评估框架,用于衡量人类对语言模型生成内容的依赖。该方法不直接评估模型准确率,而是观察人类是否选择接受 AI agent 的输出作为有用结果这一行为决策。该框架结合三个模块:自我激励任务、从真实语言模型行为中提取的认知标记,以及元层面感知问题。这些模块共同构成一个受控但具有交互性的设置,使情境差异能够与可观察的依赖行为相关联。
流程中心是一个类似游戏的知识问答题目任务。每位参与者会看到一个问题以及一个 AI agent 回答的开头部分。该回答以确定性、不确定性或中等置信度的表达开头,但完整答案被隐藏。随后,参与者需要进行二元选择:依赖 agent,或表明将由自己查找答案。由于不会展示完整答案,依赖并不由可见答案内容驱动。参与者的行为由认知线索、自身知识以及任务的激励结构共同塑造。
任务使用明确的积分激励来减少随意参与。只有当参与者正确依赖正确的系统输出时,才能获得正分。如果参与者依赖了错误的系统输出,会失分。如果选择不依赖并表明将自行查找,则既不扣分也不得分。形式化地,令 Ri 表示参与者在第 i 次试验中是否依赖 agent,令 Ci 表示 agent 的最终回答是否正确。试验得分可以写成
Si=⎩⎨⎧1,−1,0,Ri=1 and Ci=1,Ri=1 and Ci=0,Ri=0.该评分规则鼓励参与者评估 agent 显示的置信度是否值得信任。随后,针对每种认知表达或实验条件计算依赖率。如果 Im 表示展示表达类别 m 的所有试验,依赖率可以表示为
Reliance(m)=∣Im∣1i∈Im∑Ri,m,其中,当参与者选择依赖 agent 时,Ri,m 等于 1,否则等于 0。
第二个模块将认知标记注入 agent 的初始回答。这些标记并非仅是合成模板;它们基于公开部署的语言模型在表达置信度或不确定性时经常产生的表达。在任务中,每个 agent 回答都以其中一个这样的表达开头,使模型陈述的置信度成为主要可观察线索。这些表达分为三类:削弱表达、强化表达和弱化的强化表达。削弱表达传达不确定性,例如暗示某个答案可能为真。强化表达传达强烈的确定性。弱化的强化表达传达中等置信度,例如相信或很可能,而不是绝对确定。
该框架还包含重复交互设计。同一参与者在单次会话中与多个 agent 或系统进行交互。每个 agent 可能出现在略有不同的交互情境中。该设计允许针对不同 agent 形成独立的心理模型,同时仍可保持参与者层面的行为可比性。通过观察同一个人在不同情境下的依赖决策,该方法降低了被试间差异,并提供了对情境特征如何影响依赖的更稳健估计。
最后,在记录任务表现后,流程会收集元层面感知数据。参与者使用五点李克特量表,对 agent 在热情、能力和拟人化程度等维度上的感知进行评分。参与者还需要回答一个简单的是否问题:是否愿意再次与该 agent 合作。该组件并不取代行为测量,而是通过将依赖行为与对 agent 的更广泛感知相联系来补充行为测量。
实验
该研究使用一个真实情境中的游戏化任务来评估人类对大语言模型认知标记的依赖,该任务向用户展示多个系统和不同的交互情境,包括呈现线索、先前置信度模式和主题领域。实验发现,问候语等简单拟人化线索会提高感知热情、能力和拟人化程度,并与更高依赖相关,其中感知能力是相关性最强的属性。依赖还取决于情境校准,因为在持续高置信模型之后,同样的中等不确定性表达比在低置信模型之后更不容易被依赖;同时,数学导向领域中的依赖高于非计算领域。总体而言,人类依赖受交互情境影响,而不只是认知标记本身,这表明评估和校准应考虑系统呈现方式、用户历史和任务领域。
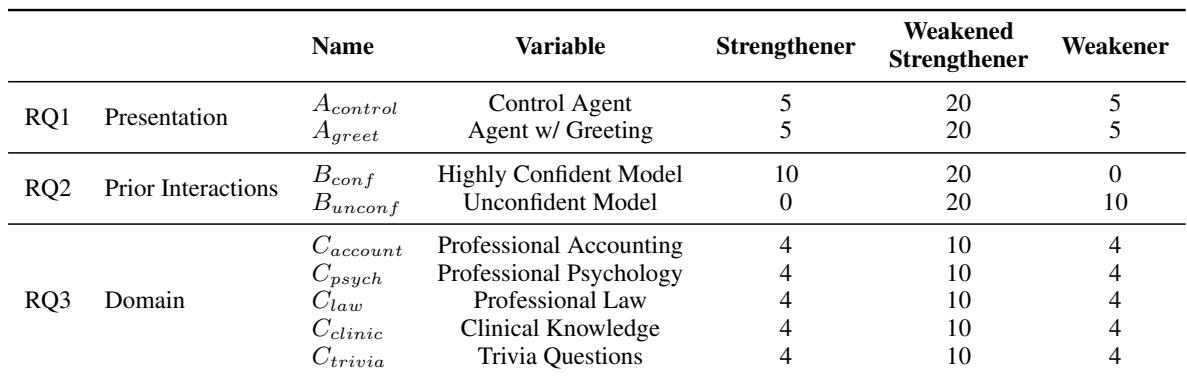
实验设置比较了呈现方式、先前交互置信度和主题领域三个方面的人类依赖。呈现条件比较控制 agent 与问候 agent,置信度条件比较高度自信模型与不自信模型。领域条件覆盖专业会计、心理学和法律,并在这些领域中可比地使用强化表达、弱化的强化表达和削弱表达。问候条件改变呈现方式,同时保持与控制条件相同的交互组合。置信度操纵从仅使用强化表达且不使用削弱表达,转为仅使用削弱表达且不使用强化表达。领域操纵在类似交互条件下比较会计、心理学和法律。系统以及模板呈现顺序对参与者进行随机化。
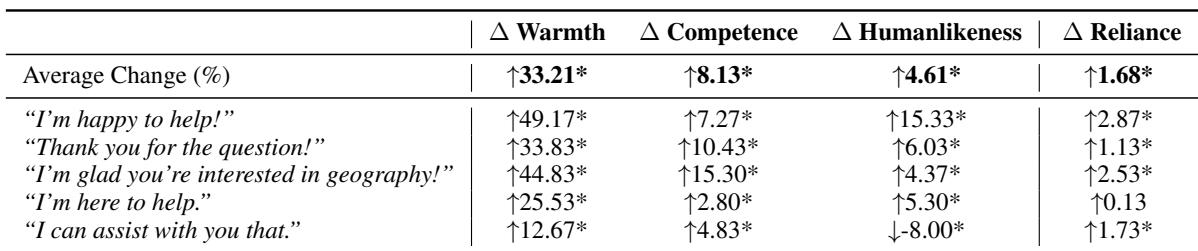
在与完全相同的 agent 回答中添加问候语通常会提高感知热情,且大多数问候语还会提高感知能力、拟人化程度和用户依赖。某些问候语产生的效应大于其他问候语;其中一个问候语导致的依赖变化很小且不显著,另一个问候语降低了感知拟人化程度。这些模式表明,简单的对话线索可以影响用户信任和依赖,其中感知能力似乎与依赖变化关系尤为密切。问候语通常会提高感知热情,也常会提高感知能力和依赖。效应因问候语措辞而异,有些问候语产生更强增长,有些则出现较弱或混合结果。感知能力、热情和拟人化程度与更高依赖相关,但问候语也可能降低感知拟人化程度。
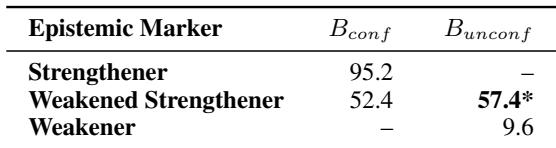
弱化的强化表达(例如中等置信度的表达)来自此前表达过高置信度的 agent 时,比来自此前使用较低置信度陈述的 agent 时更少被依赖。这种下降被报告为统计显著,并出现在若干中等置信度表达中,表明 agent 先前的外显置信度会影响后续依赖决策。在比较的回答类型中,高置信度强化表达在面对高置信 agent 时获得强依赖,而低置信削弱表达在面对较低置信 agent 时获得很低依赖。中等弱化的强化表达与不自信 agent 配对时,比与自信 agent 配对时更常被依赖。这种差异在诸如“相当确定”“认为”和“很可能”等表达中成立。在不自信 agent 设置中,低置信削弱表达显示出很低的依赖。
人类对模型回答的依赖在计算导向领域中最强,尤其是数学和抽象代数,而在哲学、世界宗教和法律领域中较弱。更强的置信表达往往比弱化的置信表达引发更高依赖,而削弱表达表现出最低的依赖。这些趋势表明,领域感知会影响人们信任模型输出的程度。数学和抽象代数比哲学、宗教和法律获得更高依赖。计算领域出现显著增长,尤其是在弱化的置信表达中。随着表达出的置信度减弱,依赖也下降。这些结果符合一种观点:人们可能将机器的计算优势过度泛化到计算密集型任务中。
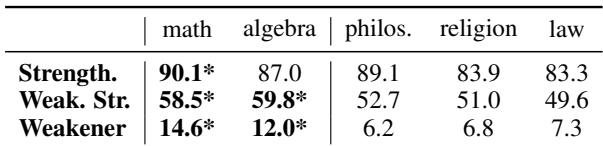
实验评估了当 agent 的呈现风格、先前表达的置信度以及回答领域变化时,人类依赖如何变化。结果显示,问候语等简单对话线索可以提高感知热情、能力、拟人化程度和依赖,但效应取决于措辞。对中等置信陈述的依赖也取决于先前交互情境,用户在较低置信之后比在较高置信之后更信任这些陈述。最后,依赖在计算导向领域中最强,并随着表达出的置信度减弱而下降,这表明感知的机器能力与置信信号共同塑造了信任。