Command Palette
Search for a command to run...
大语言模型在文学翻译中究竟有多好?——基于人类与大语言模型的文学翻译评估
大语言模型在文学翻译中究竟有多好?——基于人类与大语言模型的文学翻译评估
Ran Zhang Wei Zhao Steffen Eger
摘要
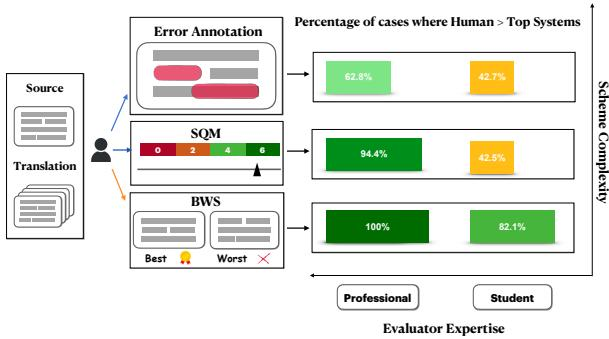
近年来,文学机器翻译(MT)被视为机器翻译领域的一项新挑战。然而,文学机器翻译的评估仍然是一个开放性问题。我们对这一持续讨论做出贡献,推出了 LITEVAL-CORPUS,这是一个段落级平行语料库,包含经过验证的人工译文和来自 9 个机器翻译系统的输出,总计超过 2k 条译文和 13k 个已评估句子,涵盖四个语言对,花费 4.5k。该语料库使我们能够:(i) 考察不同复杂度等级的人工评估方案的一致性和充分性;(ii) 比较学生评估者与专业评估者的评估结果;(iii) 评估基于大语言模型的指标的有效性;(iv) 评估大语言模型本身的有效性。我们的研究结果表明,人工评估的充分性受两个因素控制:评估方案的复杂度(越复杂越不充分)和评估者的专业水平(专业水平越高,评估越充分)。例如,MQM(多维质量指标)是复杂评估方案且是非文学人工机器翻译评估的事实标准,但在文学翻译评估中基本不充分:使用学生评估者时,近 60% 的人工译文被错误地判定为与机器翻译无法区分或劣于机器翻译。相比之下,BWS(最佳-最差标度法)是一种简单得多的方案,能够以 80-100% 的准确率识别出人工译文。自动指标的表现则远为糟糕,准确率最高仅为 20%。我们的综合评估表明,已发表的人工译文始终优于大语言模型译文,即使是大语言模型中最先进的,也往往产生比人工译文更直译、更缺乏多样性的翻译。
一句话总结
来自曼海姆大学、阿伯丁大学和纽伦堡工业大学的研究者介绍 LITEVAL-CORPUS,13$k$-sentence parallel corpus for literary translation evaluation across four language pairs, finding that simpler schemes like BWS identify human translations at 80–100%whilethecomplexMQMstandardmisjudgesnearly60%$$ 被视为无法区分或更差,并且 LLM 生成的翻译比人工翻译更直译且更缺乏多样性。
核心贡献
- LITEVAL-CORPUS 被介绍为面向文学机器翻译评估的段落级平行语料库,包含经过验证的已发表人工翻译和九个机器翻译系统输出,覆盖四个语言方向,共超过 2,000 条翻译和 13,000 条被评估句子。
- 论文对人工评估方案和评估者专业水平进行了系统比较,包括多维质量指标(MQM)和最佳-最差标度(BWS),并评估基于 LLM 的指标以及 LLM 生成翻译在文学文本中的一致性和充分性。
- 结果显示,BWS 以百分之 80 到百分之 100 的识别率识别出人工翻译,而使用学生评估者的 MQM 将近百分之 60 的人工翻译误判为与机器翻译无法区分或不如机器翻译;已发表的人工翻译持续优于 LLM 翻译,后者往往更直译且更缺乏多样性。
引言
随着大型语言模型在文学翻译能力上不断提升,研究者正在考察这些系统能否保留作者声音、文化细微差别和审美质量,尤其是在低资源语言中。文学翻译比普通机器翻译更难评估,因为语言准确性只是一个维度,判断还必须考虑创造性和目标语言可接受性。已有自动指标区分高质量人工文学翻译与直译模型输出的能力有限,而 MQM、SQM 和 BWS 等人工评估框架尚未在文学文本上进行系统比较;现有数据集规模较小、覆盖系统较少,且通常缺少经过验证的专业人工翻译。研究者通过发布 LITEVAL CORPUS 解决这些空白,这是一个经过验证的段落级平行语料库,覆盖四个语言方向并包含九个翻译系统;同时通过比较人工评估方案和基于现代大型语言模型的指标,来展示哪些方法最能识别人工翻译质量,并揭示近期模型仍会产生更直译且更缺乏多样性的文学翻译。
数据集
数据集:LITEVAL-CORPUS
-
研究者提出 LITEVAL-CORPUS,这是一个覆盖英语、中文和德语的段落级文学翻译评估数据集。它涵盖四个语言方向:英语到中文、德语到英语、英语到德语和德语到中文。
-
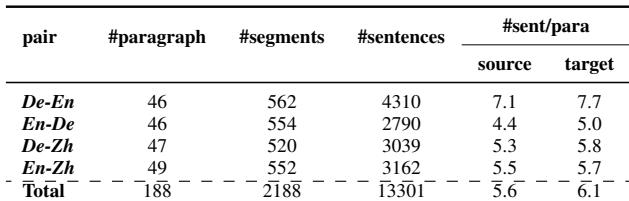
该语料库包含 188 个源段落、2,188 个段落级翻译片段以及超过 13k 个句子。源段落平均包含 5.6 个句子,而目标段落平均包含 6.1 个句子。
-
源段落和目标段落来自经过验证的出版物,包括 Project Gutenberg 书籍、已发表的阅读样本以及购买的材料。该数据集包含经典和现当代文学作品。经典作品被重点纳入,因为其中包含复杂句法、语言演变和文化指涉。现当代作品也被纳入,以减少来自已出现在大型语言模型预训练语料库中的广泛可用文本可能造成的污染。
-
质量过滤基于已验证的出版状态和人工翻译覆盖情况。经典作品要求目标段落至少有两条人工翻译,而现当代作品要求至少有一条人工翻译。
-
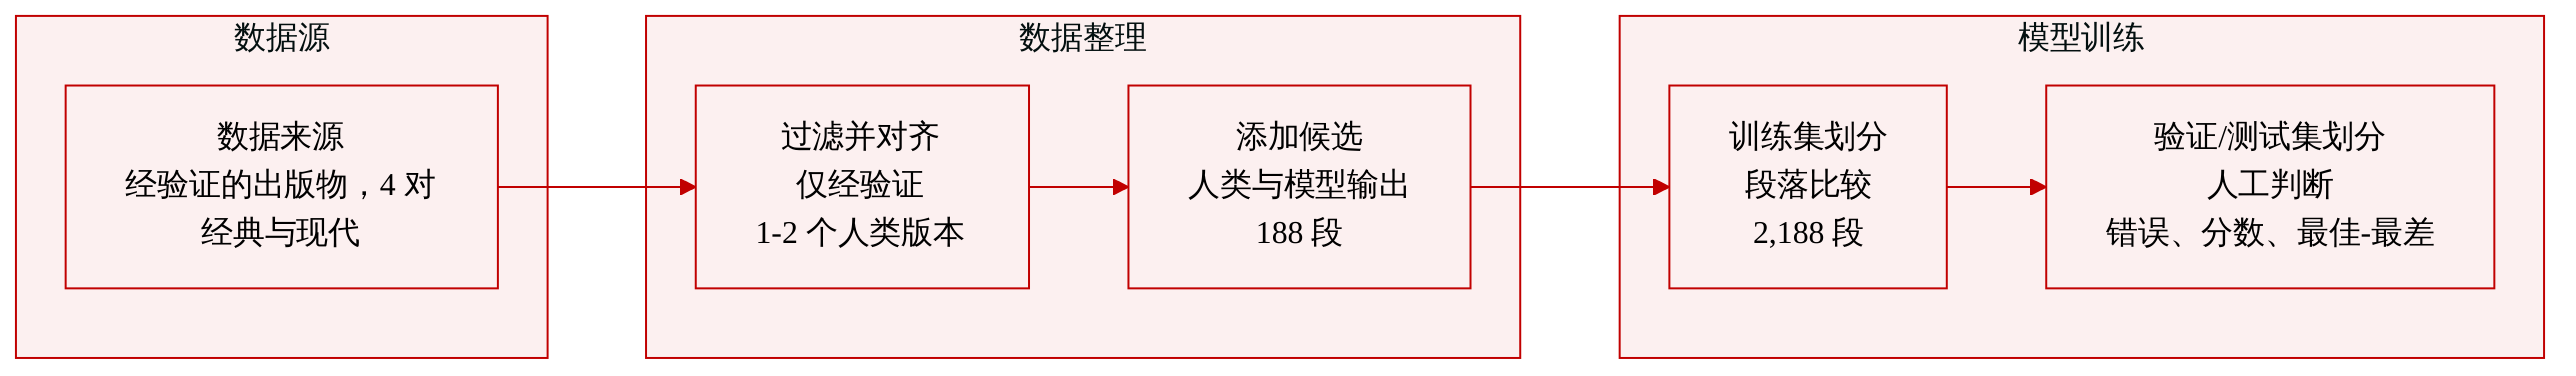
数据集构建分为三个步骤:首先选择并构建段落级平行语料库;其次从机器翻译和大型语言模型系统中收集翻译候选;最后通过人工评估来评估翻译质量。
-
对于经典德语到英语作品,研究者复用 PAR3 样本。对于现当代德语到英语作品以及所有其他语言方向,研究者通过手动对齐源段落和目标段落从零构建语料库。
-
数据集包含来自多种生成系统的段落级翻译候选。其中包括 Google Translate 和 DeepL 等商业系统,NLLB-3.3B 和 M2M-100-1.3B 等句子级 Transformer 模型,闭源 GPT-4o,以及 Llama 3、Qwen 2、Gemma 1.1 和 TowerInstruct 等较小的开源 LLM。LLM 翻译请求使用针对文学文本翻译的共享提示模板。
-
评估子集以段落级比较形式组织。每个源段落与多个目标翻译配对,包括人工翻译和模型输出,从而支持在不同系统和评估方法之间进行直接比较。
-
研究者使用该数据通过多种评估方案构建人工质量标注:基于 MQM 的引导式错误标注、自由式错误标注、SQM 标量评分以及最佳-最差选择。MQM 标注记录错误跨度,并将错误分为六类:术语、准确性、流畅性、风格、本地化约定和非翻译。每个错误被标注为主要错误或次要错误,MQM 得分按段落中的句子数进行归一化。
-
人工评估按预算和角色划分。学生评估者对所有片段执行 MQM 和 SQM 标注,并在样本上进行盲法最佳-最差选择。专业译者在样本上执行自由式错误标注和 SQM 评分,比较对象包括人工翻译、GPT-4o、Google Translate 和 DeepL,其中涉及中文的语言方向使用 Qwen。
-
该数据集按段落级处理,而非作为孤立句子处理。研究者未描述用于语料库构建的句子级裁剪;相反,采用段落对齐,并将句子数量用于评估归一化与分析。
-
所得数据集作为文学翻译评估基准。它用于生成系统输出、创建翻译比较集、收集跨度级错误标注、记录整体质量判断,并支持分析多个系统和语言方向上的段落级文学翻译质量。
方法
研究者采用一个用于文学翻译语料库和基准的三阶段数据构建流程。该流程围绕段落级平行数据设计,并结合经过筛选的人工翻译参考、多个机器翻译输出以及最终质量评估步骤。
第一阶段为英语、中文和德语构建段落级平行语料库,涵盖四个语言方向:英语到中文、德语到英语、英语到德语和德语到中文。研究者选择经典作品和现当代作品,以平衡难度和可靠性。经典作品被保留,因为它们通常包含对机器翻译系统具有挑战性的复杂句法、历史语言变异和文化特有指涉。同时,较旧的人工翻译具有价值,因为它们早于机器翻译的广泛使用,因此更不可能包含机器翻译痕迹。现当代作品也被纳入,以降低现代大型语言模型预训练数据中可能已存在文本带来的污染风险。
为维持高参考质量,研究者从经过验证的出版物中获取源段落和目标段落,包括 Project Gutenberg 书籍、已出版作品的阅读样本以及购买材料。对于经典作品,目标侧包含至少两条人工翻译;现当代作品包含至少一条。对于经典德语到英语数据,研究者使用 PAR3 中现有对齐样本。对于现当代德语到英语数据以及另外三个语言方向,语料库通过手动方式构建,由第一作者将源段落与人工翻译对齐。这一手动对齐步骤是流程中的关键质量控制环节,尤其对于段落级对应关系可能无法仅通过自动对齐恢复的文学文本而言。
第二阶段选择机器翻译系统,并为相同源段落收集翻译候选。系统选择有意保持多样性,覆盖不同的模型规模、部署模式和训练背景。研究者包含 Google Translate 和 DeepL 等商业系统,其中 DeepL 尤其相关,因为它在翻译工作流中被广泛使用。同时包含针对句子级翻译优化的先前强 Transformer 模型,例如 NLLB-3.3b 和 M2M-100-1.3b。此外,该流程还纳入闭源 GPT-4o 以及若干较小的开源语言模型:Llama 3、Qwen 2、Gemma 1.1 和 TowerInstruct。选择这些模型是为了代表不同的参数规模、语言专长和指令遵循能力。对于所有大型语言模型,研究者使用相同的提示格式,以减少不同系统之间由提示引起的变化。
第三阶段对收集到的翻译候选评估翻译质量。该阶段通过评估由经过筛选的源段落和参考翻译生成的输出,完成整个工作流程。由于该语料库按段落级构建,并使用了经过验证的人工参考翻译,因此评估设置适合评估机器翻译系统如何处理文学和翻译特有现象,例如长程连贯、风格细微差别和文化适应。
实验
该研究在 LITEVAL-CORPUS 上评估文学翻译质量,使用学生评估者和职业评估者,通过引导式 MQM、自由式错误标注、SQM 和 BWS 进行评判,然后将这些判断与无参考自动指标进行比较,包括 GEMBA-MQM、XCOMET 和 Prometheus。人工评估结果显示,各方案内部具有中等到高一致性,其中 BWS 对人工翻译和顶级机器输出的区分最可靠,而学生执行的 MQM 和 SQM 较不充分,除非将它们组合或由专业判断引导。自动指标与人工 MQM 只有中等相关性,通常无法区分高质量人工翻译与强 LLM 输出,尤其是在流畅性、风格和术语方面。研究结果还表明,基于 LLM 的翻译比人工翻译更直译且更缺乏多样性,并且 LLM 评估者可能偏好相似输出或自身输出。
该语料库包含四个语言方向的段落级文学翻译,源段落数量和翻译片段数量大体相当,但句子数量明显更大。目标段落的句子密度通常高于源段落,且各语言方向在平均句子负载上存在明显差异。德语到英语是句子最多的语言方向,而英语到德语最紧凑。德语到英语数据显示源段落和目标段落的平均句子数最高。英语到德语数据在句子密度上最紧凑,而涉及中文的语言方向介于两极之间。目标文本每个段落通常比源文本拥有更多句子,表明不同语言之间的句子切分存在差异。
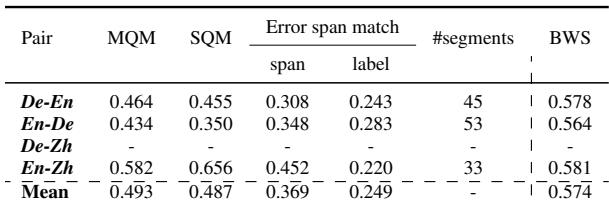
学生评估者对组在整体翻译得分上表现出中等一致性,MQM 和 SQM 在受评语言方向上的 Kendall's Tau 一致性大致相似。跨度和标签一致性低于整体得分一致性,尤其是当评估者必须同时匹配错误跨度和标签时;相比之下,BWS 跨度一致性更高。英中方向通常产生最强的得分一致性,而英德方向最弱。在学生评估者中,MQM 和 SQM 的平均一致性相近。标签匹配是最弱的跨度级一致性指标。BWS 跨度一致性高于 MQM 和 SQM 的平均一致性。
人工评估方案通常将人工翻译排在其他机器系统之前,但对顶级模型的判断存在明显差异。学生执行的 MQM 对非顶级系统的表现优于对顶级系统的表现,而 GEMBA-MQM 各版本很少将人工翻译排在顶级模型之前。专业 SQM 以及学生 MQM 与 SQM 的组合显示更强的人工偏好,表明评估者专业能力和方案设计具有重要影响。人工 MQM 和 SQM 经常将人工翻译排在其他系统之上。当纳入顶级机器系统时,学生 MQM 的有效性明显降低。专业 SQM 在识别人工翻译方面较学生 SQM 有显著提升。GEMBA-MQM 各版本倾向于将顶级机器输出排在人工翻译之前。
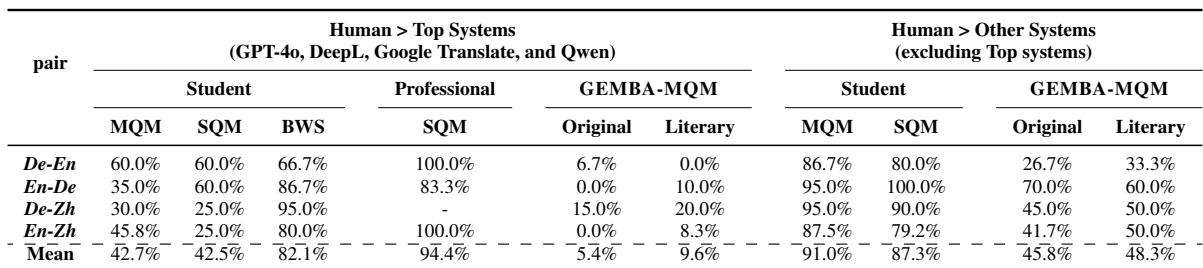
实验评估了一个覆盖四个语言方向的段落级文学翻译语料库、一项评估者一致性研究以及一项基于人工评估的系统排名研究。语料库分析显示,目标段落的句子密度通常高于源段落,各语言方向在平均句子负载上存在显著差异。一致性分析表明,学生评估者在整体得分上达到中等一致性,英中方向尤其如此,而在匹配错误跨度和标签时一致性较弱。系统排名结果显示,具有专业评估能力以及 SQM 类设计的人工评估方案能更有效地偏好人工翻译,而基于 LLM 的方案则可能偏向顶级机器输出。