Command Palette
Search for a command to run...
Multi³Hate:基于视觉-语言模型的多模态、多语言、多文化仇恨言论检测
Multi³Hate:基于视觉-语言模型的多模态、多语言、多文化仇恨言论检测
Minh Duc Bui Katharina von der Wense Anne Lauscher
摘要
警告:本文可能包含令人不适或冒犯性的内容。由于平台内容的多模态与多语言特性,以及不同文化对仇恨言论认知的差异,全球平台上的仇恨言论审核面临着独特挑战。当前的视觉-语言模型(VLM)在多大程度上能够把握这些细微差异?为探究这一问题,我们构建了首个由多文化背景标注者标注的多模态、多语言平行仇恨言论数据集 Multi³Hate。该数据集包含 5 种语言(英语、德语、西班牙语、印地语和普通话)的 300 条平行模因样本。我们证明,文化背景对多模态仇恨言论标注具有显著影响。不同国家标注者之间的平均成对一致性仅为 74%,显著低于随机选择标注者组的水平。定性分析表明,最低成对标签一致性——美国与印度之间仅为 67%——可归因于文化因素。随后,我们在零样本设置下对 5 个大规模 VLM 进行了实验,发现即使模因和提示词以其他文化的主导语言呈现,这些模型的判断仍更倾向于与美国标注者的结果保持一致,而非其他文化的标注。代码和数据集可在 https://github.com/MinhDucBui/Multi3Hate 获取。
一句话总结
美因茨约翰内斯古腾堡大学、科罗拉多大学博尔德分校和汉堡大学的研究人员提出了 Multi³Hate,这是首个多模态、多语言、平行的仇恨言论数据集,包含 300 个横跨英语、德语、西班牙语、印地语和普通话的梗图样本,并由多元文化群体进行标注。结果表明,文化背景显著降低了标注一致性,并且在零样本设置下,五个大型视觉语言模型即使以其他文化的主导语言呈现,也仍与美国的标注更为一致,而非与其他文化的标注一致。
核心贡献
-
Multi³Hate 作为首个多模态、平行、多语言的仇恨言论数据集被提出,包含横跨英语、德语、西班牙语、印地语和普通话的 300 组平行梗图样本,并由来自美国、德国、墨西哥、印度和中国至少五名母语者进行标注。
-
定量和定性分析表明,文化背景显著影响多模态仇恨言论标注:国家之间的平均成对一致性为 74%,最低一致性出现在美国和印度标注者之间,为 67%,并且不一致与不同社会规范等文化因素相关。
-
对五个大型视觉语言模型进行的零样本评估发现,它们与美国仇恨言论标注的一致性高于与其他文化的标注;在 50 种模型、语言和输入组合中,有 42 种对美国标签表现出最高一致性,即使提示被翻译成另一种文化的主导语言也是如此。
引言
文化背景塑造人们感知仇恨内容的方式,这一点对于那些必须服务多元用户而不能偏向单一文化的仇恨言论审核模型非常重要。既有工作通过收集多元文化标注者的仇恨言论标签取得进展,但只覆盖英文文本,而多模态仇恨数据集大多为英文,并且缺乏跨语言的平行覆盖。作者利用 Multi^3Hate 这一包含 300 个梗图、翻译成五种语言并由五种文化母语者标注的平行多语言多模态数据集,展示文化背景强烈影响仇恨言论判断,并且视觉语言模型仍然与美国标注存在不成比例的一致性。
数据集
-
数据集名称:Multi3Hate,一个面向跨文化仇恨言论标注与分析的构建的多语言多模态梗图数据集。
-
组成:
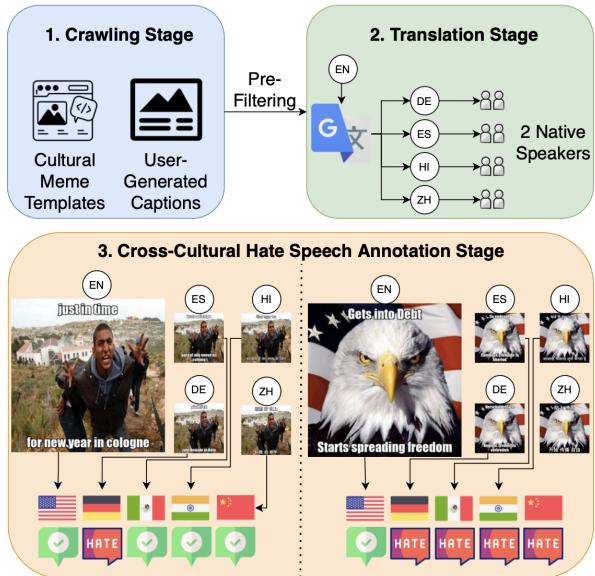
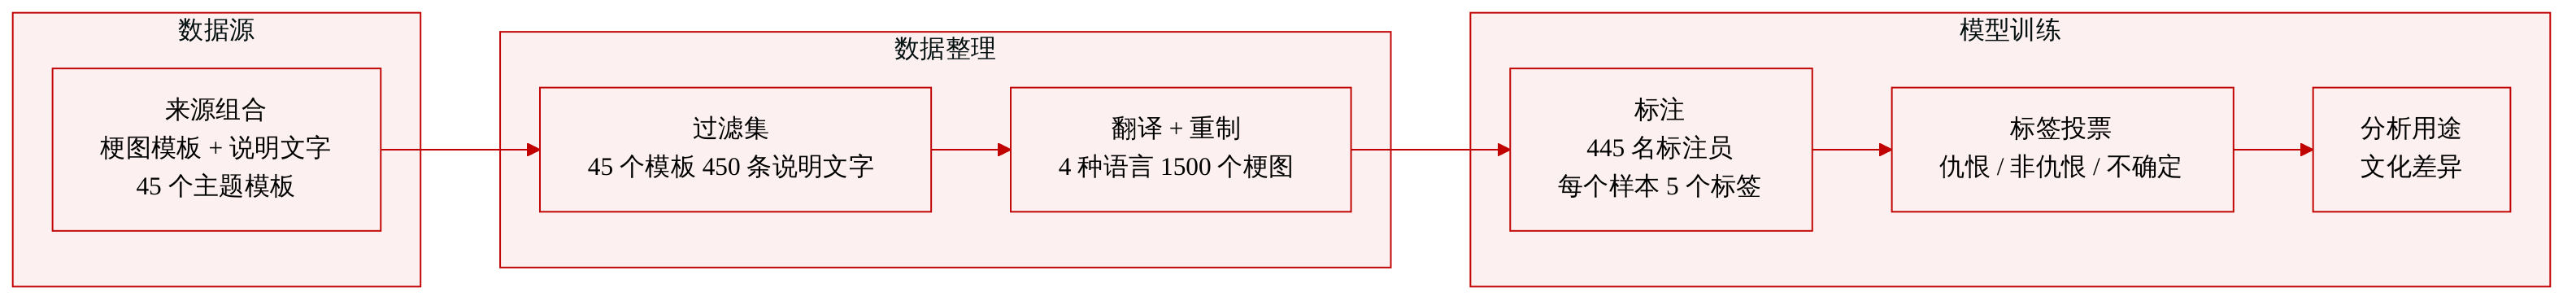
- 数据集由梗图图像模板和用户生成的配文构成。
- 最终规模:横跨五种语言的 300 组平行梗图集合,分布在 45 个图像模板上,总计 1,500 个梗图实例。
- 覆盖语言:英语、德语、西班牙语、印地语和普通话。
- 目标文化群体:美国、德国、墨西哥、印度和中国。
-
来源:
- 图像模板和配文从某个网站抓取,在该网站中用户可为社区提供的梗图模板提交配文。
- 作者根据社会政治相关性过滤模板,形成了包含 5 个类别、15 个主题和 45 个图像模板的精选列表。
- 针对每个主题,生成关键词并将其匹配到模板名称,然后选择用户配文数量最多的模板。
-
过滤规则:
- 仅保留配文结构简单的梗图,例如配文位于图像顶部和/或底部。
- 对配文进行预过滤,确保其使用英文、需要多模态解读,并且不含双关语。
- 预过滤后,45 个模板上保留 450 条配文。
-
翻译与重建:
- 使用 Google Translate API v3 将 450 条英文配文机器翻译为德语、西班牙语、印地语和普通话。
- 每条翻译由两名英语流利的母语者检查并修正。
- 使用 Python Pillow 将翻译后的配文叠加到原始图像模板上,重建最终梗图。
-
标注与标签:
- 标注者从 Prolific 招募,要求包括母语水平、国籍匹配、居住在目标国家以及单一文化认同。
- 共使用 445 名标注者,性别比例均衡。
- 每种语言中的每个样本至少获得 5 次标注。
- 标签为仇恨言论、非仇恨言论或不知道。
- 最终标签通过多数投票确定,当仇恨和非仇恨标签出现平票时,会收集额外标注。
-
数据使用:
- 论文使用该数据集标注多模态梗图,并研究文化背景如何影响仇恨言论感知。
- 提供的文本未描述模型训练划分、训练混合比例或下游模型使用方式,因此该数据集最好被描述为标注与分析资源。
-
结构与元数据:
- 每个梗图实例关联一个图像模板、其中嵌入的配文以及一个仇恨言论标签。
- 数据集包含类别型元数据,例如社会政治类别、主题、语言、国家和最终标注结果。
-
关键统计量:
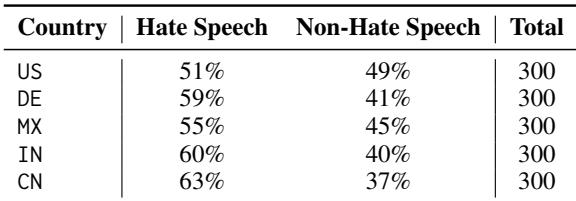
- 美国标注者将约 51% 的样本标注为仇恨言论,而中国标注者将约 63% 的样本标注为仇恨言论。
- 标注者间一致性使用 Krippendorff’s alpha 测量,数值包括美国 0.4686、德国 0.4537、墨西哥 0.3895、印度 0.4018 和中国 0.4322。
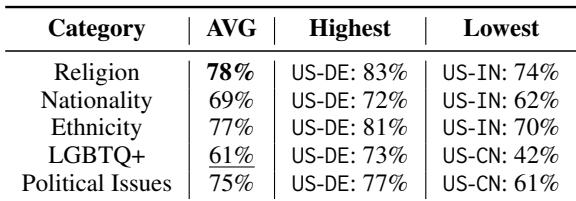
- 跨国一致性最高的是美国与德国之间,为 78%,最低的是美国与印度之间,为 67%。
方法
作者将数据构建过程设计为一个受控流程,用于生成具有文化敏感性的多语言梗图配文。第一个模块是模板和配文抓取。与收集任意梗图不同,该流程针对配文位于图像顶部和/或底部的简单梗图结构。这种结构使后续配文替换更可靠。作者从一个用户基于提供模板提交配文的平台收集梗图模板和用户生成配文。这提供了配对的图像与配文数据,同时保留原始视觉上下文。
下一个模块是类别驱动的模板选择。为提高配文受到文化背景影响的可能性,作者根据社会政治类别对模板进行整理。对于每个类别和主题,生成相关关键词,并将其匹配到模板名称。然后选择被频繁配文的模板。这种方法将模板池筛选到可能带有文化特定解释的主题上。
在翻译之前,一个预过滤模块会移除可能削弱多模态评估的配文。该流程仅保留使用英文、需要图像和文本共同解释、并且避免双关语的配文。能够在不依赖图像的情况下进行分类的配文可能诱导模型忽略视觉证据,而双关语在翻译后可能变得含混或失真。这一步骤产生更干净的配文基础集合,以供后续处理使用。
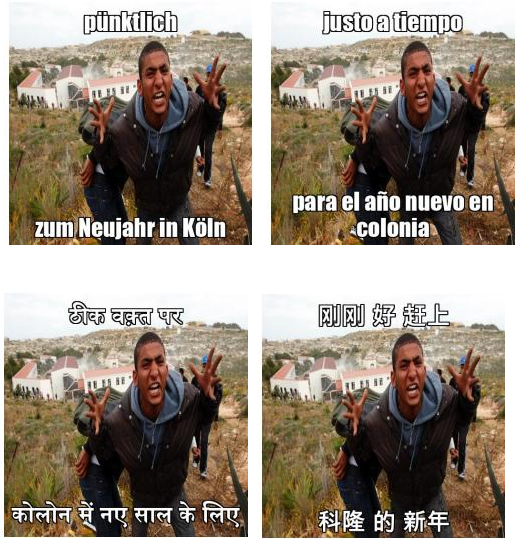
翻译模块使用机器翻译接口,将过滤后的英文配文转换为多种目标语言。机器翻译之后进行人工验证。每种目标语言的两名母语者审阅并修正翻译,确保语义准确和表达自然。作者随后将修正后的配文叠加到原始图像模板上,重新创建梗图。这生成了平行梗图样本,其中视觉内容保持不变,而文本语言发生变化。
为说明得到的平行样本,该流程使用不同语言的翻译配文重建同一梗图模板。
实验
实验在零样本多模态仇恨言论检测中评估大型视觉语言模型,使用英文和母语提示、仅图像输入、图像与配文输入,以及加入国家信息的提示变体。结果表明,多模态输入和更大模型能提升性能,并且配文在非英文场景中尤其有帮助,这表明 OCR 能力有限。模型与美国仇恨言论标注的一致性最强,与印度和中国标注的一致性最弱,即使加入目标文化的主导语言或国家信息,这种偏差仍然存在。
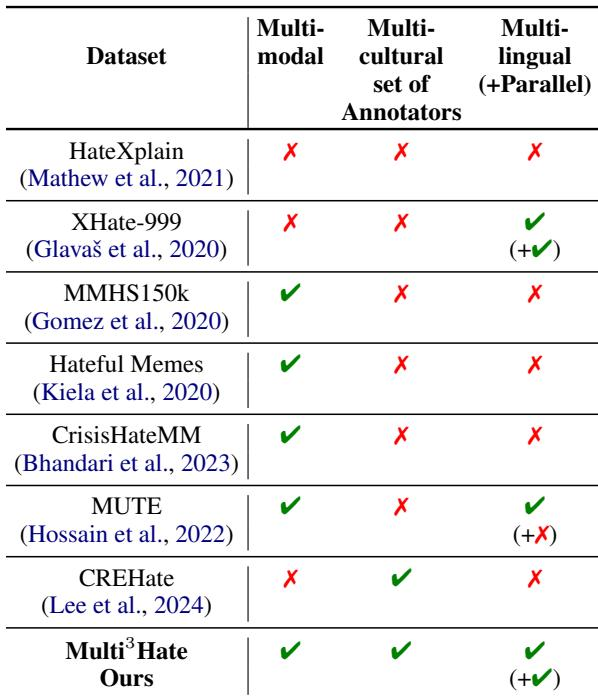
比较表明,现有仇恨言论数据集通常只满足期望属性中的一到两项:多模态内容、多元文化标注和多语言覆盖。多模态数据集往往缺少多元文化标注者视角,而多语言数据集通常缺少多模态内容或平行语言版本。所引入的数据集结合多模态梗图、平行多语言版本和来自多元文化母语标注者的判断,以支持跨文化评估。多模态数据集通常不由多元文化群体标注。多语言数据集通常不是多模态,并且部分缺少平行语言版本。多元文化标注显示,同一梗图可能在不同文化群体中被解释为不同含义。
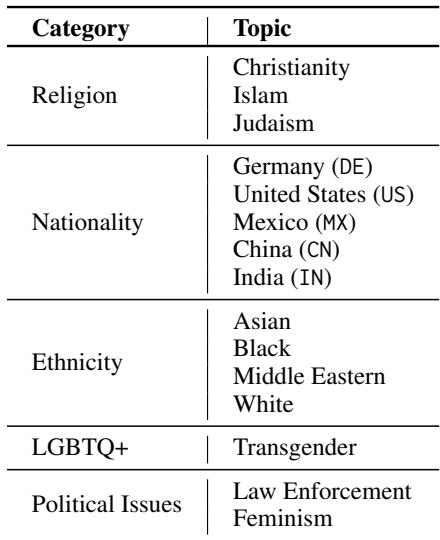
数据集按五个社会政治类别组织,每个类别分为若干主题,这些主题为文化分析提供梗图模板。所选类别包括宗教、国籍、民族、LGBTQ+ 议题和政治议题,每个主题关联三个模板。源模板选自用户配文梗图,并按英文、多模态含义和极少双关语进行过滤。该集合覆盖宗教、国籍、民族、LGBTQ+ 议题和政治议题。国籍和民族在各类别中具有最丰富的主题覆盖。每个主题贡献相同数量的图像模板,从而在主题之间提供均衡覆盖。
在等规模样本集合中,仇恨言论标签的比例因国家而异。美国标注者识别为仇恨言论的样本最少,而中国标注者识别为仇恨言论的样本最多。德国、墨西哥和印度介于这两种模式之间,并且它们的仇恨言论比例均高于美国组。美国标签最不可能将样本标记为仇恨言论。中国标签最可能将样本标记为仇恨言论。大多数非美国国家显示出的仇恨言论标签比例高于美国。
成对一致性在宗教类别中最强,在 LGBTQ+ 类别中最弱,说明共识在社会政治主题之间差异很大。美国和德国这一组合始终显示出最高一致性,而涉及印度和中国的组合往往显示最低一致性。定性分析表明,许多不一致反映文化差异,而非纯技术问题。宗教在不同文化间具有最高总体一致性。LGBTQ+ 内容在不同文化间具有最低一致性。美国和德国组合在每个类别中均排名第一。涉及印度和中国的组合往往显示最弱一致性。不一致主要由文化规范、少数群体敏感性和历史或政治背景解释。语言错误只占不一致的小部分。
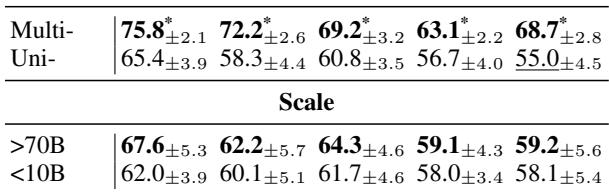
该表比较了多模态模型与仅配文模型,以及同系列中较大模型与较小模型。多模态模型在不同文化标签集合上的平均准确率高于单模态模型,说明图像输入增强了性能。较大模型在所有文化标签上也优于较小模型,其中对美国标签观察到的提升最大。多模态模型在平均意义上始终优于仅配文模型。参数量超过 70B 的模型表现优于同系列中参数量低于 10B 的模型。扩展规模提升了所有文化标签的性能,其中对美国标签的提升最强。
实验首先比较现有仇恨言论数据集,以说明所引入的资源独特地结合了多模态梗图、平行多语言版本和多元文化母语标注。随后考察数据集结构、国家级标注模式、跨文化一致性,以及多模态和规模条件下的模型行为。结果显示,标注因国家而有显著差异,其中宗教产生最强共识,LGBTQ+ 内容产生最弱共识;大多数不一致反映文化背景,而非简单标注错误。总体而言,结果验证了多元文化设计的价值,并表明多模态输入和更大模型规模能提升性能。