Command Palette
Search for a command to run...
学习还是检索:上下文示例在大语言模型回归任务中的作用
学习还是检索:上下文示例在大语言模型回归任务中的作用
Aliakbar Nafar Kristen Brent Venable Parisa Kordjamshidi
摘要
生成式大语言模型(LLMs)具备上下文学习的能力。然而,上下文学习(ICL)的底层机制仍然是一个重要的研究问题,关于模型如何利用 ICL 的实验研究结果并不总是相互一致的。本文提出了一个用于评估上下文学习机制的框架,我们认为该机制是检索内部知识与从上下文示例中学习二者的结合,并以回归任务为切入点展开研究。首先,我们证明大语言模型能够求解现实世界的回归问题,随后设计实验来度量模型在多大程度上检索其内部知识、在多大程度上从上下文示例中学习。我们认为这一过程处于两种极端之间的一条连续谱上。我们深入分析了这些机制在不同因素下被触发的程度,这些因素包括对任务的先验知识以及上下文示例所提供信息的类型和丰富程度。我们采用三个大语言模型并在多个数据集上验证了研究结论的鲁棒性。我们的研究结果揭示了如何设计提示词,以便根据所面对的问题充分利用来自上下文示例的元学习并促进知识检索。
一句话总结
密歇根州立大学、佛罗里达人机认知研究所和西佛罗里达大学的研究人员提出了一种评估大语言模型中上下文学习机制的框架,展示了上下文学习(ICL)在检索内部知识与从上下文示例中学习之间处于一个连续谱上,并针对回归任务提供了提示工程指导,以利用元学习或知识检索。
核心贡献
-
该研究表明,大语言模型能够利用上下文示例,根据特征-值输入预测数值输出,从而在真实数据集上执行回归任务,这扩展了以往基于合成任务的分析。
-
该研究引入了一种评估框架,将上下文学习视为介于内部知识检索与基于上下文示例学习之间的连续谱;相关因素包括特征-值对数量、示例数量和提示策略。
-
使用三个大语言模型和多个数据集开展的实验表明,这些模型将内部知识检索与上下文学习结合起来;该研究还针对回归任务提出了提示工程技术,用于控制这种平衡。
引言
大语言模型利用上下文学习,从提示词中的示例适应任务,这通常优于零样本提示;其重要性在于它塑造了构建灵活、可靠 AI 应用的方式。以往工作大多将上下文学习视为从示例中元学习新模式,或检索预训练期间存储的知识,但许多研究依赖范围狭窄、合成或较旧的模型设置,导致关于示例、标签和提示设计作用的矛盾仍未解决。作者认为上下文学习处于学习和检索之间的连续谱,并用基于回归的评估框架支持这一观点;该框架衡量内部知识、示例、特征和提示策略如何控制这种平衡。
数据集
-
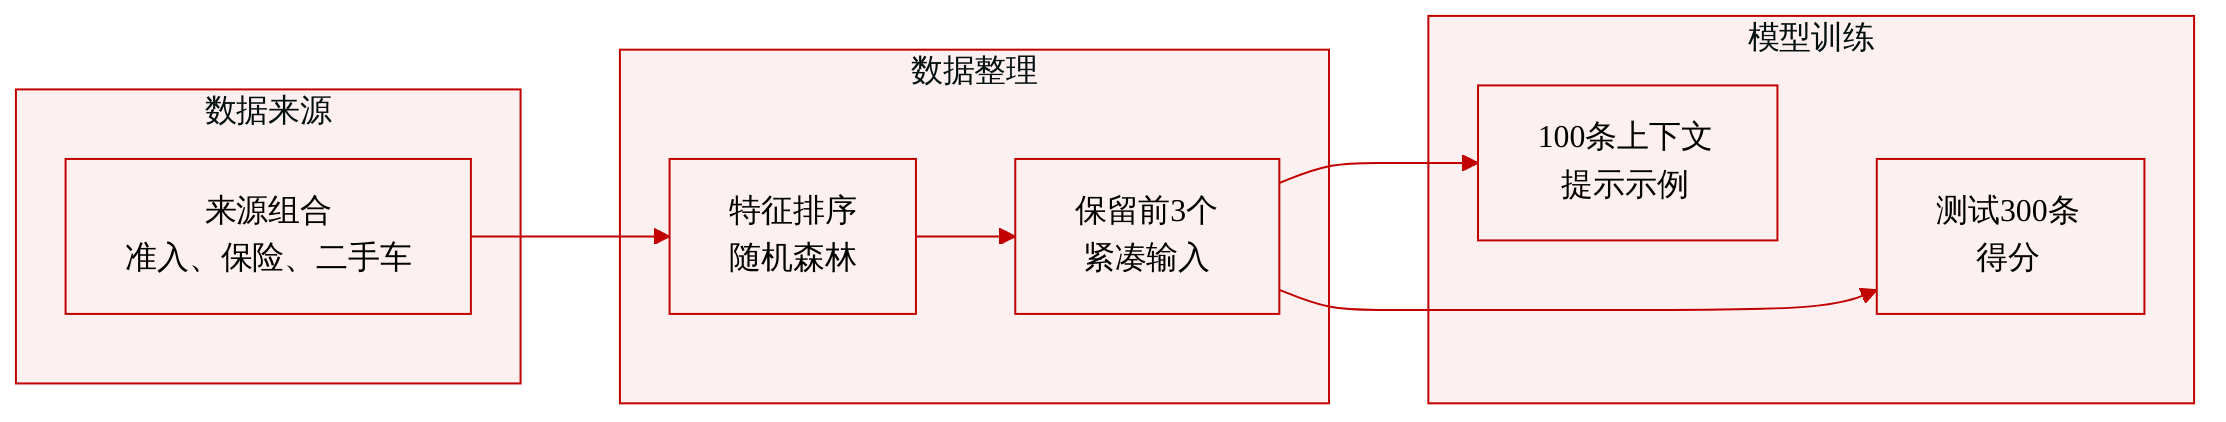
作者使用三个回归数据集,这些数据集经过筛选,用于评估语言模型在不同领域和任务复杂度下的表现。
-
每个数据集都经过预处理,仅保留三个最重要的特征;特征重要性使用 RandomForest 估计器计算。
-
Admission Chance 是一个面向印度学生的研究生入学数据集。作者选择三个高度相关的特征,并使用该数据集,因为它不太可能出现在以美国为中心的大语言模型训练数据中。
-
Insurance Cost 专注于预测美国健康保险公司开具的个人年度医疗费用,人口统计数据来自美国人口普查局。第一个特征的重要性遥遥领先。
-
Used Car Prices 用于估计 2019 年一辆二手丰田或玛莎拉蒂的价格。前两个特征对该任务影响最大。
-
对于每个数据集,作者构建两个划分:一个包含 100 个样本的上下文子集和一个包含 300 个样本的测试子集。
-
该处理流程强调紧凑且聚焦特征的输入:在评估前,将每个数据集过滤为最强预测特征。
方法
所提出的方法将表格回归视为语言模型预测任务。给定数据集
D={(xi,yi)}i=1n,每个样本包含输入向量 xi 和数值目标 yi。输入 xi 表示为特征值对集合 (fij,vij),其中 fij 表示特征名称,vij 表示其数值。例如,特征名称可以是燃油经济性、里程数或车辆类别等语义属性,对应值则是该样本的数值观测。目标 yi 是待预测的数值输出。
核心流程会向大语言模型提供一个由上下文示例构建的提示词。具体而言,作者从数据集的上下文划分中选择 m 个示例的子集,
{(x1,y1),(x2,y2),…,(xm,ym)},然后使用测试样本 x 的特征对查询模型。模型应返回对应目标值的标量估计。当 m=0 时,该设置变为零样本提示设置,上下文中不提供任何回归示例。
提示词由三个主要部分组成:任务指令、一组上下文示例和最终查询。任务指令定义回归目标并约束输出格式。特别地,模型被要求仅用一个数字估计目标值,不生成解释或中间推理文本。上下文示例提供有监督的输入输出演示,而查询包含需要模型进行预测的样本的特征值。
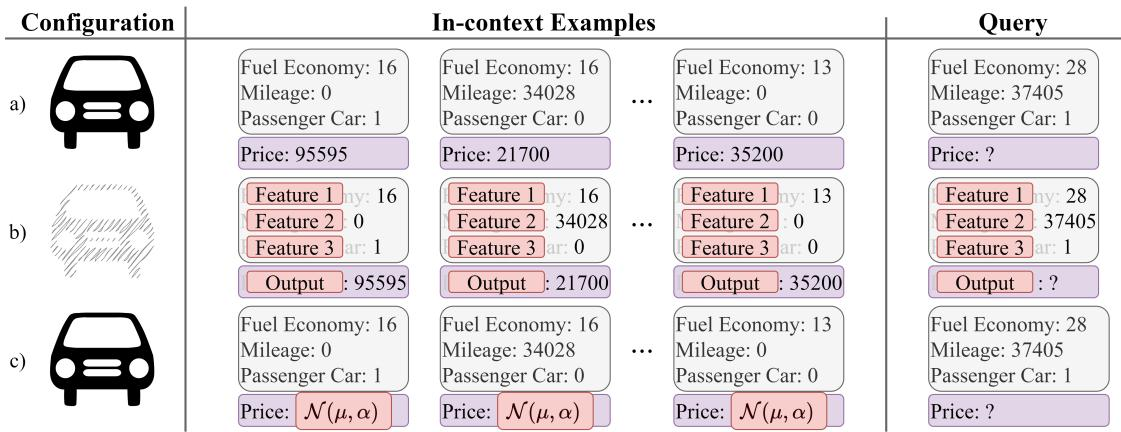
关键方法模块是一组提示配置,用于探测模型是否在利用特征语义、从上下文模式中学习,或者仅拟合给定的数值分布。请参见框架图。
在命名特征配置中,提示词暴露真实特征名称和目标变量的真实名称。例如,模型可能被要求根据城市燃油经济性、里程数和车辆分类等特征估计二手车价格。上下文示例包含相同的语义特征名称及其对应目标值。该配置允许模型将预训练的领域知识与观察到的特征-输出关系结合起来。
在匿名化特征配置中,语义特征名称和目标名称从提示词中移除,并替换为 Feature 1、Feature 2 和 Output 等通用标签。输入值保持不变,但模型不再能访问有意义的特征描述。因此,模型不能直接依赖与原始变量相关的领域知识,而必须仅使用上下文示例,推断从数值特征值到输出值的映射。
在随机化真实值配置中,保留命名特征,但上下文示例中的真实目标值被替换为随机数值。这些数值根据数据集统计量从高斯分布生成,与原始特征值关系无关。该配置起到对照条件的作用。如果模型在该设置下仍取得较强性能,则说明提升可能并非来自真正学习示例中的回归关系。相反,模型可能受到示例存在、提示结构或与真实输入-输出函数无关的分布先验的影响。
还使用直接问答基线,为没有上下文回归示例的数值生成提供参考点。在该设置中,模型接收测试样本的命名特征,并被要求直接估计目标。为了缩小数值生成的搜索空间,指令中包含数据集级统计量,例如目标变量的均值和标准差。该基线有助于区分原始数值先验知识的效果与上下文学习的效果。
实验
实验在三个数据集上比较较强的大语言模型与 Ridge 和 RandomForest 回归,并改变提示格式、上下文示例数量和特征数量,以分离出大语言模型如何结合知识检索与示例学习。直接问答表明,当任务知识较弱时,模型对特征的使用有限;而命名特征提示通过调用内部知识提升性能,并可在少示例设置下优于传统模型。随机化示例标签或匿名化特征会使行为转向基于示例的学习,而更多特征主要增强知识检索,并可能暴露数值数据污染;这表明有效的提示设计应在有信息量的特征、示例数量和示例顺序之间取得平衡。