Command Palette
Search for a command to run...
一种基于逻辑谬误感知的论证生成框架
一种基于逻辑谬误感知的论证生成框架
Luca Mouchel Debjit Paul Shaobo Cui Robert West Antoine Bosselut Boi Faltings
摘要
尽管大语言模型(LLM)表现出色,但其在生成逻辑严谨的论证方面仍存在不足,由此带来传播虚假信息等潜在风险。导致大语言模型在生成连贯论证方面表现欠佳的一个重要因素,是模型对逻辑谬误的忽视。为解决这一问题,我们提出了谬误感知偏好优化(FIPO),旨在引导大语言模型生成逻辑严谨的论证。FIPO 引入了分类损失来捕获谬误类型的细粒度信息。在论证生成任务上的实验结果表明,FIPO 将谬误错误最多降低了 17.5%。此外,人工评估结果显示,本方法生成论证的质量显著优于微调基线及其他偏好优化方法(如 DPO)。上述发现凸显了确保模型具备逻辑谬误意识对于有效论证生成的重要性。
一句话总结
EPFL 提出谬误知情的偏好优化(FIPO),将针对细粒度谬误类型的分类损失整合进面向大语言模型的偏好优化中,在论证生成任务上将谬误错误最多降低 17.5%,并显著优于 DPO 和微调基线。
核心贡献
- 引入谬误知情的偏好优化(FIPO),通过谬误类型分类损失增强偏好优化,帮助大型语言模型生成逻辑上合理的论证。
- 在 EX-PLAGRAPHS 数据集上为论证生成构建谬误感知评估设置,由 GPT-4 作为自动谬误识别器,并通过人工标注和涵盖零样本提示及检索增强生成的基线实验进行验证。
- FIPO 在论证生成任务上将谬误错误最多降低 17.5%,人工评估显示生成的论证质量显著高于微调基线以及 DPO 等偏好优化方法。
引言
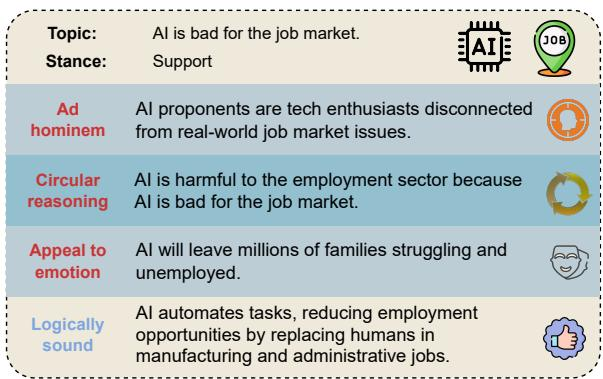
论证生成支持法律、政策与在线辩论场景中的说服,逻辑连贯性与证据质量直接影响信任与决策。大型语言模型能够起草论证,但仍容易出现推理错误,尤其是虚假因果和错误泛化;既往研究主要关注谬误检测或受控论证生成,未训练模型偏向无谬误推理。现有偏好方法可以使论证符合用户偏好,但通常将所有谬误视为同等重要,不能可靠减少逻辑错误。该研究利用谬误分类体系和偏好优化,提出谬误知情的偏好优化,在训练中加入谬误分类惩罚,从而提升论证质量并降低谬误率。
数据集
-
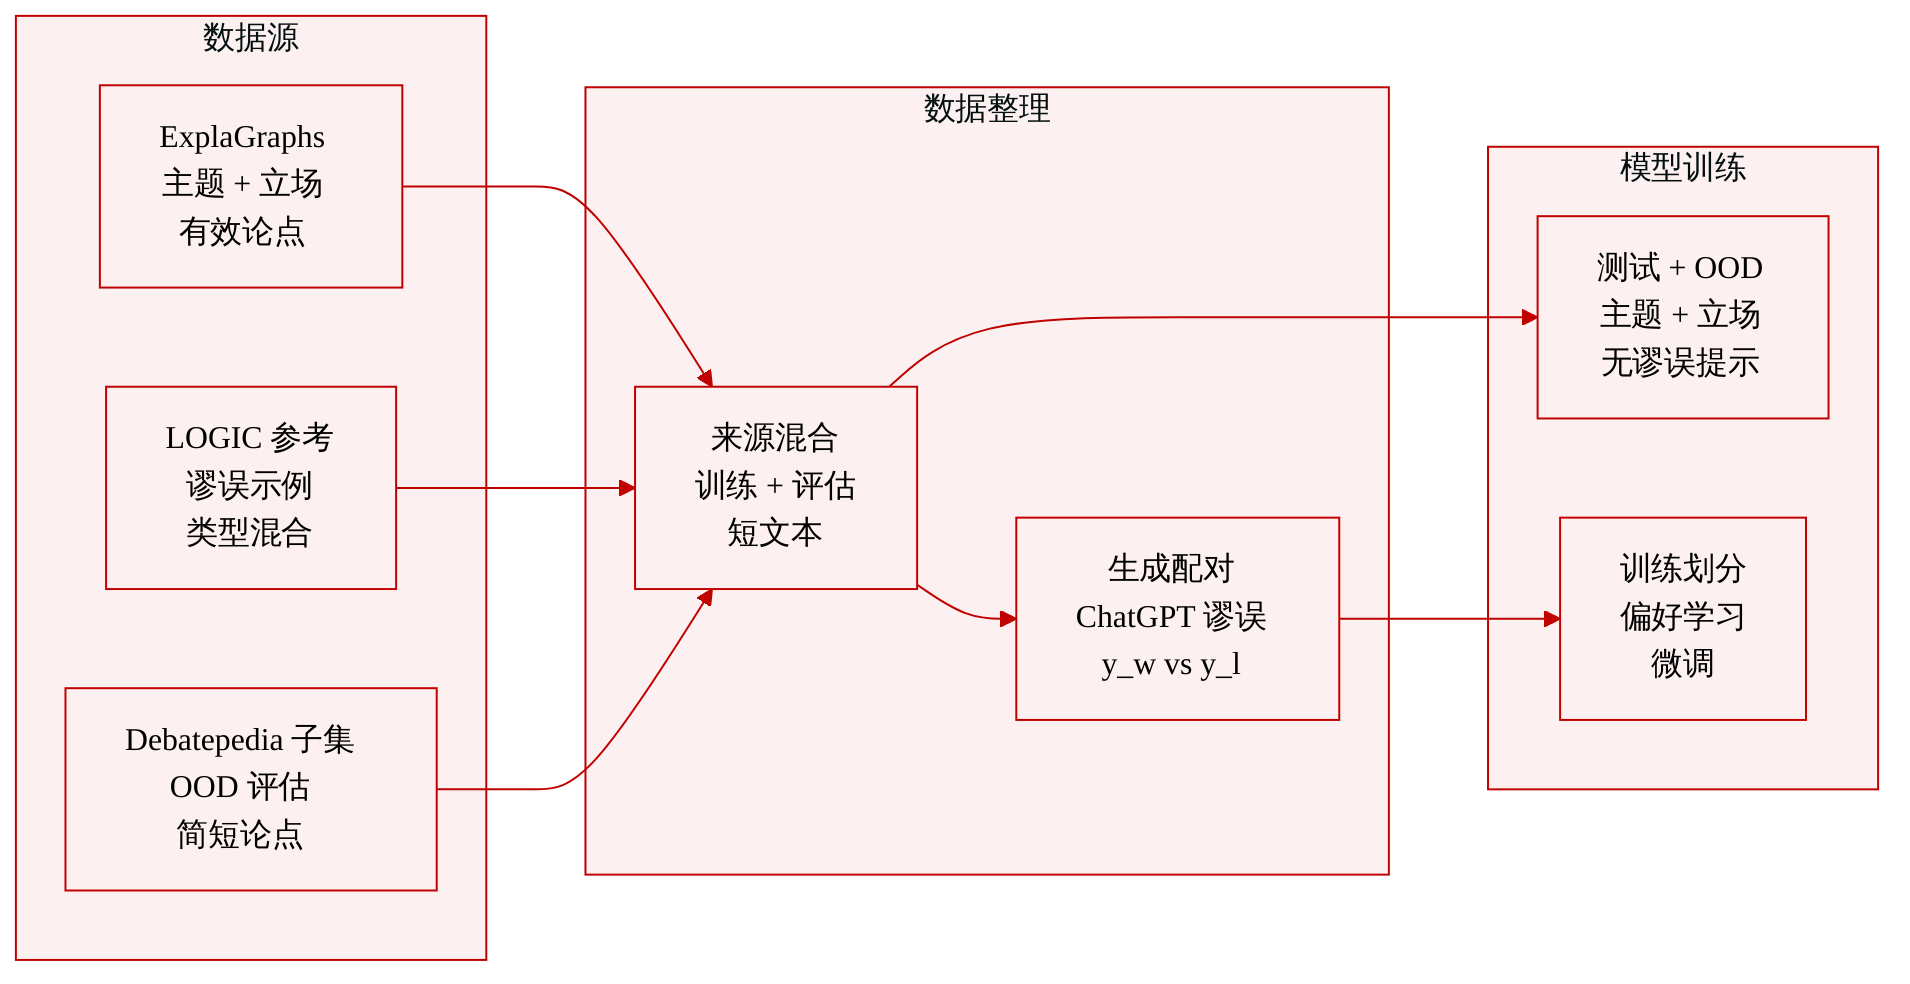
数据集组合三个来源:
- ExplaGraphs:提供主题、立场和短论证,通常包含 5 到 20 个词,覆盖广泛主题。
- LOGIC:来自多样网络来源的带标签逻辑谬误集合。该研究主要将 LOGIC 作为谬误定义、示例和现实谬误类型分布的参考,而非主要论证样本来源。
- Debatepedia:仅使用一个子集进行域外评估。
-
为构建谬误感知偏好数据,该研究从 ExplaGraphs 中的有效论证出发,并生成非偏好替代样本:
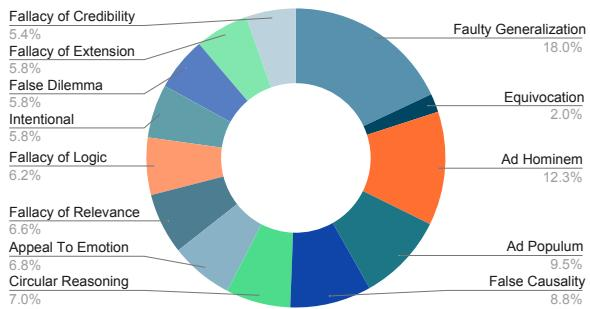
- 定义 13 个谬误类别,并从 LOGIC 所代表的现实世界分布中采样谬误类型。
- 对于每个有效论证 y_w,ChatGPT 生成四个等价谬误论证 y_l,每个使用一个不同的采样谬误类型。
- 生成提示包含目标谬误的定义和 LOGIC 中该谬误的示例,这有助于过滤输出并验证生成的论证确实是目标谬误的一个实例。
-
最终偏好数据集具有如下结构:
- 主题 t
- 立场 s
- 偏好的有效论证 y_w
- 非偏好的谬误论证 y_l
- 对应 y_l 的谬误标签 k
- 该研究将该集合记为 M 组偏好/非偏好配对。
-
该研究保持测试集比训练偏好集更简单:
- 测试样本不使用生成的谬误进行增强。
- 推理阶段仅使用主题和立场,因此评估衡量模型能否自主生成符合逻辑、无谬误的论证。
-
该研究聚焦短论语文本,因为 ExplaGraphs 和 LOGIC 都包含短论证与谬误。论文在数据集表格中报告了最终训练/测试划分规模。
方法
该研究采用四阶段偏好学习框架,使语言模型与逻辑有效的论证对齐。该流程首先从监督微调开始,随后构建包含有效论证和谬误论证的合成偏好配对,再应用偏好优化,最后通过细粒度谬误分类增强优化。这将谬误规避变成显式对齐目标,而不是把逻辑正确性视为非结构化生成偏好。框架概览如下所示:
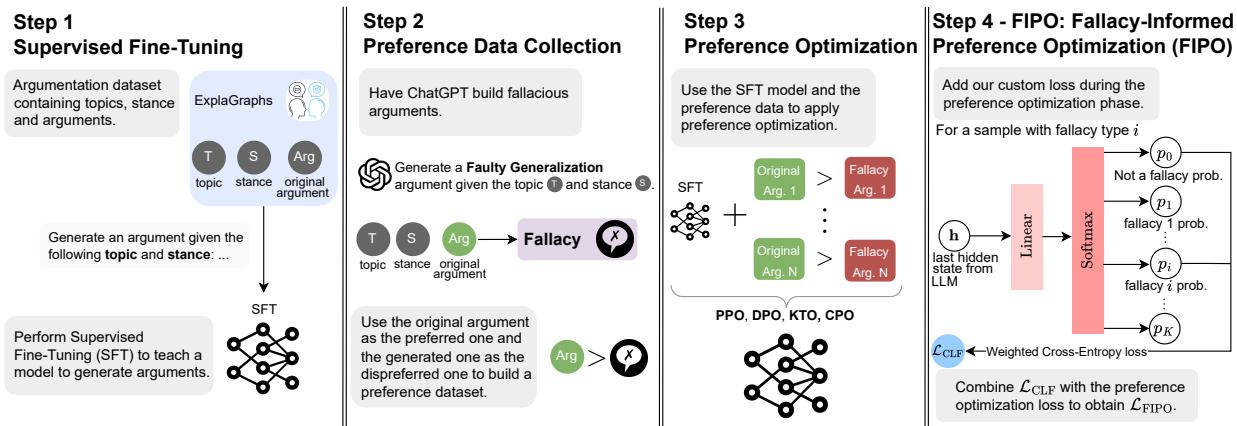
在第一阶段,该研究在包含主题、立场和有效论证的论证数据集上进行监督微调。预训练语言模型通过最大似然估计进行优化,以学习生成流畅且符合立场的论证。输入由主题 t、立场 s 和一个偏好的有效论证 yw 组成,监督训练损失为:
LSFT(πβ)=−E(t,s,yw)∼D[log(πβ(yw∣t,s))]该阶段产生基础论证策略,但仅靠监督训练无法教给模型为什么某些论证应当被视为非偏好。因此,该研究构建偏好数据集,将有效论证与人工生成的谬误论证配对。对于每个原始有效论证,该研究提示生成模型在指定谬误类型下生成等价但谬误的论证。每个生成的谬误论证以主题、立场、目标谬误定义以及该谬误的代表性示例为条件。对于每个有效论证,该研究生成具有不同谬误类型的四个谬误变体,从而鼓励广泛覆盖逻辑错误类别。
所得偏好数据集表示为:
D′={t(i),s(i),yw(i),yl(i),k(i)}i=1M其中 yw(i) 是偏好有效论证,yl(i) 是非偏好谬误论证,k(i) 表示分配给非偏好样本的谬误类型。在分类阶段,偏好论证也被标记为非谬误示例。谬误类型分布并非均匀分配。相反,该研究使用在真实论语文本中观察到的谬误经验分布来指导合成谬误论证的采样。这使偏好数据更能代表自然逻辑错误。用于塑造偏好数据的谬误分布如下图所示:
在偏好优化过程中,该研究使用若干算法,包括 PPO、DPO、KTO 和 CPO。PPO 依赖显式奖励模型,该模型在偏好配对上训练,以向有效论证分配更高奖励,并向谬误论证分配更低奖励。其他方法通过对比优化直接从偏好配对中导出隐式奖励。通常,对齐策略被鼓励给偏好论证 yw 分配更高概率或更高隐式奖励,而不是给非偏好谬误论证 yl。
尽管标准偏好优化能够降低总体谬误率,但该研究观察到,它并未显式教给模型被拒绝论证中存在何种逻辑谬误类型。这一局限促使该研究提出主要方法,即谬误知情的偏好优化(FIPO)。FIPO 通过分类头增强语言模型,用于预测论证是否包含谬误,若包含,则进一步预测其表现出的谬误类型。该模块作用于语言模型产生的隐藏表示。模型 πθ 完成一次前向传播后,提取最后一层中与最后一个 token 相关联的隐藏状态:
hθ(y∣t,s):=πθ(y∣t,s)L,T其中 L 表示层数,T 表示最终 token 的位置。该表示经过线性分类器和 softmax 操作。若 k 是谬误类型,预测概率为:
Phθk(y∣t,s)=Softmax(Whθ(y∣t,s)+b)k分类器将有效论证视为类别 0,对应标签“Not a Fallacy”。为确保模型优先关注最常见且实践上重要的谬误类型,该研究基于这些类型在偏好数据集中的频率定义类别权重。设 wk 表示谬误类型 k 在 D′ 中的频率:
wk=M1i=1∑M1{k(i)=k}非谬误类的权重被设为最小谬误权重:
w0=kminwk该加权方案对常见谬误类型的误分类施加更强惩罚,同时防止规模较大的非谬误类主导分类目标。所得谬误分类损失是加权交叉熵损失:
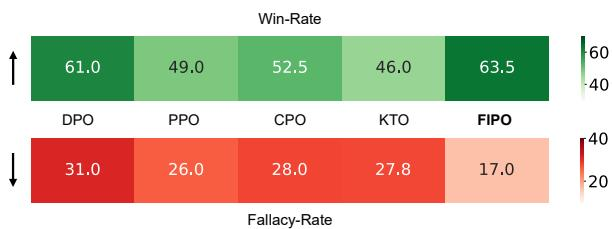
LCLF(πθ)=−E(t,s,yw,yl,k)∼D′[w0logPhθ0(yw∣t,s)+wklogPhθk(yl∣t,s)]该研究将该分类损失整合进偏好优化目标。选择 CPO 作为基础偏好损失,因为它在论证质量和谬误降低之间提供了有利平衡。参见比较偏好优化策略的人工评估结果:
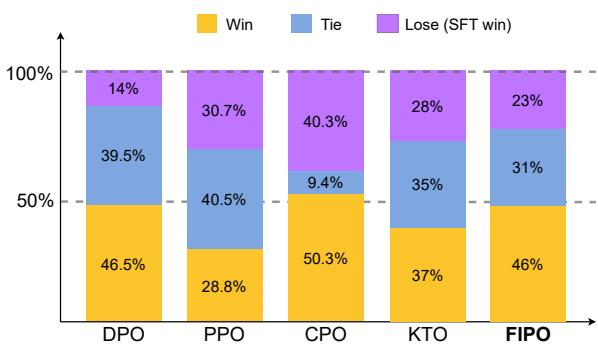
使用 GPT-4 的自动评估通过联合考察胜率和谬误率进一步支持这一设计选择。自动评估结果见下:
将 CPO 偏好损失与谬误分类损失结合,得到最终 FIPO 目标:
LFIPO(πθ)=LCPO(πθ)+λLCLF(πθ)其中,λ 控制谬误感知分类信号的相对强度。在训练期间,该目标鼓励模型不仅偏好有效论证而不是谬误论证,还内化与每个非偏好样本相关联的具体谬误类型。
实验
实验在 EXPLAGRAPHS 数据集上评估短逻辑论证生成,并在 Debatepedia 上进行域外检查,在小型语言模型上比较零样本提示、监督微调基线以及若干偏好优化方法。使用人工标注和自动评判来比较论证质量与逻辑健全性,并通过额外人工检查验证 GPT-4 作为谬误分类器的有效性,同时揭示谬误类别中的某些歧义。在域内和域外设置中,偏好对齐模型总体优于监督基线,谬误感知方法产生最强的整体增益,表明显式谬误引导、谨慎损失加权和适当的谬误分布对于生成更逻辑健全的论证很重要。
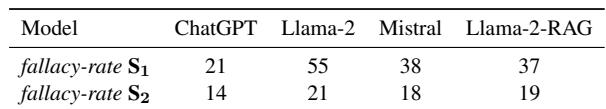
在所评估的基线中,ChatGPT 在两种场景中一致产生谬误率最低的论证,而未使用检索的 Llama-2 显示最高错误率。检索增强相较 Llama-2 降低谬误率,并且第二个场景在所有模型上都比第一个场景具有更低谬误率。在基线中,ChatGPT 达到最低谬误率;相比原始 Llama-2,Llama-2-RAG 减少谬误;第二个场景降低了所有被评估模型的谬误率。
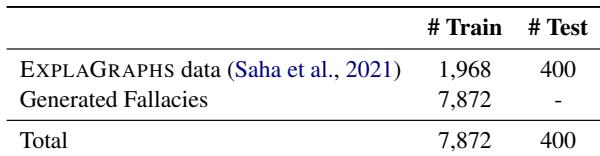
偏好数据集划分为训练和测试部分,两者由原始短论证和生成谬误构建。训练数据通过合成谬误示例显著扩充,而测试部分仍基于原始短论证数据。这支持评估谬误感知模型时,不直接在生成谬误实例上进行测试。训练划分结合原始论证数据与更大的生成谬误集合。测试划分仅使用原始短论证数据。数据集聚焦短论证与谬误,用于谬误感知模型评估。
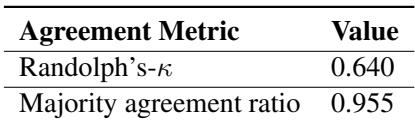
一致性分数表明,人工标注者在判断论证质量时达到中等可靠性。标注者与 GPT-4 之间的一致性非常高,表明 GPT-4 的分类与人类判断在谬误评估任务中高度一致。标注者之间的一致性为中等,符合论证评估的主观性质。标注者与 GPT-4 的一致性很高,支持将 GPT-4 用作可扩展的谬误检测评估器。
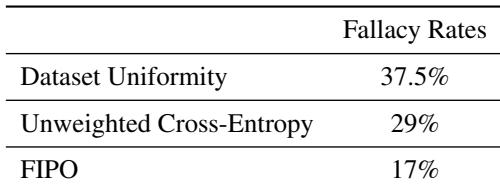
消融实验表明,使用均匀平衡的谬误数据集或未加权交叉熵训练 FIPO,与完整方法相比会增加观察到的谬误率。保留谬误类型的自然不均衡并使用加权交叉熵,与最强的谬误降低相关。与完整 FIPO 设置相比,均匀采样谬误类型会提高谬误率。与加权交叉熵相比,未加权交叉熵导致更高的谬误误分类。自然谬误分布和加权分类损失被视为降低谬误率的关键因素。
GPT-4 评估显示,与 SFT 基线相比,偏好优化通常降低逻辑谬误率,尽管 DPO 改进最少,并且在 Mistral 上可能比 SFT 更差。FIPO 在 Llama-2 和 Mistral 上均取得最低谬误率,表明新增的谬误分类信号有助于模型避免缺陷推理。Faulty Generalization 是观察到的最常见谬误类型,FIPO 在比较策略中产生该谬误的最低频次。FIPO 在 Llama-2 和 Mistral 上产生最少谬误。与 SFT 相比,对齐方法减少谬误,其中 DPO 改进最弱。Faulty Generalization 是最常见谬误,FIPO 对降低它尤其有效。
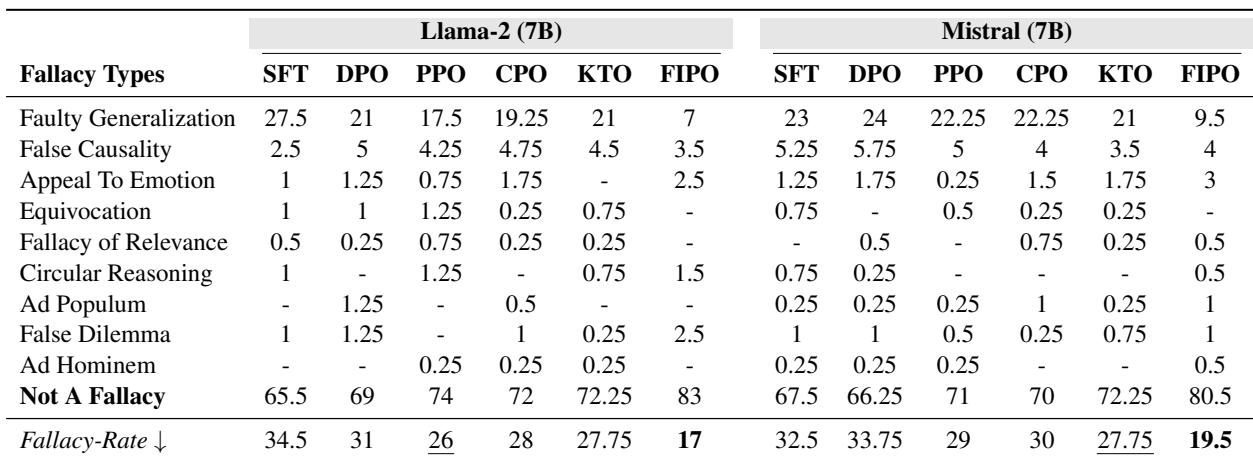
实验在检索和场景设置中评估模型生成论证的谬误率,使用由合成谬误扩充的训练集和由原始短论证组成的测试集来评估泛化能力。人工标注及与 GPT-4 的一致性表明,GPT-4 可以作为可扩展评判器,尽管论证质量判断仍有些主观。消融表明,保留自然谬误分布并使用加权分类损失很重要,而对齐方法的比较显示,偏好优化总体上减少谬误,其中 FIPO 表现最好,DPO 最弱,尤其是在常见的 Faulty Generalization 谬误上。