Command Palette
Search for a command to run...
BIGGEN BENCH:利用语言模型对语言模型进行细粒度评估的系统化基准
BIGGEN BENCH:利用语言模型对语言模型进行细粒度评估的系统化基准
摘要
随着语言模型(LM)能够处理日益广泛的任务,其评估已变得与开发本身同样具有挑战性。当前大多数生成基准使用抽象的评估标准——如有用性和无害性——来评估语言模型,而这些标准往往缺乏人类评估所具备的灵活性和细粒度。此外,这些基准往往过度侧重指令跟随等特定能力,导致覆盖偏差。为克服上述局限,我们提出了 BIGGEN BENCH,一个系统化的生成基准,旨在通过 77 项多样化任务全面评估语言模型的九项不同能力。BIGGEN BENCH 的一项核心特征是采用实例特定的评估标准,高度契合人类评估的细腻辨别力。我们利用五个评估语言模型,通过该基准对 103 个前沿语言模型进行了评估。我们的代码、数据和评估结果均已公开。
一句话总结
卡内基梅隆大学、KAIST、LG AI Research 及其他机构的研究人员推出了 BIGGEN BENCH,这是一个设计原则明确的生成式基准,通过五种评估用 LM,在 77 项多样任务中评估九种不同的 LM 能力,并采用实例特定标准来模拟人类水平的细粒度;该基准被应用于 103 个前沿 LM。
核心贡献
-
BIGGEN BENCH 作为面向九项核心语言模型能力、覆盖 77 项多样任务的生成式基准被提出。它采用设计原则明确的自顶向下构建流程,为每个实例分配量身定制的评估标准。
-
该基准将 LM-as-a-judge 评估从指令遵循扩展到更广泛的范围,通过让评估用语言模型应用任意且细致的标准,覆盖推理、安全、工具使用和多语言能力等能力。这避免了对自由文本输出使用精确匹配或相似度指标进行评估。
-
论文使用五种评估用 LM 评估 103 个前沿 LM,并考察预训练模型、后续训练模型和专有模型之间的性能趋势。论文还显示评估用 LM 判断与人类评估之间存在显著相关性,并释放代码、数据和结果。
引言
该论文关注系统性地衡量语言模型实际能够完成什么,尤其针对自由文本输出。这类输出可能读起来流畅,但仍然无法完成特定能力。更好的评估有助于揭示模型局限、指导后续训练,并在简单的有用性分数或选择题准确率之外比较前沿系统。
既有方法的局限在于:“有用性”等宽泛代理指标具有主观性,分类或相似度分数可能遗漏假阴性,而且许多生成基准关注窄能力或容易验证的约束。它们也难以评估细致的实例级行为,例如推理步骤、工具使用、心智理论、文化敏感性或回复优化。
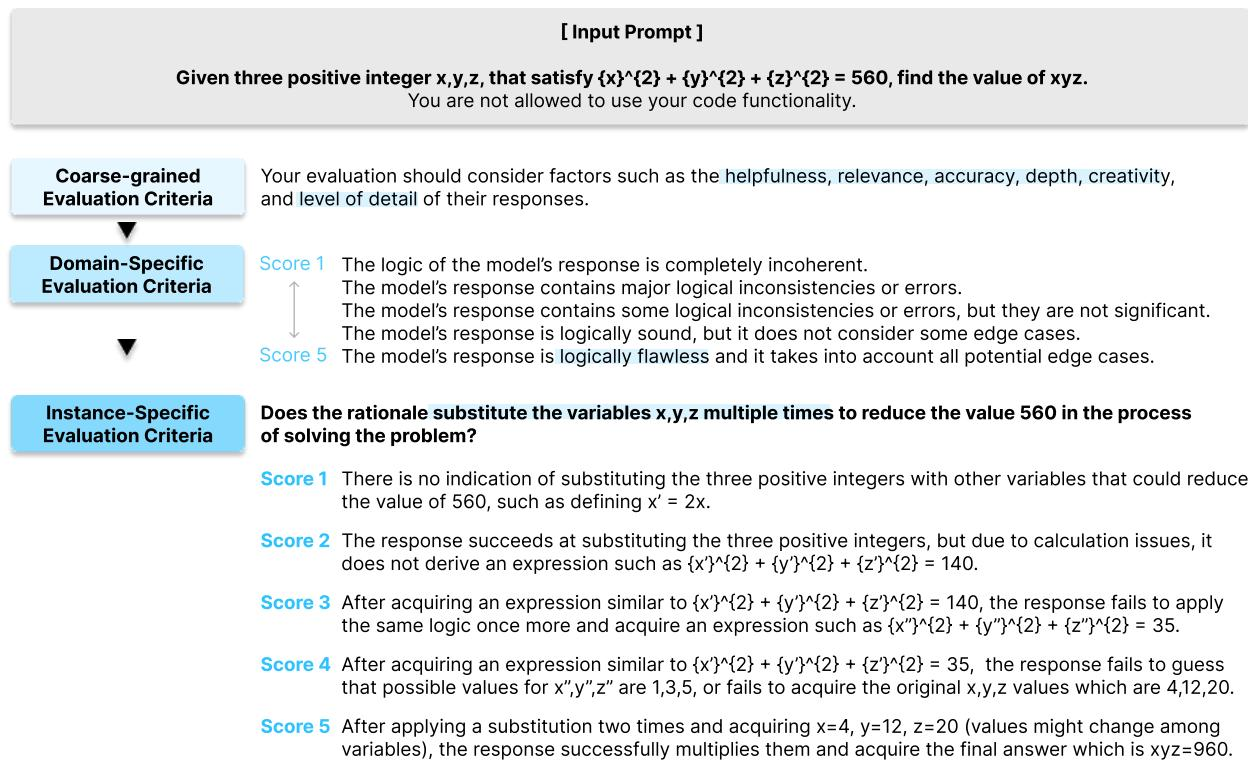
作者通过引入 BigGen Bench 来解决这一问题。它是一个自顶向下的生成基准,在九项核心能力上采用实例特定评估标准,包括指令遵循、grounding、规划、推理、回复优化、安全、心智理论、工具使用和多语言能力。作者在一个统一流水线中利用评估用 LM 对自由文本输出评分,评估 103 个前沿模型和 14 个专有模型,并通过与人类判断的显著相关性验证评估器可靠性。
数据集
-
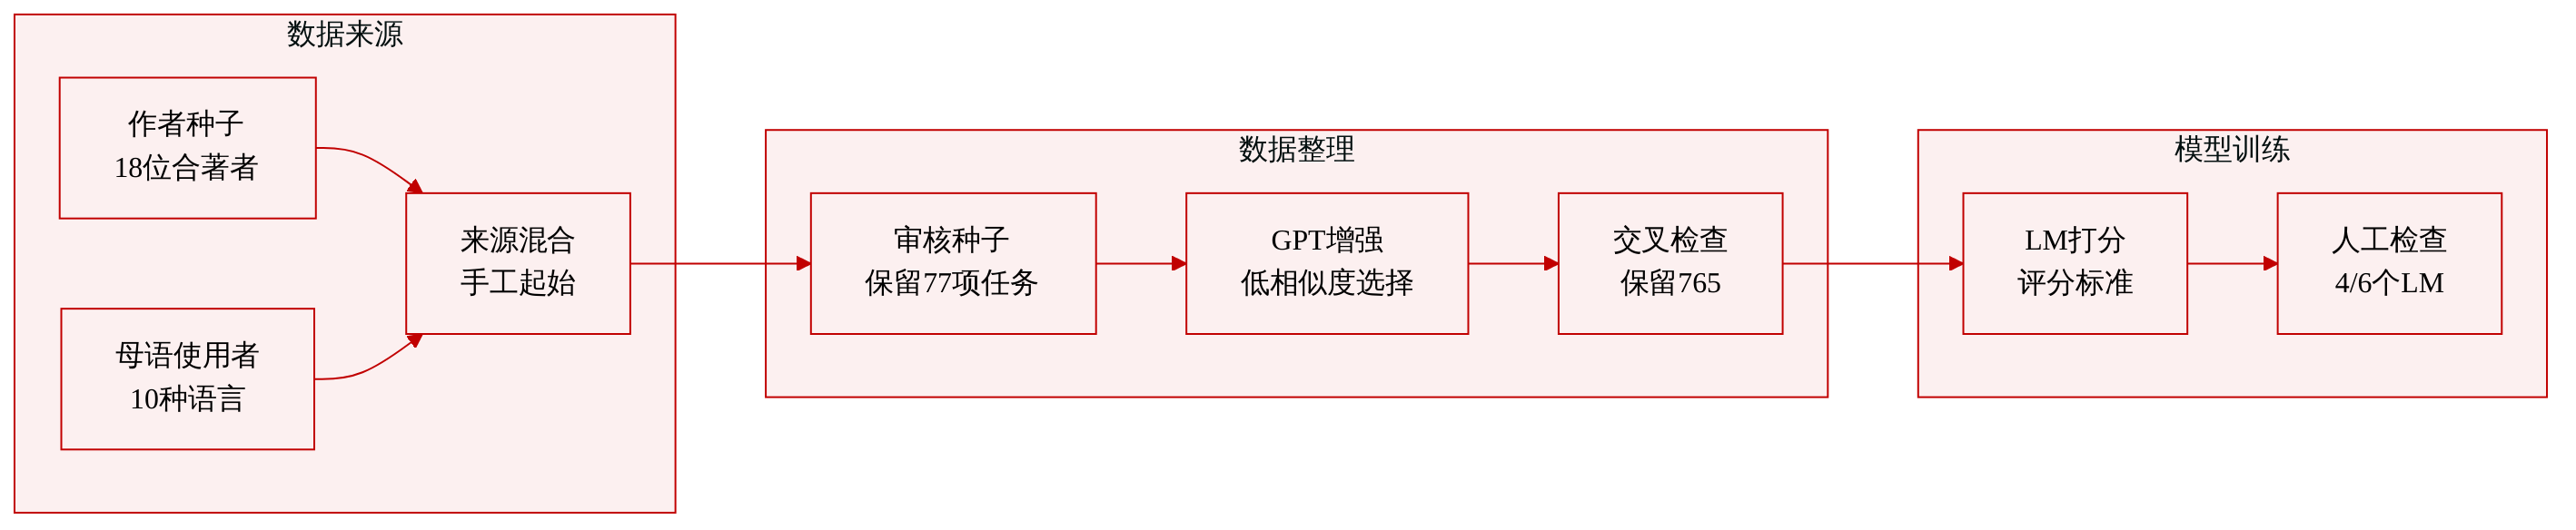
作者提出 BiGGEN Bench,作为面向生成任务的评估基准,并按能力、任务、实例和评估标准的层级组织。最终数据集包含 9 项能力、77 项任务和 765 个实例。
-
手工整理的种子子集:初始数据由人工标注。十八位共同作者每人贡献一项能力,在五项任务上创建实例,同时十位分别以韩语、哈萨克语、孟加拉语、西班牙语、印度尼西亚语、德语、法语、阿拉伯语、俄语和泰语为母语者贡献多语言实例。在审阅语法、流畅度和任务难度后,作者移除了 23 项任务,保留 77 项任务和 385 个实例。
-
增强子集:作者使用 GPT-4-0125 扩展种子数据,并采用人工撰写的示例作为上下文内演示,而不是零样本生成。对于每个新实例,生成五个候选输出,选择 BertScore 语义相似度最低的候选,并将选择步骤重复五次。质量校验会修订或丢弃较弱示例,使数据集增加到覆盖 77 项任务的 770 个实例。
-
交叉验证后的最终子集:每位共同作者审阅其未标注的两项能力、十项任务和五十个实例。被一位标注者标记的实例会被修订;被两位标注者确认为错配或参考答案与评分细则质量较差的实例会被移除。这一过滤移除了五个实例,得到最终 765 个实例。
-
元数据与 schema:每个实例都关联一项能力、一项任务和实例特定评估标准,包括用于给生成回复打分的参考答案或评分细则。该论文没有描述视觉裁剪策略,因为该基准面向文本生成。
-
论文中的用途:该数据集用于基准评估,而非模型训练。论文没有报告训练划分或混合比例。评估用语言模型使用该基准的标准为模型回复打分,并且针对选定回复收集人类判断,其中包括四个 LM,以及多语言能力下的六个 LM,用于验证评估器可靠性。
方法
BIGGEN BENCH 的构建遵循一条可控的自顶向下流水线,并按能力、任务、实例和评估标准的层级组织。该结构让每个提示和预期输出都绑定到目标生成能力,而实例特定的参考答案和评分细则支持细粒度评估。
第一阶段依赖专家撰写的种子数据。作者利用十八位共同作者,在多项能力上创建任务特定实例,并由额外母语者支持多语言任务。任务先被起草,随后通过协作讨论完善,最后审查语法、流畅度和挑战水平。包含令人困惑或难度不足实例的任务会被移除。这会形成一套人工撰写、经过精心挑选的种子实例,作为后续扩展的质量基线。
第二阶段通过 LLM 辅助增强扩展种子集。作者使用 GPT-4-0125 生成额外实例,但不是以零样本方式生成新提示。相反,每个任务中人工撰写的示例被用作上下文内演示,从而保持任务格式、预期推理风格和评估语义。为了促进多样性,该流水线为每个新提示采样五个候选实例,并选择与现有实例语义相似度最低的候选,相似度度量使用 BertScore。该候选过滤步骤会重复执行,最终得到更大的实例池,这些实例语义多样但仍与任务对齐。
第三阶段对增强后的实例池进行人工交叉验证。评估者审阅其最初未撰写的实例,并判断实例是否符合其所属任务、难度如何、参考答案是否可接受,以及评分细则是否可用。交叉验证结果总结如下:
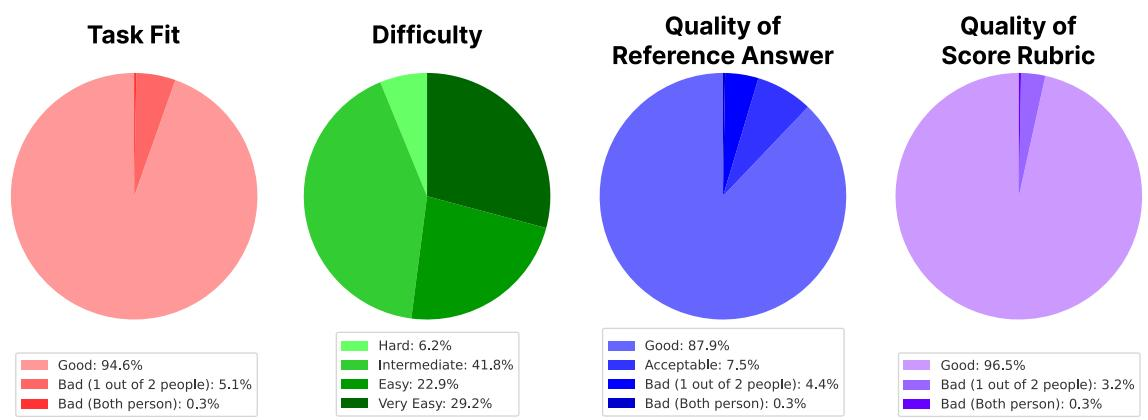
作者采用保守的过滤策略。如果两位评估者都判断某实例不合格,则将其移除。如果只有一位评估者标记问题,则该实例会被迭代修订,而不是直接丢弃。这一过程移除错配提示以及存在缺陷的参考答案或评分细则,在最终基准发布前提高可靠性。
最后阶段收集人类对模型回复的判断,以验证评估协议。人工标注者按照基准评分细则,为选定大语言模型产生的回复打分。人工评估采用分阶段流程,包括招募、资格认证和主要评估阶段,以提高评分者一致性。这些人工分数提供了校准信号,用于评估自动化评估用 LM 能否产生准确且稳定的模型比较。
实验
实验使用直接的 LM-as-a-judge 打分,对 103 个语言模型评估 BIGGEN BENCH,并检验性能如何随模型规模、训练阶段和模型类型扩展。基座模型表现出更平滑的规模收益,而聊天模型更依赖参数数量之外的后续训练因素,随着模型变大,基座模型与聊天模型之间的性能差距会缩小。额外验证实验表明,评估用语言模型,尤其是通过多数投票组合时,与人类判断存在合理相关性,并且实例特定的细粒度评分细则能够提高评估准确率,同时很大程度上避免冗长偏差。
较大的基座语言模型在各项能力上往往于对数尺度上得到更高分,平均性能与此表现出相对较强的关系。聊天模型也显示正向扩展,但与参数数量的关联较弱,表明其他因素会影响后续训练后的行为。在 grounding、指令遵循、规划、推理、回复优化、安全、心智理论和工具使用等能力层级,趋势大多为正。基座模型比聊天模型表现出更清晰的规模与性能关系。聊天模型分数随规模上升,但可预测性弱于基座模型分数。心智理论和工具使用被纳入规模分析,相关评估说明显示这些能力的人类一致性较低。
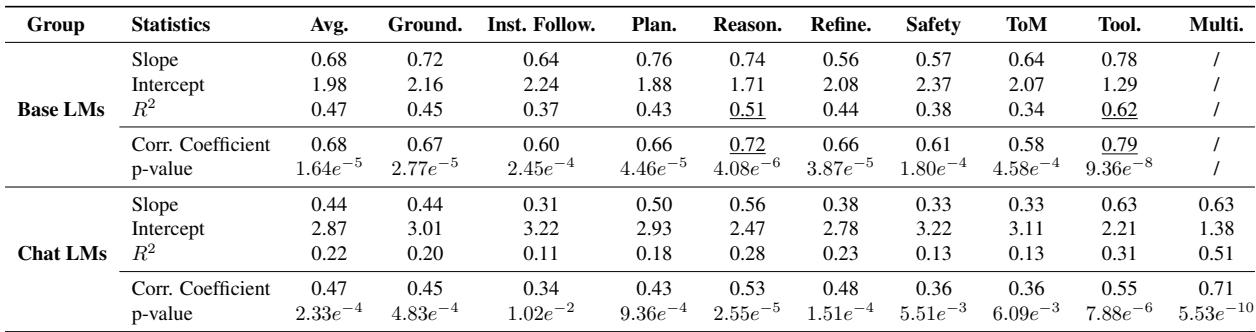
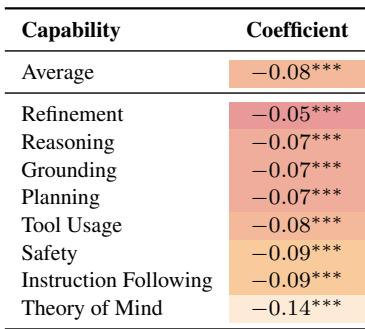
所列全部能力系数都具有统计显著性且为负,说明聊天模型组与基座模型组的交互以及参数规模会系统地影响性能。这一趋势与“更大的模型会缩小、但不一定完全消除基座 LM 与聊天 LM 之间差距”的发现一致。颜色越深表示某些能力差距即使随着参数规模增加仍可能保持较大。在所列能力中,回复优化的负向交互最小,而安全的负向交互最大。因此,参数扩展整体上缩小了基座模型与聊天模型之间的性能差异,但作用强度随能力不同而变化。
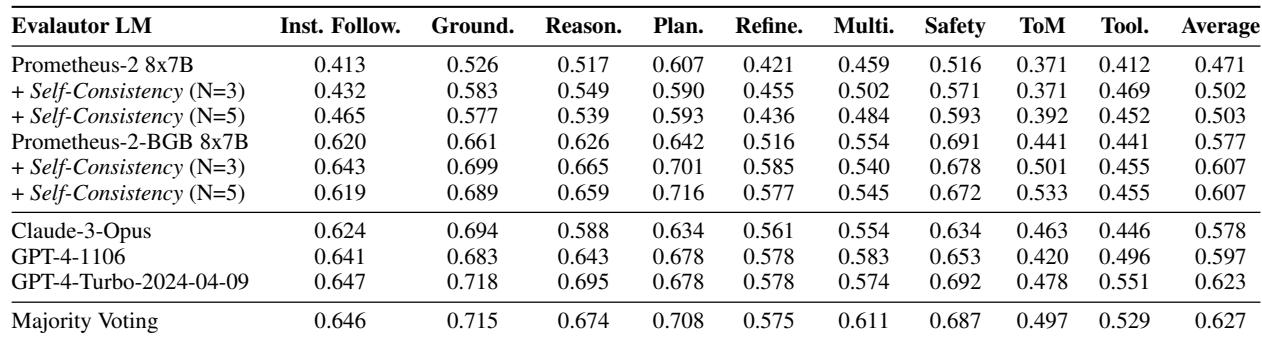
评估用语言模型在多项能力上表现出可量化的人类判断一致性,其中 GPT-4-Turbo 和多数投票集成具有最强的整体一致性。Prometheus-2-BGB 8x7B 表现接近专有评估模型,而自一致性解码可以提高一致性。心智理论和工具使用相关性仍相对弱于其他能力领域。开源 Prometheus-2-BGB 在与人类评分一致性方面可与专有评估 LM 竞争。自一致性解码会提高一致性,尤其在 Prometheus-2 系列上。心智理论和工具使用判断与人类评分的相关性弱于其他能力。
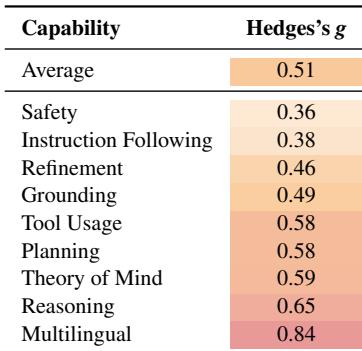
专有语言模型总体上展现出相对开源模型更大的能力优势,平均差距对应中等效应量。该差距在不同能力上并不均匀,在工具使用和规划上更明显,而在安全和指令遵循上较小。这表明开源模型在某些核心能力上相对更接近专有模型,在其他能力上则相对较远。在测量能力上,专有模型通常优于开源模型。这一优势在工具使用和规划上尤其明显。专有模型与开源模型之间在安全和指令遵循上的差距相对较小。
实验考察基座模型与聊天模型之间的能力扩展、评估用语言模型与人类判断的一致性,以及专有系统与开源系统之间的性能差距。更大的模型通常在各能力上都有提升,其中基座模型比聊天模型表现出更清晰的扩展趋势;参数增长会缩小基座模型与聊天模型之间的差异,但并未完全消除这些差异,尤其是在安全和回复优化等能力上。评估模型与人类评分的一致性较好,尤其是较强的专有评估模型、集成方法以及开源 Prometheus-2 变体;不过心智理论和工具使用判断仍较不一致。专有模型总体上也优于开源模型,工具使用和规划上的差距大于安全和指令遵循上的差距。