Command Palette
Search for a command to run...
你的基准测试是否具有真正的对抗性?ADVSCORE:基于人类感知的对抗性评估
你的基准测试是否具有真正的对抗性?ADVSCORE:基于人类感知的对抗性评估
Yoo Yeon Sung Maharshi Gor Eve Fleisig Ishani Mondal Jordan Boyd-Graber
摘要
对抗性数据集应当通过提供人类表现良好而模型表现不佳的样本来验证 AI 的鲁棒性。然而,随着模型的演进,数据集可能变得过时。由于缺乏衡量对抗性的标准化指标,评估数据集是否仍具有对抗性面临困难。我们提出了 ADVSCORE,这是一种基于人类感知的评估指标,通过捕捉模型与人类之间的能力差异来评估数据集的对抗性,同时识别低质量样本。进而,我们利用 ADVSCORE 引导构建面向真实且高质量对抗样本的新数据集生成流程,从而收集了一个对抗性问答(QA)数据集 ADVQA。我们利用 9,347 份人类回答和十个语言模型的预测结果应用 ADVSCORE,以追踪模型在五年(2020–2024)间的性能提升。因此,ADVSCORE 为实现与人类能力相当的鲁棒性提供了指导。此外,它有助于判断对抗性数据集在多大程度上仍能构成挑战,确保数据集有效测试模型能力,而非反映过时或过于人为的困难。
一句话总结
马里兰大学和加州大学伯克利分校提出 ADVSCORE,这是一个以人类表现为参照的指标,通过捕捉人类与模型之间的性能差距来量化对抗性,从而能够构建逼真的对抗性问答数据集 ADVQA,并追踪基准测试随着模型在五年间持续改进是否仍然具有挑战性。
核心贡献
-
ADVSCORE 是一个以人类表现为参照的指标,基于项目反应理论构建,通过捕捉不同的人类和语言模型能力并识别劣质样本,为数据集和示例的对抗性与区分度打分。
-
采用人在环、由 ADVSCORE 驱动的创建流程来生成 ADVQA,这是一个由逼真、高质量对抗性问题组成的问答基准,旨在在不同模型和人类技能水平之间保持区分能力。
-
使用 9,347 份人类回答以及来自 2020 年至 2024 年的十个语言模型预测开展实验,结果显示,ADVQA 的对抗性下降幅度小于其他对抗性基准,并且包括 GPT4 在内的当前模型仍在常识推理、多步推理以及 Lifestyle 等主题上表现吃力。
引言
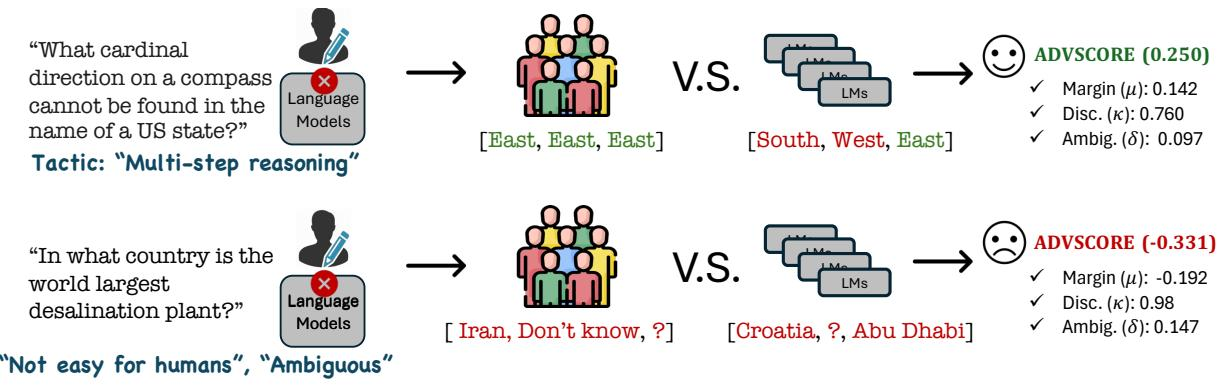
当语言模型在标准基准测试上接近高分时,需要对抗性数据集来暴露安全、常识推理和多步推理方面的弱点。以往工作通常依赖固定、人工撰写或经过合成放大的示例,这些示例可能过时、含糊不清或带有偏差,而现有评估方法并未系统衡量数据集是否仍能捕捉人类与模型之间的能力差距。作者利用项目反应理论提出 ADVSCORE,该指标从人类回答中量化对抗性,同时惩罚定义不清的题项,并通过区分度来评估用于排序模型能力的效果。作者将这一框架用于构建 ADVQA,这是一个人在环的对抗性问题基准,旨在保留当前模型仍弱于人类的真实且具挑战性的任务。
数据集
-
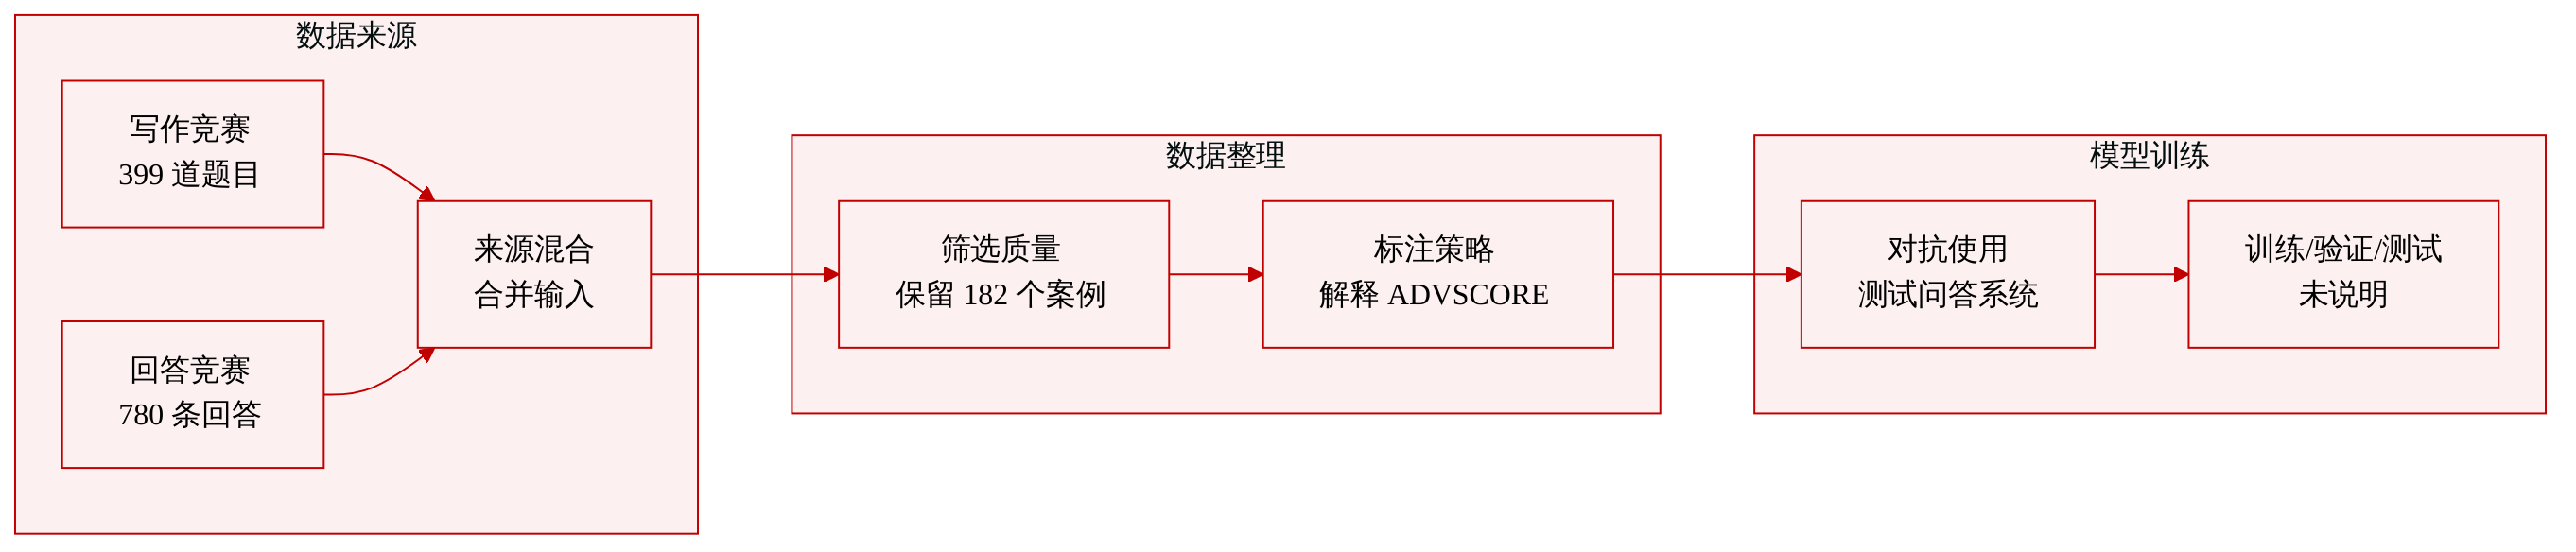
作者将 ADVQA 构建为人工创作的对抗性问答数据集,而不是自动生成的模型攻击数据集。它来自两项对抗性比赛:一个问题写作比赛和一个回答比赛。
-
写作比赛产出 399 个对抗性问题。熟练的作者使用对抗性界面,同时查看目标答案对应的维基百科页面。界面会显示实时检索和问答反馈,因此作者可以修改模型能够正确回答的问题。
-
回答比赛产出来自八个专家冷知识小组的 780 份人类回答,每个小组由三到四名冷知识专家组成。作者组织了八场人类对阵模型的问答锦标赛,每场初始包含 30 个问题。
-
在锦标赛筛选后,根据专家评论(例如识别定义不清的问题),最终 ADVQA 数据集包含 182 个问题。
-
在写作期间,反馈循环使用按句子索引的维基百科页面和轻量级检索模型,具体包括 TFIDF 基线和 DPR。基于 SQuAD 微调的 RoBerta FarmReader 模型按相关性对检索到的句子排序。基于 SQuAD 微调的 DistilBERT 提供抽取式问答预测,T5 提供闭卷答案预测。
-
这些模型组件用于数据集构建和作者引导。所提供的文本并未说明用于下游模型使用的最终裁剪策略、训练划分、验证划分、混合比例或训练 schema。
-
筛选旨在实现逼真的对抗性质量。当问题暴露真实模型弱点时才会保留,例如难以组织线索或排除冗余线索所暴露的弱点,而不是因语法错误等轻微问题导致的失败。编辑者和锦标赛答题者会帮助排除不自然或含糊的问题。
-
作者还标注对抗性策略和主题,并将其与 ADVSCORE 关联。这有助于解释为什么有些问题具有强对抗性,例如生活方式主题上的常识知识问题。
-
论文主要将 ADVQA 用作问答系统的对抗性评估数据集。人类回答被视为重要的评估信号,因为它们捕捉了多样化的人类推理,并使基准比纯模型生成的对抗性数据更逼真。
方法
作者利用一条名为 ADVSCORE 的心理计量评估流程来评估问答数据集的对抗性和信息量。该流程的核心是一个项目反应理论模型,用于估计答题者和题项的潜在参数。随后,这些参数用于构建两个主要指标:对抗性,用于捕捉成形良好的问题是否对熟练模型比熟练人类更难;区分度,用于捕捉问题是否有效区分不同技能水平的答题者。
基于 IRT 的答题者和题项建模
该方法将问答任务视为答题者与题项之间的交互,其中答题者可以是人类或语言模型。每个答题者具有一个潜在技能参数,每个问题具有潜在的难度和区分度参数。作者使用双参数逻辑 IRT 模型估计答题者 i 正确回答问题 j 的概率。
响应概率建模如下:
p(rij=1∣βi,θj,γj)=σ(γj(βi−θj))其中,βi 是答题者 i 的技能,θj 是问题 j 的难度,γj 是问题 j 的区分度,σ 是 sigmoid 函数。项 (βi−θj) 被解释为答题者与问题之间的技能差距。当答题者的技能等于问题难度时,预测正确率为 0.5。较大的正技能差距会产生更高的正确回答概率。
参数 γj 控制概率曲线对技能差距变化的敏感度。较高的 γj 意味着正确回答该问题强烈取决于答题者是否具备足够技能。较低的 γj 意味着回答对技能的提示较弱,这可能发生在问题含糊、定义不清或由猜测主导时。
IRT 拟合过程通过最大化观测到的正确回答似然来估计 βi、θj 和 γj。实际上,模型学习哪些问题对大多数答题者困难、哪些问题以依赖答题者技能的方式产生正确回答、以及哪些答题者具备与观测回答模式一致的技能。
这一公式比简单的问题成功率提供了更细致的视角。一个问题被一半答题者正确回答,可能因为它困难但定义良好,也可能因为它含糊或措辞不佳。IRT 可以区分这些情况,因为它考虑了每个问题由哪些答题者回答。如果高技能答题者往往正确回答而低技能答题者往往失败,模型会给该问题较高区分度。如果正确率与技能看似不相关,模型会给该问题较低区分度。
量化对抗性
当熟练人类比熟练模型更常正确回答问题,并且问题本身成形良好时,作者将问题定义为对抗性。为了衡量这一点,他们使用拟合得到的 IRT 参数来计算代表性人类答题者和模型答题者的预测正确概率。
首先,他们基于答题者技能的统计阈值定义熟练群体。对于一组答题者 S,水平为 k 的熟练群体由技能至少超过平均技能 k 个标准差的答题者组成:
βi>μβS+kτβS群体 g 的代表性技能定义为其成员技能的期望值:
β∗g=Eβi∼g[βi]主要对抗性计算使用 k=0,对应于在各自答题者池内平均技能水平之上的答题者。作者将熟练人类指定为 H(0),将熟练模型指定为 M(0)。对于每个问题 j,他们计算性能差距:
μj=σ2pl(β∗H(0),θj,γj)−σ2pl(β∗M(0),θj,γj)在该表达式中,σ2pl(β,θ,γ) 是使用代表性技能 β、问题难度 θj 和问题区分度 γj 的 2PL IRT 响应函数。
μj 的正值表示代表性熟练人类比代表性熟练模型更有可能正确回答问题 j。在其他条件均为定义良好的情况下,正差距越大,该问题被认为越具对抗性。
对含糊问题进行折扣
原始差距 μj 捕捉了人类与模型之间的差距,但本身不能保证人类优势来自真正的问题难度。如果人类和模型对问题解释不同,或专家人类对正确答案意见不一致,含糊或定义不清的问题也可能产生较大差距。为了惩罚这类情况,作者引入一种基于分歧的折扣。
他们将高技能或专家人类群体定义为 H(1),即技能至少高于人类平均技能一个标准差的人类。对于每个问题,他们使用这些专家人类预测正确率的平均偏差来计算其分歧程度:
δj=i∼H(1)MD[σ2pl(βiH(1),θj,γj)]调整后的对抗性分数随后为:
μj′=1+δjμj当专家人类表现出更高分歧时,这一折扣项会降低对抗性分数。因此,即使有些问题最初看起来会造成较大的人类与模型性能差距,只要它们含糊、定义不清或对解释敏感,也会受到惩罚。这使得指标更忠实于真实对抗质量,因为有用的对抗性数据集应包含有挑战性的问题,而不是仅仅令人困惑的问题。
衡量区分度
作者还衡量一个问题是否有助于区分答题者技能水平。他们通过 2PL IRT 响应函数的 Fisher 信息来定义区分度。
对于问题 j,项目信息函数为:
IIFj(θ)=γj2⋅pj(θ)⋅(1−pj(θ))其中
pj(θ)=σ2pl(θ,θj,γj)项目信息函数量化一个问题在多大程度上为答题者技能 θ 提供统计信息。当问题具有较高区分度(由较大的 γj 表示),并且其难度处于中等水平、即预测正确率接近 0.5 时,该问题提供的信息最多。在该区域,改变答题者技能水平会显著影响响应概率,因此该问题能有效区分较强和较弱的答题者。
为了得到单个标量区分度分数,作者在整个技能范围上对项目信息函数积分:
TIFj=∫−∞∞IIFj(θ)dθ随后,这一总项目信息量通过指数归一化映射为有界区分度分数:
κj=1−exp(−TIFj)得到的 κj 是经过校准的度量,表示问题 j 在多大程度上区分不同技能水平的答题者。数值越高,表示该问题对答题者能力提供的信息越多。
合并对抗性与区分度
单个问题的最终 ADVSCORE 将经过含糊度折扣的对抗性差距与区分度奖励相结合:
ADVSCOREj=1+δjμj⋅(1+κj)这一设计使人类与模型之间的性能差距成为分数的主要驱动因素,而区分度作为乘法奖励。只有中等区分度的问题仍然依赖正的人类与模型差距才能获得有意义的分数。显示较大差距但区分度低,或专家人类意见含糊不一致的问题会受到惩罚。既具对抗性又具信息量的问题获得最高分数。
对于数据集,作者将数据集级 ADVSCORE 定义为问题级 ADVSCORE 的平均值。这将单个问题的质量聚合为数据集级指标。更高的数据集分数表明数据集中包含更多定义良好的问题,熟练人类在这些问题上优于熟练模型,并且这些问题为答题者技能提供了有用信号。
ADVQA 创建流程
作者还提出一个数据集创建流程,将 ADVSCORE 逻辑用作引导。该流程围绕对抗性比赛构建,其中人类尝试撰写对模型构成挑战的问题,同时保持清晰且可回答。
创建过程包括两个主要阶段:写作比赛和回答比赛。
在写作比赛中,人类作者提交问答对,意图使问题对模型困难但人类可以解决。提交的问题不会直接接受。相反,专家编辑会审阅、编辑和筛选问题,以提高可回答性并减少含糊性。编辑阶段非常重要,因为对抗性问题很容易变得含糊、不公平,或依赖特殊措辞。人类专家评审有助于保留真正具有挑战性的问题,而不是意外出错的问题。
在回答比赛中,人类专家对阵模型系统回答收集到的问题。作者组织人类对阵模型的锦标赛,收集人类回答,然后基于专家反馈筛选问题集。被识别为定义不清、含糊或存在其他问题的答案会被移除。最终保留的问题集因此反映了将人类对抗性写作与事后专家验证相结合的工作流。
作者还将 ADVSCORE 本身用作奖励信号。根据作者问题获得的 ADVSCORE 对作者进行激励,这鼓励作者生成不仅对模型困难、而且清晰、具区分度并符合人类判断的问题。回答比赛中的参与者基于展示出的技能获得激励,这有助于识别其回答对 IRT 拟合具有信息量的答题者。
对抗性写作界面
写作过程由交互式界面支持,该界面将问题创作变成人类与 AI 的对抗循环。界面会实时反馈检索和问答模型如何响应作者的草稿问题。这让作者能够修改使问题对模型过于容易的措辞,并删除无意间透露答案的表达。
该界面围绕目标答案展开。作者基于目标答案的参考页面开展工作,并构建一个预期答案已知的问题。当作者输入时,系统持续更新多个模型组件。
检索组件显示问题是否检索到包含目标答案的段落或句子。如果目标答案出现在检索结果靠前的位置,该问题可能让检索增强型问答系统容易回答,因此作者会被提示重新表述。流程包括轻量级稀疏检索组件和神经稠密检索组件。为了支持快速反馈,系统从受控的维基百科页面集合中按句子级段落建立索引。随后,检索到的句子被传递给读者模型,由该模型按相关性评分并排序。这个检索器读者循环近似模拟现代开放域问答系统处理作者问题的方式。
该界面还包括模型预测组件。对于抽取式问答,一个轻量级微调语言模型用于从检索到的上下文中预测答案跨度。对于闭卷或生成式设置,一个较大的序列到序列模型用于直接回答问题。这些预测帮助作者看到模型是否能在没有检索段落显式支持的情况下推断出目标答案。
此外,界面会高亮问题内部的输入扰动。系统识别 tokens 或短语,其替换特别可能改变模型预测。这引导作者进行最小化措辞修改,在不改变预期问题的情况下降低模型成功率。例如,如果某个词强烈提示模型走向正确答案,作者可以替换或重构该词,同时保留问题的事实意图。
筛选与质量控制
筛选在流程中的多个点发生。在写作比赛中,专家编辑重写或移除低质量的对抗性问题。在回答比赛中,专家人类小组提供评论,帮助识别定义不清或不公平的问题。具有含糊解释或可回答性存疑的问题会从最终数据集中排除。
这一工作流将对分生成、心理计量评估和人类验证结合起来。界面鼓励作者针对检索和阅读系统的弱点生成问题,而专家筛选确保保留的问题仍然可由人类回答,而不是病态意义上的对抗性问题。随后,ADVSCORE 量化最终数据集是否成功平衡这两个目标。
实验
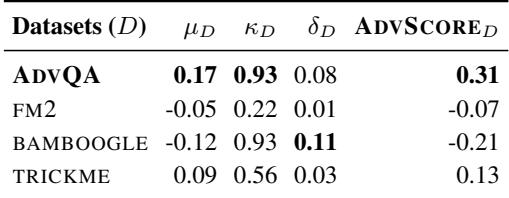
研究人员收集人类和模型在多个对抗性基准上的回答,包括 ADVQA、TRICKME、FM2 和 BAMBOOGLE,并应用项目反应理论评估人类与模型能力之间的分离程度,以此评估 ADVSCORE。实验表明,ADVQA 通过将有意义的人类对阵模型差距与具区分度的问题设计相结合,最能捕捉真正对抗性问题;TRICKME 具有对抗性但信息量较少;FM2 和 BAMBOOGLE 往往未能作为对抗性基准有效运作。时间序列分析进一步显示,随着模型改进,一些基准的对抗性下降,而 ADVQA 保持最强对抗属性;整体上,ADVSCORE 提供了比简单成功率比较更可靠的评估。
ADVQA 被认为是对抗性最强的数据集,因为它兼具正向人类优势和跨技能水平的强区分能力。BAMBOOGLE 表现出可比区分能力,但人类优势为负,表明模型通常比人类更好地处理其问题;FM2 的区分能力弱,且对模型更容易。TRICKME 在对抗性上仍为正,但被描述为随时间失去强度。ADVQA 在总体对抗性上排名第一。BAMBOOGLE 能很好地区分技能水平,但更利于模型而不是人类。FM2 区分能力弱,并且对模型似乎比对人类更容易。TRICKME 不如 ADVQA 具对抗性,并显示时间下降。
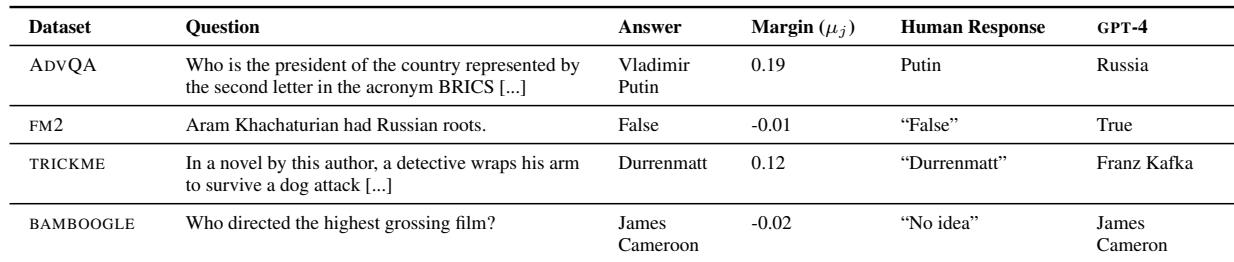
这些示例显示 ADVQA 和 TRICKME 具有正的人类与模型差距,其中人类给出正确答案,而 GPT-4 出现错误。相比之下,FM2 和 BAMBOOGLE 具有负差距,表明模型回答正确而人类没有。这支持 ADVQA 是所展示数据集中最均衡的对抗性基准。ADVQA 具有正差距,其中人类答案正确而 GPT-4 答案错误。FM2 和 BAMBOOGLE 具有负差距,表明这些示例对 GPT-4 比对人类更容易。TRICKME 也显示正差距,其中人类答案正确而 GPT-4 答案错误。
实验通过评估数据集在一段时间内区分人类与模型表现的能力来比较对抗性数据集。ADVQA 成为对抗性最强且最均衡的基准,兼具正向人类优势和强技能水平分离;TRICKME 也显示人类优势,但整体稳健性较低。BAMBOOGLE 仍具区分度,但更利于模型而不是人类;FM2 较弱,更利于模型,并且相对于人类对模型挑战更小。