Command Palette
Search for a command to run...
PeerQA:基于同行评审的科学问答数据集
PeerQA:基于同行评审的科学问答数据集
Tim Baumgärtner Ted Briscoe Iryna Gurevych
摘要
本文提出 PeerQA,一个真实场景下的科学文档级问答(QA)数据集。PeerQA 的问题来源于同行评审,即审稿人在仔细审阅科学文章时提出的问题。答案由每篇论文的原作者进行标注。该数据集包含来自 208 篇学术文章的 579 个问答对,其中大部分来自机器学习和自然语言处理领域,还包含来自地球科学和公共卫生等其他科学领域的一部分。PeerQA 支持开发实用问答系统的三项关键任务:证据检索、不可回答问题分类和答案生成。我们对所收集的数据集进行了详细分析,并为所有三项任务建立了基线系统。实验和分析表明,文档级检索需要去语境化处理,我们发现即使是简单的去语境化方法也能在所有架构中持续提升检索性能。在答案生成方面,由于论文平均长度达 12k tokens,PeerQA 为长上下文建模提供了一个具有挑战性的基准。
一句话总结
达姆施塔特工业大学、黑森人工智能中心和 MBZUAI 提出了 PeerQA,这是一个真实世界科学文档级问答数据集,包含 579 个问答对,来源于同行评审并由原始作者标注,支持证据检索、不可回答问题分类和答案生成。该数据集揭示出去语境化能够持续改进检索性能,并在平均长度为 12k tokens 的论文上建立了具有挑战性的长上下文建模基准。
核心贡献
- 论文介绍了 PeerQA,这是一个真实世界科学文档级问答数据集,包含来自 208 篇学术文章的 579 个问答对,问题来自同行评审,答案由原始作者标注,支持证据检索、不可回答问题分类和答案生成。
- 为 PeerQA 的三个任务建立了基线系统和任务分析,显示去语境化能够持续提升文档检索性能,并且可回答性模型往往存在过度回答或回答不足的问题。
- 在平均长度为 12k tokens 的论文上评估长上下文答案生成,检索排名靠前的段落通常优于全文上下文,更好的检索会带来更好的生成答案。
引言
科学论文数量指数级增长增加了文献综述负担,使从论文中提取目标信息的工具对研究人员和同行评审人员很有价值。融入阅读工作流的问答系统可以帮助读者高效定位相关证据,并减少评审中遗漏的要点。已有科学问答数据集面临主要约束:难以招募专家标注,自然出现的问题稀缺,许多现有数据集依赖模板、搜索引擎建议、非专家标注人员,或问题过于泛化、未基于特定论文。作者利用同行评审创建 PeerQA,一个真实世界文档级问答数据集,问题由评审提出,答案由论文作者标注。它支持证据检索、可回答性预测和自由形式答案生成,并发布了来自 208 篇论文的 579 个标注样本以及 12k 未标注问题,同时建立了任务基线并分析关键性能因素。
数据集
-
作者使用来自三个来源组的论文和同行评审构建 PeerQA:NLPeer、公开同行评审来源和 OpenReview。
-
NLPeer 贡献:ARR 2022、COLING 2020、ACL 2017、CoNLL 2016 和 F1000,最初在 NLPeer 中整理,并以 CC-BY-NC-SA 4.0 许可发布。
-
地球科学贡献:来自 Earth System Dynamics (ESD) 和 Earth Surface Dynamics (ESurf) 的论文和评审,以 CC-BY 4.0 许可发布。
-
OpenReview 贡献:来自 ICLR 2022/2023 和 NeurIPS Datasets and Benchmarks Track 2022 的论文和评审。这些内容未随发布包公开,因为缺少明确许可,因此作者提供了下载和处理脚本。
-
发布的问答数据以 CC-BY-NC-SA 4.0 许可发布。
-
作者使用 GROBID 0.8 处理定稿论文 PDF,以提取全文、公式、图注和段落级句子分组。这些抽取出的结构随后用于将标注证据与论文文本对齐。
-
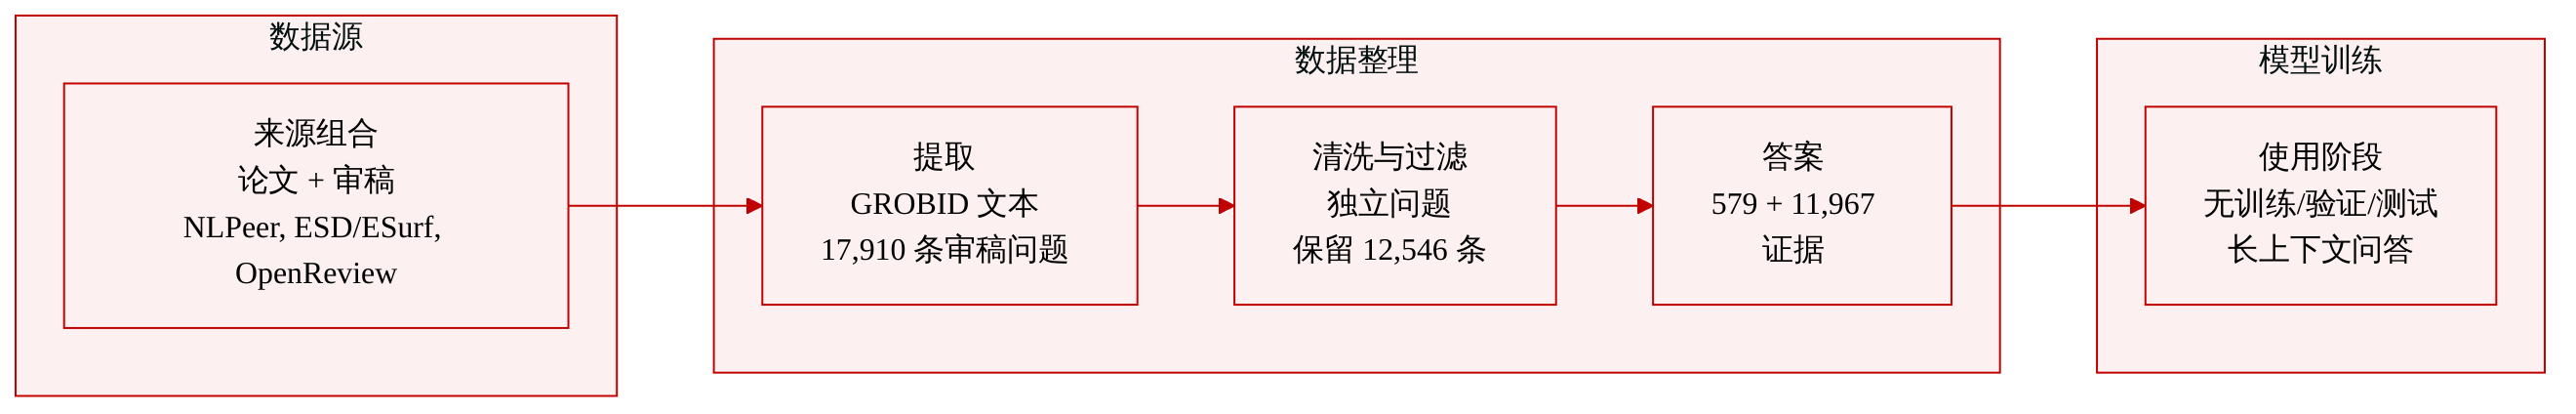
初始问题通过对同行评审中以问号结尾的句子进行自动抽取得到,产生 17,910 个候选问题。
-
作者使用 InstructGPT 清理并去语境化这些问题。作者使用前三个评审句子加上问题本身,将其改写为单个独立问题。这也能减少评审中拼写和语法错误带来的噪声。
-
为处理复合问题或追问,作者使用成分句法解析器标记包含根节点层面连接词的问题,然后使用 InstructGPT 将其分解。
-
作者手动筛选已处理的问题,只保留与论文相关的信息寻求型问题。作者移除反问式问题、拼写或排版问题、含糊问题、幻觉内容,以及引用行号或其他在定稿版本中缺失的引用内容的问题。
-
这一步手动筛选移除了初始问题的 30%,最终得到 12,546 个问题的最终池。
-
答案标注由论文作者在每篇论文的最终发布版本上进行,而不是在投稿版本上进行。作者通过邮件联系,并提供指南、任务说明和标注界面。
-
答案标注模式包含四个主要部分:
- 问题反馈,作者可以标记或修改问题。
- 答案证据,作者在最终论文 PDF 中标亮相关文本。
- 对问题的自由形式回答。
- 不可回答标记,用于问题已在反驳中得到回应但未纳入最终论文的情况。
-
有些问题只有答案证据或只有自由形式回答,而不是两者都有。
-
作者将作者高亮的证据映射回 GROBID 抽取出的论文文本。由于 GROBID 有时会遗漏对齐所需段落,作者发布原始标注数据和映射后的数据。
-
作为质量控制步骤,作者手动处理作者对问题的反馈,并更新或移除有问题的问题。
-
为减少答案质量波动,作者使用 GPT-4 生成改写版本来增强收集到的自由形式回答,同时保持原始标注意图。
-
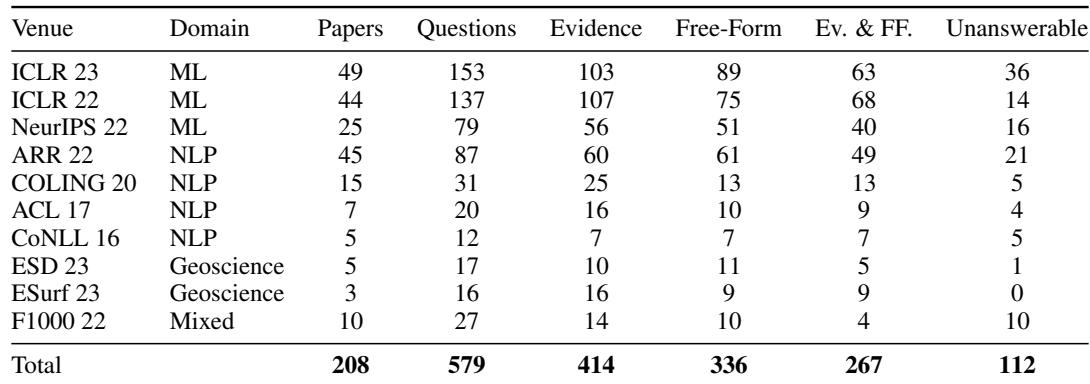
已回答子集包含来自 208 篇论文的 579 个答案。各会议的标注数量在论文表 2 中报告。
-
未回答子集包含来自 2,623 篇论文的 11,967 个问题,发布后用于支持更广泛的问题理解以及未来标注工作。
-
作者报告的关键数据集统计信息:
- 平均论文长度为 11,723 tokens。
- 平均问题长度为 20.2 tokens,长于 BioASQ、QASPER 和 QASA 中的平均问题长度。
- 已处理问题与原始评审问题仍高度相似,90% 的问题相似度高于 0.6,50% 的问题相似度高于 0.82。
- 每个问题平均有 3.8 个标注证据句子。
- 30% 的问题具有非连续答案证据,意味着证据分散在论文各处。
- 对 100 个问题的抽样显示,44% 的问题针对方法或数据澄清,12% 的问题要求为某个决定提供理由。
-
作者将该数据用作专家标注的科学问答基准。已处理的全文和段落支持基于证据支撑的问答,较长的论文使该数据集适用于长上下文模型。
-
所提供的章节描述了数据集构建、标注、质量控制和发布细节,但它们没有说明训练集划分或数据混合比例。
方法
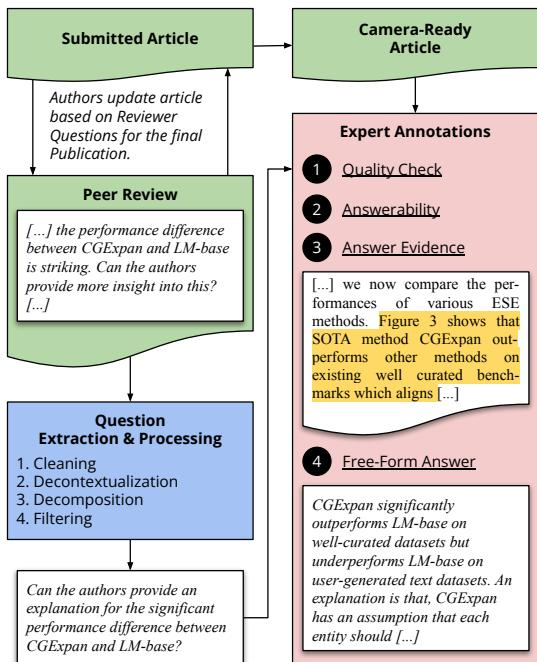
作者使用一条端到端的数据整理流水线,将原始同行评审文本转换为专家标注的文档级问答实例。该工作流连接三个输入,即投稿论文、同行评审和定稿发布版本。参见框架图。
在第一模块中,论文和评审从多个科学会议来源收集。对于每篇论文,抽取定稿版本的全文,包括公式和图注,同时将句子分组为段落,为下游证据建模保留文档结构。这为标注提供稳定文本基础。
第二模块执行问题抽取和规范化。以问号结尾的评审句子被收集为候选问题。由于原始评审问题可能含有噪声、依赖上下文或包含复合内容,作者采用修正流程。指令跟随语言模型接收前三个评审句子和抽取出的问题,然后将其改写为干净、上下文独立的查询。随后使用成分句法解析器检测根节点层面的连接词,这些连接词指示多个问题或追问,并对被标记的复合问题进行拆分。最后,手动筛选移除反问式、排版相关、含糊、错误或不相关的问题,只留下能够匹配最终论文的信息寻求型查询。
答案标注模块将原始论文作者作为专家标注者参与。由于问题来源于投稿草稿,问题是否可回答取决于相应信息是否出现在定稿论文中。作者首先验证或修改问题,然后判断问题是否可以从最终发布版本回答。如果可回答,作者在 PDF 中高亮答案证据并提供自由形式回答。不可回答情况也被允许,例如评审意见已在反驳中得到回应,但未纳入最终论文。
质量控制层在标注前后都发挥作用。作者可以通过界面提交反馈,触发对有问题问题的人工审查、修正或移除。作者还使用更强的语言模型生成改写版本来增强自由形式回答,以减少答案细节和清晰度方面的波动。为支持未来抽取改进,原始标注映射和 PDF 映射证据都会发布。
实验
实验评估单篇论文问答中的证据检索、可回答性和答案生成,使用多种检索器架构和指令微调 LLM。检索结果表明,带有标题增强的段落级检索比句子级检索更有效,并为生成提供有用证据;可回答性结果揭示了依赖模型的偏差,这些偏差倾向于预测问题可回答或不可回答。答案生成结果表明,当使用较少相关段落进行 RAG 时,通常比全文上下文效果更好,金标证据作为性能上限,更强的长上下文模型能够随着上下文长度增长保持或提升性能。
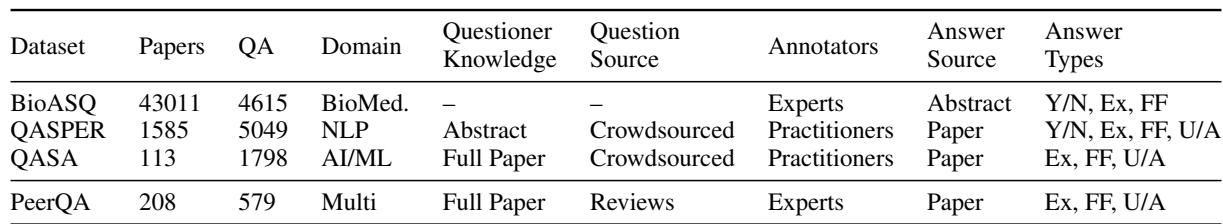
PeerQA 与已有科学问答数据集不同,它的问题来自专家同行评审,答案来自论文作者,因此形成一个小型、专家标注、多领域数据集,包含抽取式答案、自由形式答案和不可回答答案。与更大或半自动化资源相比,它包含的论文和标注更少,但标注者专业能力更强,并且具备全文问题上下文。实验表明,使用较少相关段落的检索增强生成通常比全文设置提高 LLM 答案正确性,尽管 GPT-4o 等强长上下文模型在上下文增加时仍保持更稳定。PeerQA 使用评审撰写的问题和作者提供的答案,将监督信号建立在专家来源之上。它比若干更广泛的科学问答数据集更小,但保留了自由形式答案和不可回答答案类型。大多数被评估的 LLM 在获得检索到的相关上下文时表现优于使用全文文本。
PeerQA 从多个机器学习和 NLP 会议收集问答对,包括较新的 ML 会议和较早的 NLP 活动。不同会议在获得证据标注和自由形式答案标注的问题数量上存在差异,证据覆盖在各会议中总体存在,而自由形式答案覆盖变化更大。每个会议中都有部分问题不可回答,因为论文未提供足够信息。机器学习会议贡献的收集问题数量多于所展示的较小 NLP 会议,证据标注在各会议中较为常见,而自由形式答案覆盖因会议而异。每个列出的会议都包含一部分无法根据可用论文信息回答的问题。
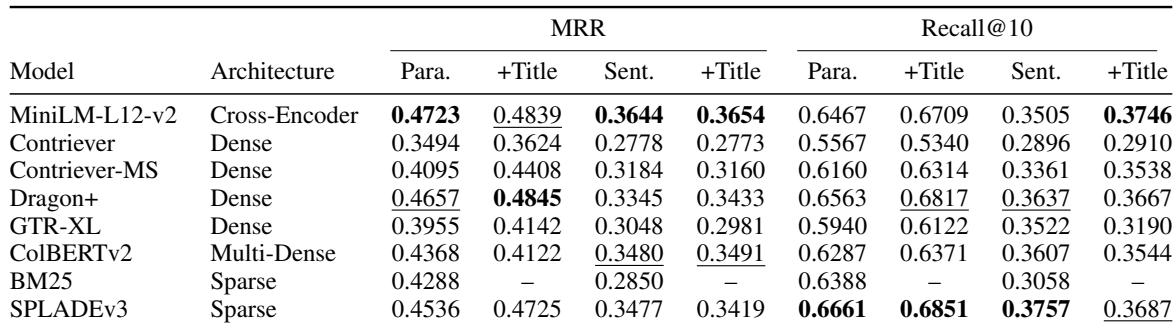
段落级检索在答案证据方面通常优于句子级检索,并且为段落添加论文标题会进一步提升大多数模型的性能。标题前置对句子级分数影响较小,原因可能是标题会扭曲短句子表示。最强模型是 MiniLM-L12-v2、Dragon+ 和 SPLADEv3,其中 SPLADEv3 因召回率较高而被选用于下游检索增强生成。检索段落比检索句子带来更高的答案证据检索质量。将论文标题前置到段落中可提升大多数模型的结果,支持对段落进行去语境化。标题前置对句子级检索影响较小,因为短文本对新增上下文更敏感。MiniLM-L12-v2、Dragon+ 和 SPLADEv3 表现最佳,SPLADEv3 因取得最高召回率而被选用于 RAG。
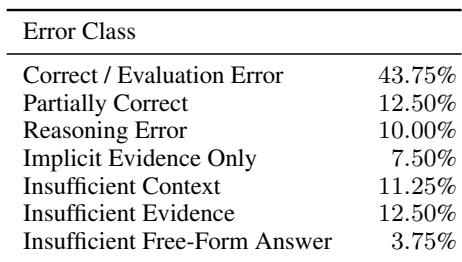
对得分最低生成结果的错误分析显示,许多情况并非真正的模型失败。这些生成结果中有很大一部分实际上是正确的,或因评估局限而被扣分,例如冗长表述或替代表述。其余错误包括部分正确、基于证据的错误推理、上下文或证据不足,或自由形式参考答案存在问题。正确回答或评估相关问题占低分生成结果的最大比例。当模型遗漏重要细节或得出相反结论时,会出现部分正确和推理错误。较少一部分错误来自上下文不足、证据不足或自由形式回答不充分。
实验评估了 PeerQA,这是一个基于同行评审问题和作者答案构建的专家标注科学问答数据集,通过比较不同论文上下文下的检索粒度、检索模型和检索增强生成来考察性能。结果表明,带论文标题的段落级检索通常优于句子级检索,SPLADEv3 因召回率强而被选用;向 LLM 提供较少相关段落通常比提供全文产生更正确答案,尽管长上下文模型仍保持相对稳定。错误分析表明,许多低分输出是评估产物而非真正失败,真正错误主要涉及不完整推理或证据不足。