Command Palette
Search for a command to run...
ACCORD:弥合常识可测量性差距
ACCORD:弥合常识可测量性差距
François Roewer-Després Jinyue Feng Zining Zhu Frank Rudzicz
摘要
我们提出了 ACCORD,这是一个通过受控多跳反事实来解耦大语言模型(LLMs)常识接地能力与推理能力的框架及基准测试套件。ACCORD 为常识推理引入了形式化要素,以显式控制和量化超越典型 1 跳或 2 跳之外的推理复杂度。其独特之处在于,ACCORD 能够自动生成任意推理复杂度的基准,从而随未来 LLM 的进步而持续扩展。事实上,我们在前沿 LLM 上的实验表明,仅需适度扩展复杂度,模型性能即会降至随机猜测以下,这为后续改进留下了巨大的提升空间。我们发布了本工作所测基准套件的排行榜¹,以及用于自动生成更复杂基准的代码²。
一句话总结
来自多伦多大学、史蒂文斯理工学院、戴尔豪斯大学和 Vector Institute 的研究人员提出 ACCORD,一个框架和基准套件,它引入形式化要素,用于将 LLM 中的常识锚定与推理区分开,并支持自动生成具有任意推理复杂度的多跳反事实基准,使其随模型改进而扩展。
核心贡献
-
ACCORD 是一个框架和基准套件,使用可控的多跳反事实样例,以将 LLM 中的常识锚定与推理区分开来。它引入形式化要素,控制推理复杂度、推理技能和干扰项,从而超越仅涉及一两跳的评测限制。
-
ACCORD 包含一个反实际基准生成器,可从手写配对模板中生成任意数量的多跳实例。该生成器使用树复制来降低词汇匹配偏差,并以最少额外人工成本,使基准难度随未来模型改进而扩展。
-
在 ACCORD_CSQA(ACCORD 应用于 CSQA 的一个实例)上的实验显示,最先进 LLM 的性能在适度复杂度提升时退化到随机水平,并揭示出事实性任务与反实际任务性能之间的显著差距。论文发布了排行榜以及用于生成更复杂基准的代码。
引言
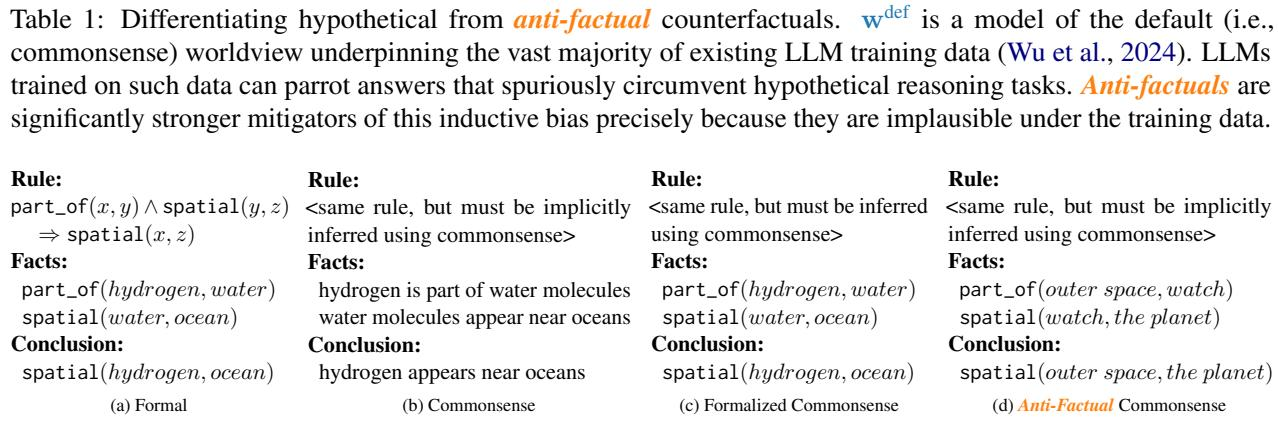
LLM 越来越多地用于推理,并作为参数化知识库,但其表观推理性能可能受到记忆到的世界知识的干扰,尤其是在上下文信息与训练先验冲突时。先前常识推理基准通常依赖事实性上下文,这会使模型利用参数化捷径、数据集伪影或归纳偏置,而不是真正基于给定上下文进行推理。这些基准也通常缺少逻辑或数学推理基准中常见的受控复杂度、显式技能和形式化分析。论文作者提出 ACCORD,一个用于生成反实际常识推理基准的框架。它使用不可信上下文,将上下文锚定与参数化推理区分开,并以最少额外人工成本扩展推理复杂度、技能和干扰项。
数据集
-
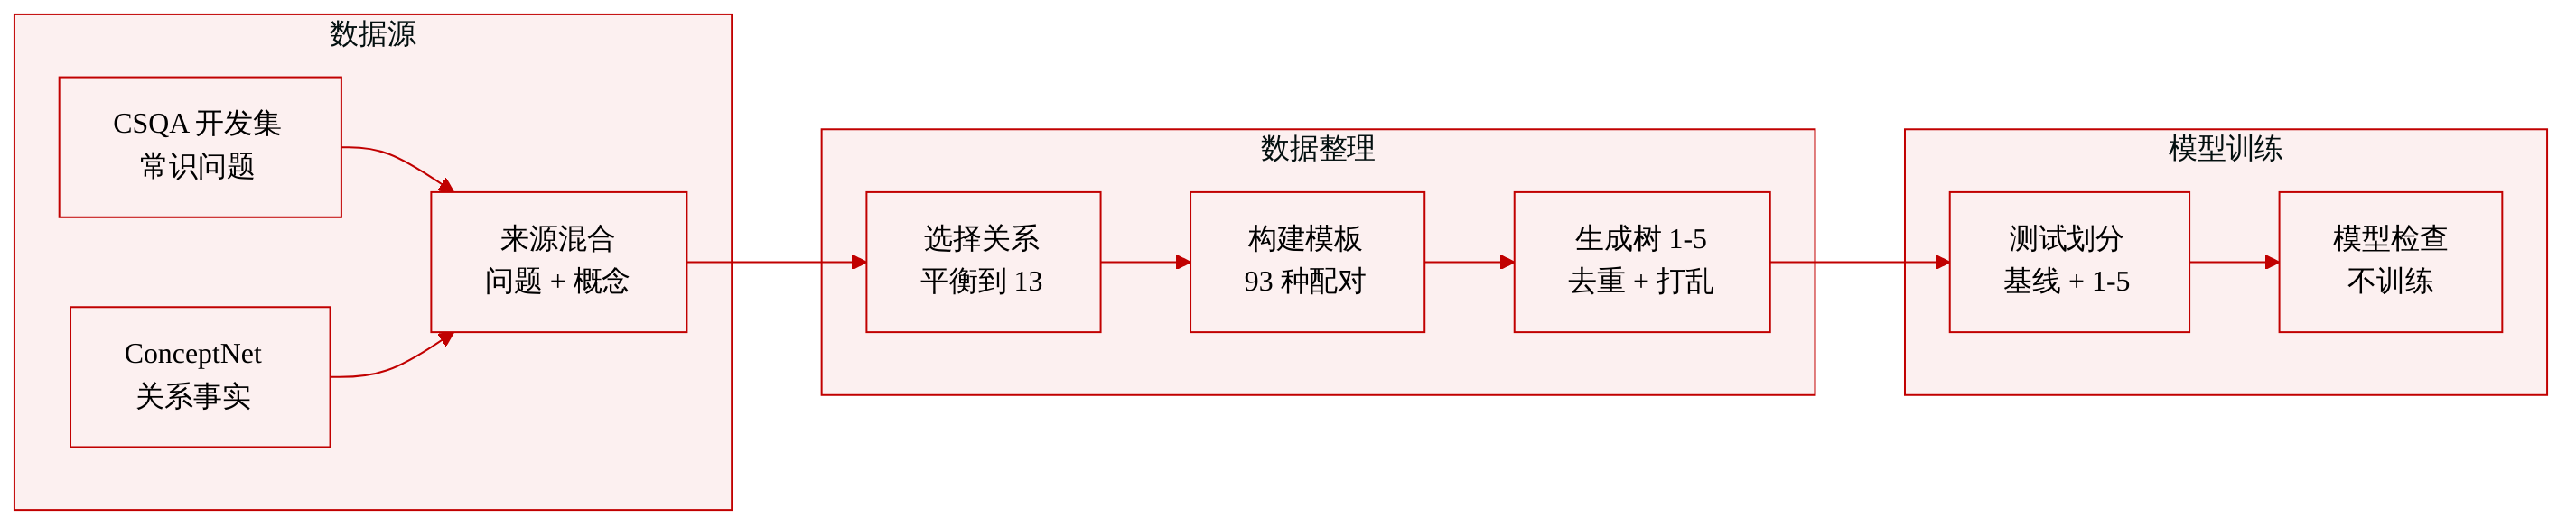
本文所描述的数据集是 ACCORD_CSQA,它是基于 CommonsenseQA 开发集和 ConceptNet 构建的基准套件。作者使用 CSQA 作为常识问题、概念和答案选项的来源,并复用 Talmor 等人手动定义的推理技能,以形式化描述常识推理模式如何被比较。
-
数据来源与构成:
- 基础样例来自 CSQA,CSQA 基于 ConceptNet。
- 论文作者通过计算将答案选项与源概念匹配的 ConceptNet 断言中的多数投票,为每个 CSQA 实例分配一个 ConceptNet 关系。
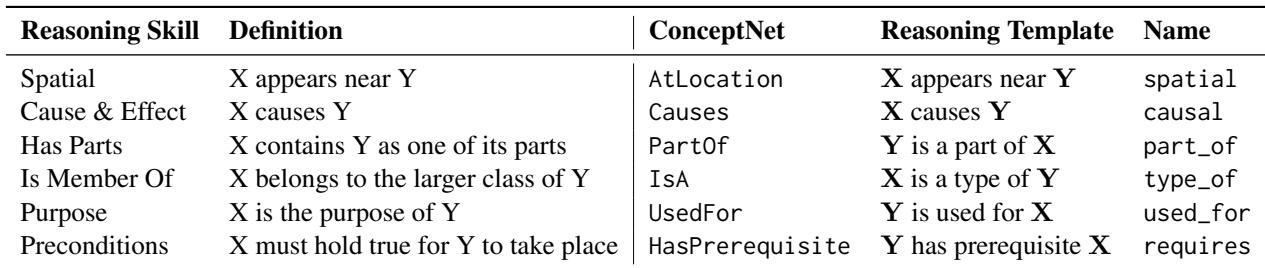
- 推理技能被转换为自然语言模板,这些模板通过占位符连接两个概念,例如物体位置关系或类型关系模式。
- 这些模板被组合成推理树,构成该数据集中使用的形式化上下文。
-
平衡子集构建:
- 推断得到的 ConceptNet 关系分布高度偏斜,某些关系出现数百次,另一些只出现数次。
- 为平衡基准,论文作者将每种关系类型随机下采样至 13 个实例。
- 在得到的 78 个关系平衡的 CSQA 实例中,有 2 个因为涉及煽动暴力而被移除,另有 2 个因为无法构建有效配对模板而被移除。
- 剩余 74 个实例构成基线 ACCORD_CSQA^0 划分。
- 手工制作的配对模板将这些基线实例扩展为 93 个配对模板,用于生成更大的推理树。
-
推理树子集:
- 论文作者生成了推理树大小为 1 到 5 的 ACCORD_CSQA 变体。
- 完整生成的套件包含 245,514 个唯一推理树,并保证每个配对至少包含 143 个唯一树。
- 为高效评估,他们通过为每个配对下采样,只保留每个唯一“推理跳数与干扰项组合”的一个树,从而构建了一个更小的基准。
- 该较小基准包含 2,864 个唯一树,并降低了对较大树尺寸的指数加权。
- 完整套件和较小基准均已发布。
-
数据集伪影控制与处理:
- 由于答案选项可能通过推理上下文与答案选项之间的词汇匹配被猜测出来,论文作者将配对树为每个答案选项复制一次。
- 这会保留每个答案选项在上下文中的出现,同时维持预期的推理任务。
- 在推理树内部和推理树之间对陈述顺序进行随机化,以降低位置偏差或近因偏差。
- 删除重复陈述,以避免模型推理偏向重复主张。
- 文中未描述图像裁剪或类似视觉数据处理;其构建过程使用文本级平衡、下采样、模板创建、树生成、陈述删除和随机化。
-
数据使用方式:
- 论文将 ACCORD_CSQA 作为评估基准,而不是将其描述为训练划分。
- ACCORD_CSQA^0 充当无上下文基线。
- ACCORD_CSQA^1 到 ACCORD_CSQA^5 通过把答案嵌入不同大小的推理树中,提供逐步增加的推理复杂度。
- 该数据集用于测试当形式化推理上下文包含多个合理关系和答案相关陈述时,LLM 能否回答常识问题。
方法
论文作者利用 ACCORD 作为一个系统性基准构建框架,用于从现有多选题事实性数据集中生成反实际常识推理实例。给定带有问题 q 和答案选项 a={a1,a2,…,aQ} 的问答实例,该框架用一个反实际上下文 Caf 增强原始题目,该上下文与一个反事实世界 waf=wdef 对齐。其目标是构造上下文,使陈述要么蕴含原始事实答案 adef,要么蕴含另一个反实际答案 aaf,同时尽可能保持底层推理结构受控。
整体流程最好通过一个具体实现来理解。请参见下面的框架图:
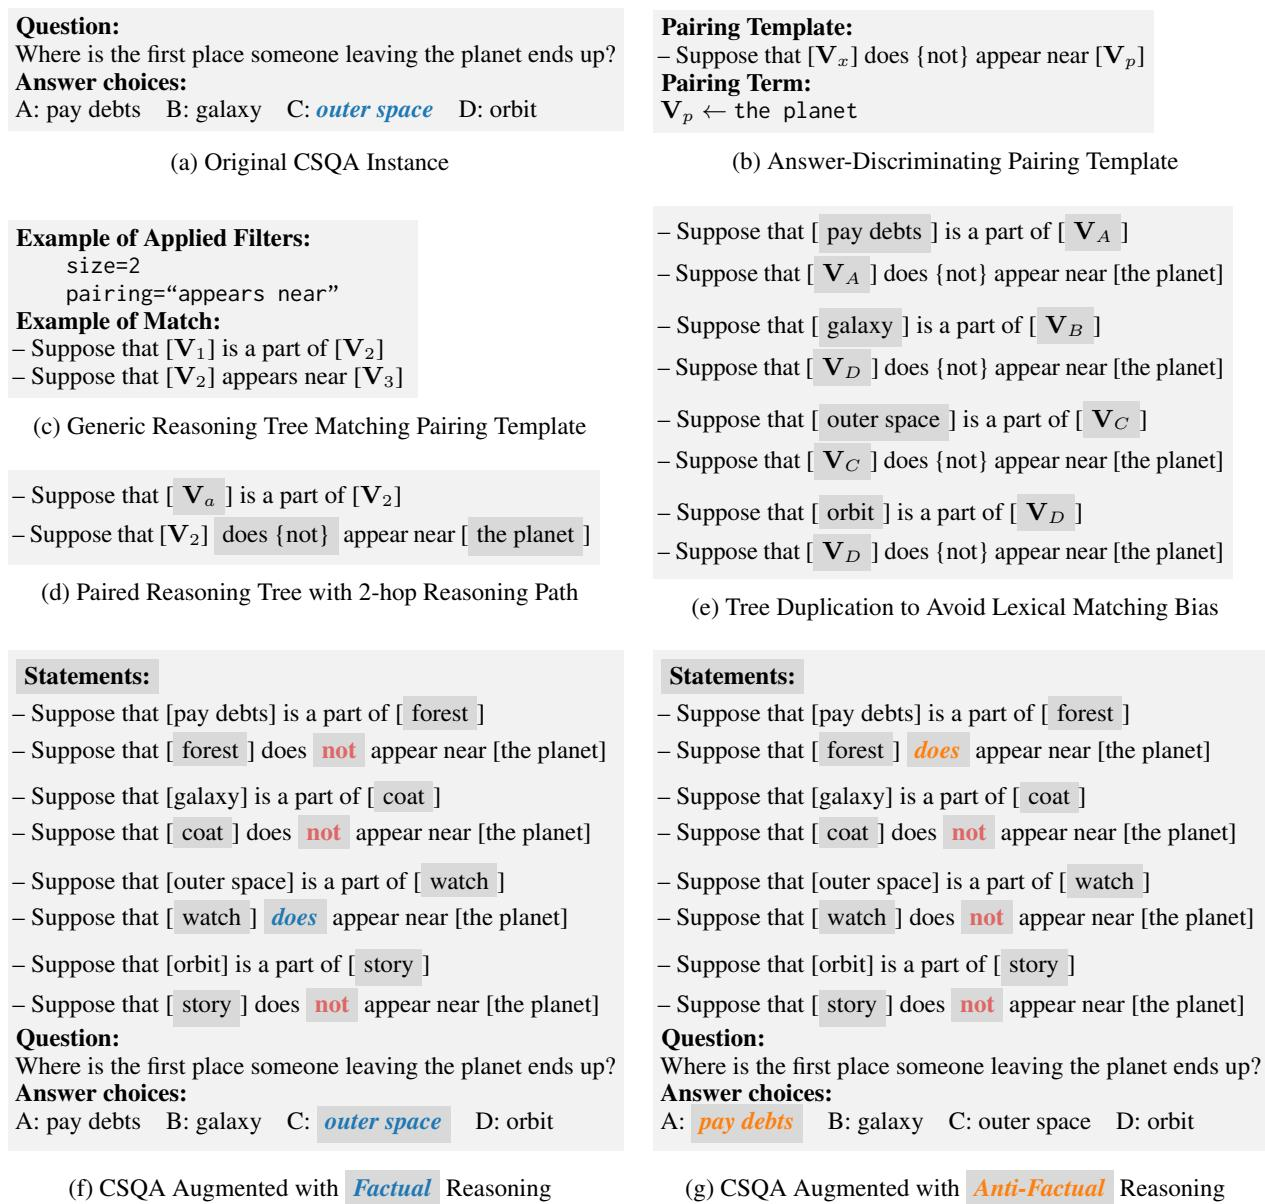
第一阶段将非正式常识推理模式转换为形式化模板。每个推理技能都表示为两个概念之间反复出现的关系模式,例如“X 出现在 Y 附近。”这些模板来自解决基础数据集中的问题所需的推理结构,并作为更大组合结构的构件。为使模板与特定实例相关,该框架构建配对模板。配对模板包含两个变量 Vx 和 Vp。配对变量 Vp 用问题特定词 p 进行锚定,而另一个变量保持自由。模板的设计使得将自由变量锚定到一个答案选项,即 Vx←ai,能够区分可用答案。每个配对模板都有一个正变体 p+ 和一个负变体 p−,使其要么蕴含某个给定答案选项,要么与之矛盾。
随后,通过共享变量组合多个推理模板,构建通用推理结构。这会生成一个推理图,其中节点是变量,边是模板。为保持有效推理行为,该图被约束为无环,因此组合后的模板不能形成循环蕴含或悖论式推理链。模板组合还受到可约性限制:只有当两个模板的组合可约化为有效的常识推理模式时,它们才能被连接。该过程避免任意模板连接,并确保每个组合得到的树对应于连贯推理,而不是临时拼接的陈述序列。
推理树自动生成,直到最大大小超参数 T。对于每个问题,仅保留匹配该问题某个配对模板的树。这些配对推理树具体化了反实际上下文的组合推理主干。在一个配对树内,一条推理路径连接源变量与目标变量,并与答案选项相关的变量被指定为答案变量 Va。由于路径结构可递归约化,将答案变量锚定到一个答案选项,即 Va←ai,会保留配对模板建立的各个答案选项之间的逻辑区分。
该框架通过分离相关推理路径和干扰模板来量化推理难度。如果一条推理路径包含 n 个模板,而完整树包含 T 个模板,则干扰模板的数量为
d=T−n.该公式使论文作者能够在所需推理步骤数和无关键陈述数量变化时评估模型鲁棒性。关键设计特性是,推理复杂度可以通过树的增长系统地增加,而无需新的手工标注问题。
一个主要方法学担忧是,LLM 可能通过上下文与某个答案选项之间的表面词汇匹配来识别预期答案,从而绕过形式化推理。为应对这一点,配对树会为每个答案选项 ai 复制一次,以确保所有选项都出现在反实际上下文中。在复制树内部和跨复制树之间随机化陈述顺序,并删除重复陈述。这些操作旨在控制近因偏差或对重复术语偏好等伪影。
变量锚定通过带回溯的束搜索树搜索执行。配对变量和答案变量作为种子词,其余变量以反实际方式填充。ConceptNet 被用作锚定知识库,未出现在 ConceptNet 中的三元组被视为反实际。由于在知识库中缺失并不能严格保证虚假,该框架引入概率性防护,以降低把有效事实关系误标为反实际的风险。
最后一步选择应由逻辑蕴含支持的答案选项。除一个选项之外,其余答案选项对应的配对模板都会被否定,使得只有选定答案被蕴含,而其他答案被反驳。通过选择将正变体应用于原始事实答案还是应用于另一个答案,论文作者生成相匹配的事实任务变体和反实际任务变体。在两种情况下,上下文都包含以反实际方式锚定的陈述,并且所有结构因素保持不变。这种受控构建使得可以比较事实推理表现与明确改变后的常识世界中的推理表现。
实验
实验使用源自 CSQA 的 ACCORD 基准,在受控设置下评估 LLM 在逐步复杂化的推理树上的表现。通过比较事实任务变体和反实际任务变体,结果显示,当正确答案与常识一致时,模型表现明显更好,这揭示出表观推理常常反映上下文不忠实以及对记忆捷径的依赖。该研究还分离了推理跳数和干扰项的影响,发现多跳推理是性能退化的主要来源,而模型在过滤干扰项方面相对更好。
该映射将常识推理技能(如空间、因果和部分整体模式)连接到 ConceptNet 关系和命名推理模板。这些模板以简单形式表达反复出现的模式,例如 X 出现在 Y 附近,并可被组合成推理树,供评估框架使用。随附结果表明,事实推理任务比反实际变体更容易,这提示参数化熟悉度可能混淆所测得的推理能力。每个推理技能由一个简短模板表示,该模板通过命名模式连接两个概念。在控制其他因素时,增加推理跳数导致性能下降比增加干扰项更明显。事实结果与反实际结果之间的差距说明事实性常识基准中存在上下文不忠实,并降低了构念效度。
ACCORD 被描述为结合了反事实、反实际锚定、显式推理技能、可组合性、自动扩展以及可测量的推理跳数和干扰项。相关常识推理基准被显示只提供该特征集的部分内容,常常缺少显式技能、可组合性、可扩展性、可测量复杂度或反实际反事实。ACCORD 是列表中唯一被标记为同时具有反事实、反实际、显式技能、可组合性和可扩展性的基准。ACCORD 还提供可测量的推理跳数和干扰项,而若干相关基准将复杂度报告为未知或未测量。既有基准在反事实支持方面各不相同,其中一些提供反实际锚定,但不提供可组合性或受控技能。
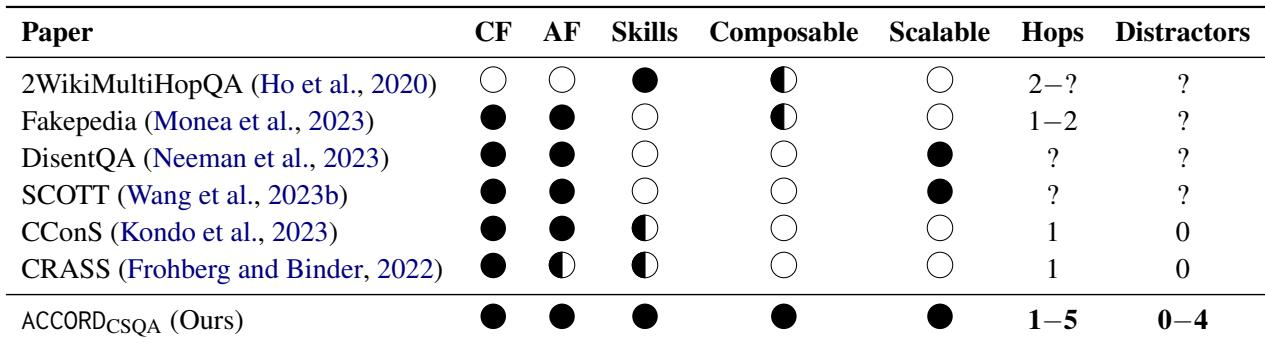
该评估将常识推理技能(包括空间、因果和部分整体模式)映射到 ConceptNet 关系和组合推理模板,并将 ACCORD 与现有基准进行比较。实验显示,事实任务通常比反实际变体更容易,这表明参数化熟悉度会混淆所测得的推理能力,并削弱构念效度,而增加推理跳数比添加干扰项更强烈地影响性能。总体而言,ACCORD 被定位为唯一同时结合反事实和反实际锚定、显式技能、可组合性、可扩展生成以及可测量复杂度的基准,而既有数据集只部分支持这些特征。