Command Palette
Search for a command to run...
IrokoBench:大语言模型时代非洲语言的新基准
IrokoBench:大语言模型时代非洲语言的新基准
摘要
尽管大语言模型(LLM)已被广泛采用,其卓越能力仍局限于少数高资源语言。此外,许多低资源语言(如非洲语言)由于缺乏高资源语言之外的适当或全面的基准,通常仅在基础文本分类任务上进行评估。本文提出了 IrokoBench——一个涵盖 17 种类型学多样的低资源非洲语言的人工翻译基准数据集,覆盖三项任务:自然语言推理(AfriXNLI)、数学推理(AfriMGSM)和多选题知识问答(AfriMMLU)。我们使用 IrokoBench 对 10 个开源和 6 个专有 LLM 在零样本、少样本和翻译测试(即测试集被翻译为英文后进行评估)设置下进行了评估。我们的评估揭示了高资源语言(如英语和法语)与低资源非洲语言之间显著的性能差距。我们观察到开源模型与专有模型之间存在显著性能差距,性能最高的开源模型 Gemma 2 27B 仅达到最佳专有模型 GPT-4o 性能的 63%。此外,在评估前将测试集机器翻译为英文有助于缩小以英语为中心的大型模型(如 Gemma 2 27B 和 LLaMa 3.1 70B)的性能差距。这些发现表明,需要更多努力来开发和适配面向非洲语言的 LLM。
一句话总结
Masakhane NLP 等引入 IrokoBench,这是一个覆盖 17 种类型学上多样的非洲语言的人工翻译基准,涵盖自然语言推理、数学推理和基于知识的问题回答。该基准揭示了高资源语言与低资源语言之间以及开源 LLM 与专有 LLM 之间的显著性能差距,凸显了为非洲语言进一步适配 LLM 的必要性。
核心贡献
-
论文引入 IrokoBench,这是一个面向 17 种类型学上多样的低资源非洲语言的人工翻译基准,覆盖自然语言推理(AfriXNLI)、数学推理(AfriMGSM)和选择题知识问答(AfriMMLU)。该基准将非洲语言评估从基础文本分类任务扩展到复杂推理和知识密集型任务。
-
论文使用零样本、少样本和翻译测试设置评估了 10 个开源 LLM 和 6 个专有 LLM。结果显示,高资源语言与非洲语言之间存在重大差距,其中 Gemma 2 27B 仅达到 GPT-4o 性能的 63%,并且 AfriMGSM 被证明是最具挑战性的任务。
-
论文在 GitHub 和 Hugging Face 上以 CC BY-SA 4.0 许可证发布 IrokoBench,并表明在评估前将测试集翻译成英文可以帮助缩小像 Gemma 2 27B 和 LLaMa 3.1 70B 这样更大的以英语为中心的开源模型的差距。这些发现支持进一步开发和适配面向非洲语言的 LLM。
引言
大语言模型越来越多地支持复杂推理任务,但大多数最先进系统主要在高资源语言上训练,导致非洲语言用户性能较弱且评估有限。现有非洲基准通常覆盖较窄或较简单的任务,英文基准的机器翻译版本可能引入噪声、偏见和文化不匹配。作者通过 IROKOBENCH 填补这一空白,该基准是面向非洲语言的人工整理基准,评估自然语言推理、数学推理和选择题知识问答。作者还测试了许多开源和专有 LLM,揭示低资源非洲语言上的性能急剧下降,以及开源系统与专有系统之间的明显鸿沟。
数据集
-
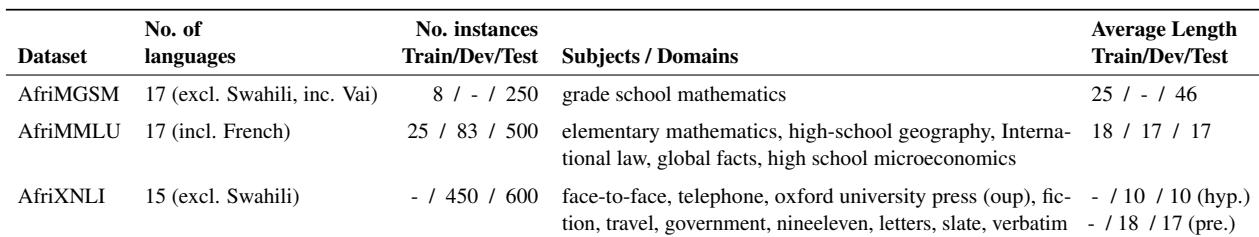
作者引入 IROKOBENCH,这是一个覆盖 19 种语言的多语言基准:17 种非洲本土语言以及英语和法语。英语和法语也作为翻译源语言。非洲语言横跨四个地区和三大语言家族,其中包括八种 Bantu 语言。语言元数据包括家族、地区和母语者数量。
-
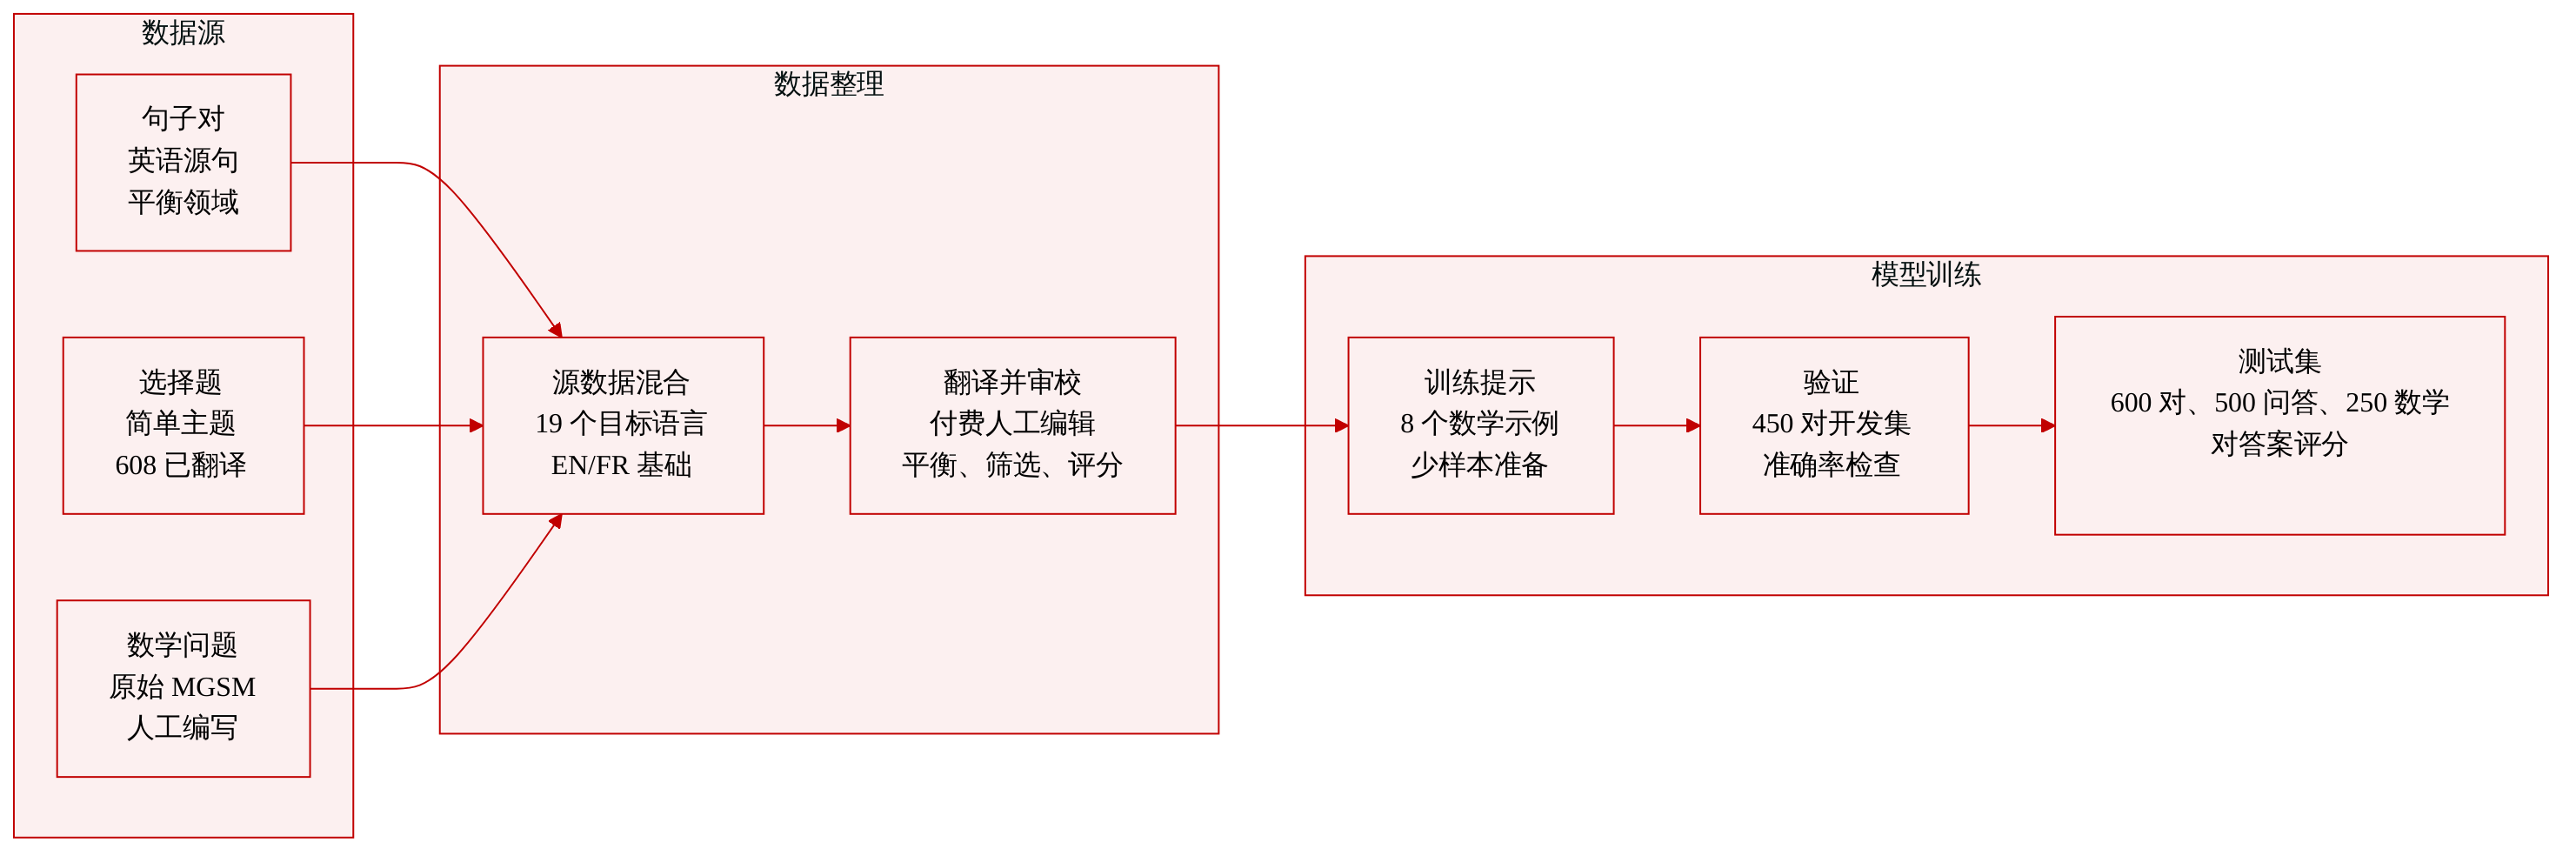
数据通过语言协调员收集,协调员招募专业译者。多数译文从英文翻译,Ewe、Lingala 和 Wolof 除外,它们从法文翻译。MMLU 先翻译成法文,再翻译成这三种法语区语言。质量控制包括支付译者报酬前的协调员审查和校正。作者还计算 COMET 质量分数,但指出这些分数对 Lingala、Twi 和 Wolof 并不可靠。
-
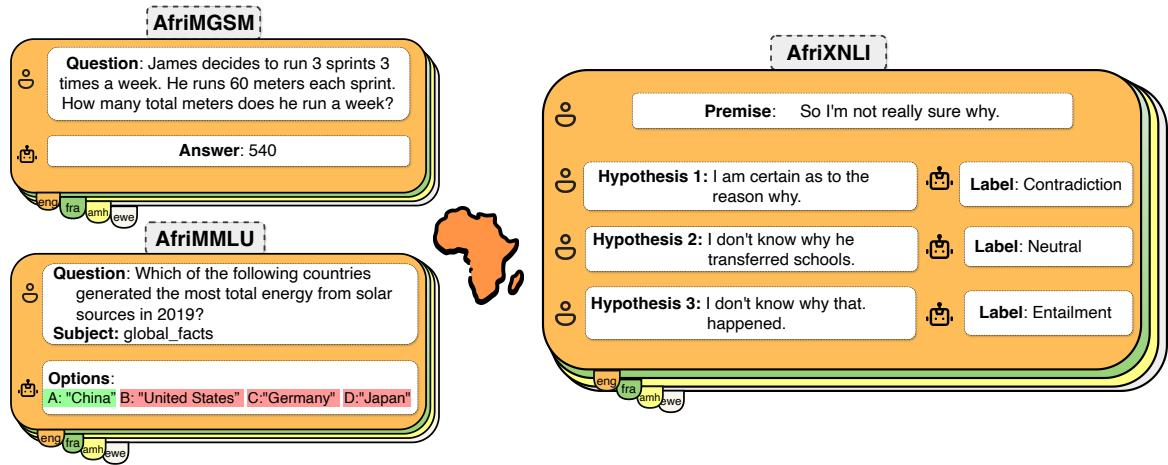
AfriXNLI 包含 XNLI 英文部分到 15 种非洲语言的人工翻译,不包括 Swahili。对于每种语言,作者在 10 个 XNLI 领域上采样相等数量的实例,并使用缩减后的平衡划分:每种语言 450 个开发示例和 600 个测试示例。准确率作为评估指标。
-
AfriMMLU 是从可自由获取的网络来源中整理的选择题知识问答子集。作者选择五个被认为无文化偏见或更容易翻译的科目:高中地理、高中微观经济学、小学数学、国际法和全球事实。作者总共翻译 608 个问答对,其中 500 个测试示例,每个科目 100 个。使用选项预测准确率进行评估。
-
AfriMGSM 由原始 MGSM 数据集中的小学数学应用题构建。作者使用 8 个示例作为少样本和思维链提示的训练演示,使用 250 个示例作为测试集。精确匹配作为评估指标。
-
作者主要将这些数据集用于 LLM 评估而非模型训练。没有描述特殊裁剪策略,也未报告混合比例。主要处理步骤包括人工翻译、AfriXNLI 的领域平衡采样、AfriMMLU 的科目筛选以及翻译质量控制。
方法
翻译与质量控制流程
作者利用协调化的人工翻译与验证流程,将基准句子转换为非洲语言和法文。每种语言都会聘请语言协调员,协调员负责招募专业译者。译者基于原始源材料工作,流程按任务组分阶段推进:先是 XNLI,然后是 MGSM,最后是 MMLU。译者会获得报酬,这有助于在大规模多语言集合上保持一致交付。
该流程还根据语言环境调整源语言。对于 Ewe、Lingala 和 Wolof,译者从法文而非英文工作,因为它们位于法语区。对于 MMLU,作者通过专业译者生成法文翻译,然后再将该法文版本翻译成这三种法语区语言。由于部分译者比英语更流利法语,该流程允许它们在法文句子存在歧义或不清晰时使用英文原文进行交叉核验。
质量控制通过两阶段审查和评估流程处理。第一,语言协调员检查翻译输出,并校正被认为不准确、不自然或翻译质量不佳的句子。报酬会延迟到审查阶段完成之后支付,从而创建一种质量保证机制,鼓励译者在最终验收前纠正错误。第二,作者使用 AfriCOMET QE 指标计算自动质量估计分数。该指标通过将译文与原文比较,为每个翻译句子生成介于 0 和 1 之间的分数。在大多数语言对中,分数分布集中在 0.7 到 1.0 之间,这支持整体翻译质量。但对于 Lingala、Twi 和 Wolof,平均分较低,约为 0.5。作者对这些语言的分数持谨慎态度,因为它们未被 AfriCOMET 使用的原始 AfroX-LMR encoder 的预训练数据覆盖,且此前分析表明,其中一些语言的 QE 分数与人工判断之间的相关性较弱。因此,自动 COMET 分数被用作诊断性监控,而不是所有语言的唯一质量过滤器。
实验
实验使用语言内提示、翻译为英文后评估、零样本、少样本和跨语言迁移设置,在非洲语言任务上评估广泛开源和闭源语言模型。实验表明,模型在高资源语言上通常比在非洲语言上表现更好,闭源模型通常强于开放权重模型,许多以英语为中心的模型从翻译测试提示中获益更多。特定任务和提示敏感性分析进一步揭示,提示策略和模型选择很重要:闭源模型在某些推理任务的语言内表现可能更好,而以非洲为中心微调的模型在有充足标注英文数据时可能有效。
IROKOBENCH 提供三个面向非洲语言的基准数据集:AfriMGSM 用于小学数学,AfriMMLU 用于选择题知识问答,AfriXNLI 用于自然语言推理。这些数据集覆盖多种非洲语言和多个领域,其中英语、法语和 Swahili 被包含在整体基准集合中。相关评估说明显示,翻译测试可以帮助开源模型在 AfriMGSM 上表现更好,而当模型在相关语言上预训练时,语言内迁移可以有利于 NLI。该基准包含数学、知识问答和句子对推理任务。AfriMMLU 聚焦于一组在非洲语言环境中更容易翻译的有限科目。AfriXNLI 使用来自多个英文领域的翻译 NLI 数据,并使用平衡类别上的准确率进行评估。
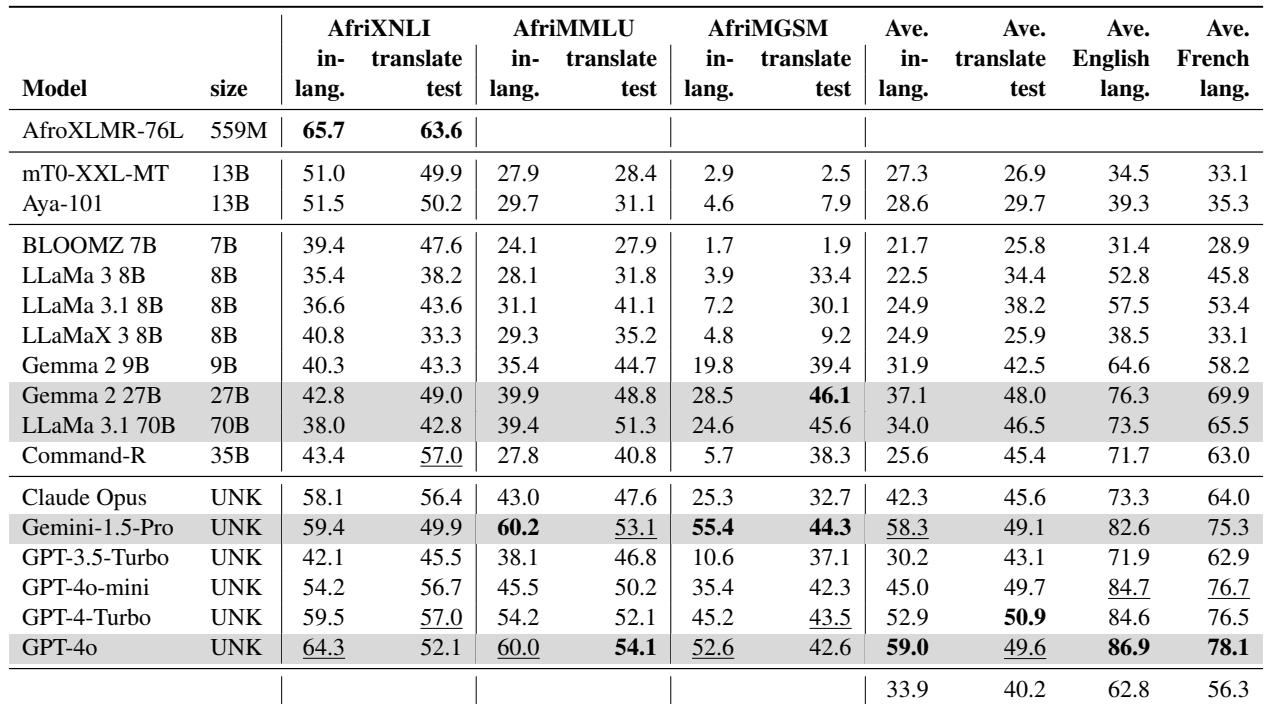
在所有受基准测试的模型中,GPT-4o 在非洲语言任务上具有最强平均性能,闭源权重模型始终优于开放权重模型。多数模型在提示被翻译成英文时也比使用非洲语言提示时得分更高,其中几个开源模型在推理任务上获得的提升最大。闭源权重模型始终排名高于开放权重模型。非洲语言表现落后于英语和法语,即使最佳模型也存在较大差距。多数模型更偏好英文提示,只有少数闭源模型从语言内提示中获益。翻译成英文可以显著提升开源模型在推理任务上的性能。
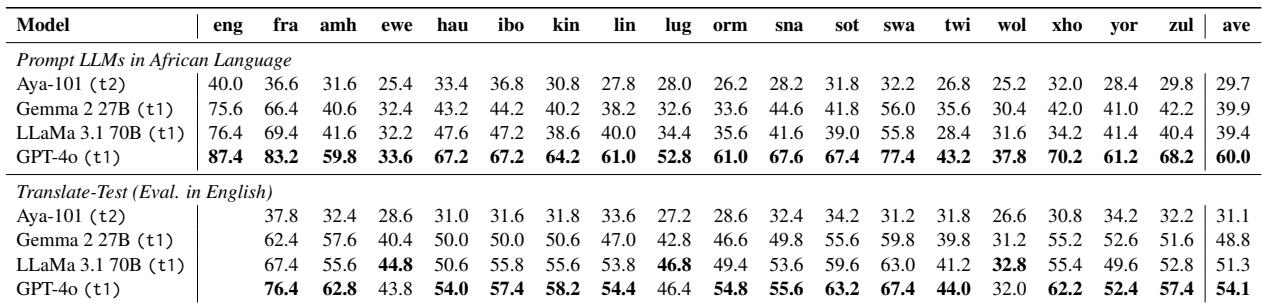
AfriMMLU 准确率在不同语言和模型家族间差异显著,在高资源环境中表现更强,在若干非洲语言中表现较弱。GPT-4o 在语言内评估时通常表现最佳,而开源模型在问题评估前翻译成英文时往往会有提升。这表明翻译测试可以帮助以英语为中心的模型处理低资源语言,不过收益取决于模型类型和机器翻译质量。在所比较的模型中,GPT-4o 在语言内选项预测准确率方面表现最强。翻译测试提升了多数非洲语言上的开源模型性能,但 Wolof 是一个显著例外。非洲语言分数通常低于英语和法语,且性能也因语言不同而大幅波动。
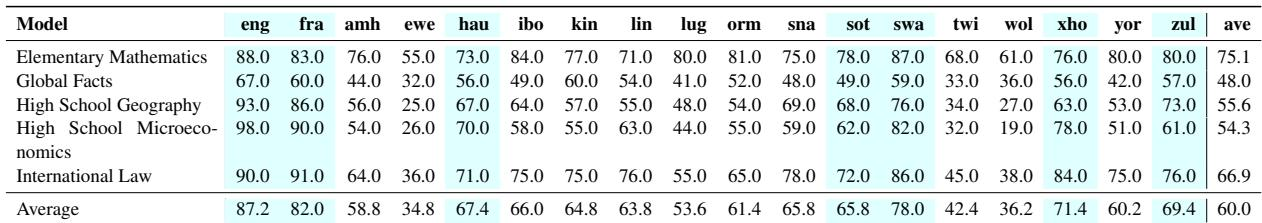
GPT-4o 的准确率因科目和语言而显著变化。小学数学通常是最强科目,而全球事实即使对英语和法语来说也是最难的。国际法对若干语言相对较强,但高中地理和微观经济学对许多非洲语言具有挑战性。小学数学在各语言间表现出最广的强项。全球事实总体最难。国际法对许多语言表现相对较好。高中地理和微观经济学对许多非洲语言尤其困难。
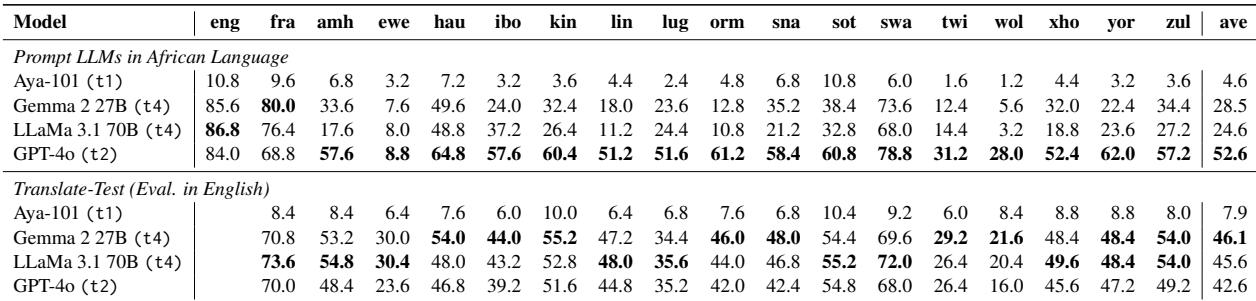
该表比较了多个 LLM 在非洲语言和翻译测试设置下数学应用题的精确匹配结果。GPT-4o 在回答使用非洲语言时表现最佳,而 Gemma 2 27B 和 LLaMa 3.1 70B 在问题翻译成英文后平均有提升。Aya-101 在两种设置下仍表现薄弱,表明当前模型仍然难以进行非洲语言算术推理。在所比较的模型中,GPT-4o 在跨非洲语言的语言内精确匹配方面表现最强。翻译测试提升了 Gemma 2 27B 和 LLaMa 3.1 70B 的非洲语言平均性能。Aya-101 在语言内和翻译测试两种设置下分数都非常低。
IROKOBENCH 评估多个语言和模型家族中的非洲语言数学、知识问答和自然语言推理。实验表明,闭源权重模型通常优于开放权重模型,非洲语言上的表现常常落后于英语和法语,并因任务、科目和语言而出现大幅变化。翻译测试可以显著提升开放权重模型,尤其是在推理任务上,不过收益取决于模型类型、语言和翻译质量。