Command Palette
Search for a command to run...
定义与检测人工评估指南中的缺陷:面向可靠自然语言生成评估的初步研究
定义与检测人工评估指南中的缺陷:面向可靠自然语言生成评估的初步研究
Jie Ruan Wenqing Wang Xiaojun Wan
摘要
人工评估是衡量自然语言生成(NLG)系统质量的金标准。然而,作为确保人工评估可靠性与可复现性的关键要素,评估指南所获得的关注十分有限。我们的调研发现,顶级会议中近期涉及人工评估的论文里,仅有 29.84% 公开了评估指南,而这些指南中有 77.09% 被检测出存在缺陷。不可靠的评估指南可能导致不准确的评估结果,从而阻碍自然语言生成技术朝正确方向发展。为应对上述挑战,我们朝着构建可靠评估指南迈出了初步一步,通过收集从已有论文中提取的评估指南以及由大语言模型(LLM)生成的评估指南的标注,提出了首个人工评估指南数据集。随后,我们提出了包含八类缺陷的分类体系,并制定了评估指南的编写原则。此外,我们利用大语言模型探索了指南缺陷检测方法,并提供了一套提升人工评估可靠性的建议。标注后的人工评估指南数据集及缺陷检测方法代码已在网上公开发布。
一句话总结
北京大学研究人员提出了首个面向人工评估指南的数据集,其中包括八类漏洞分类体系以及一种基于 LLM 的检测方法,并揭示现有 77.09% 的 NLG 评估指南存在漏洞,从而提升 NLG 系统人工评估的可靠性。
核心贡献
- 论文发布了首个经过标注的人工评估指南数据集,该数据集由从已发表论文中抽取的指南摘录和由大语言模型生成的示例构建而成,并公开数据集和漏洞检测代码。
- 提出了八种指南漏洞分类体系以及撰写可靠评估指南的原则,用于定义具体缺陷并指导稳健的指南构建。
- 探索了基于 LLM 的检测方法,采用少样本提示和 Chain-of-Thought 推理,并提出在开展人工评估前使用检测器评估指南可靠性的建议。
引言
自然语言生成通常依赖人工评估,因为自动化指标与人类判断的相关性可能较差,这使得清晰的评估指南对于可靠且可复现的评估至关重要。已有研究将人工评估视为金标准,却很少考察或发布标注者使用的指南,而现有漏洞检测工作也未涉及这些评估说明中的缺陷。作者分析了主要 NLP 会议的论文,发现很少发布评估指南,且许多已发布指南存在歧义、偏见、评分不清、指令不灵活等漏洞。其主要贡献包括一个八类指南漏洞分类体系、首个经过标注的人工评估指南数据集,以及一种基于 Chain-of-Thought 提示的 LLM 方法,用于检测指南缺陷并支持更可靠的评估实践。
数据集
-
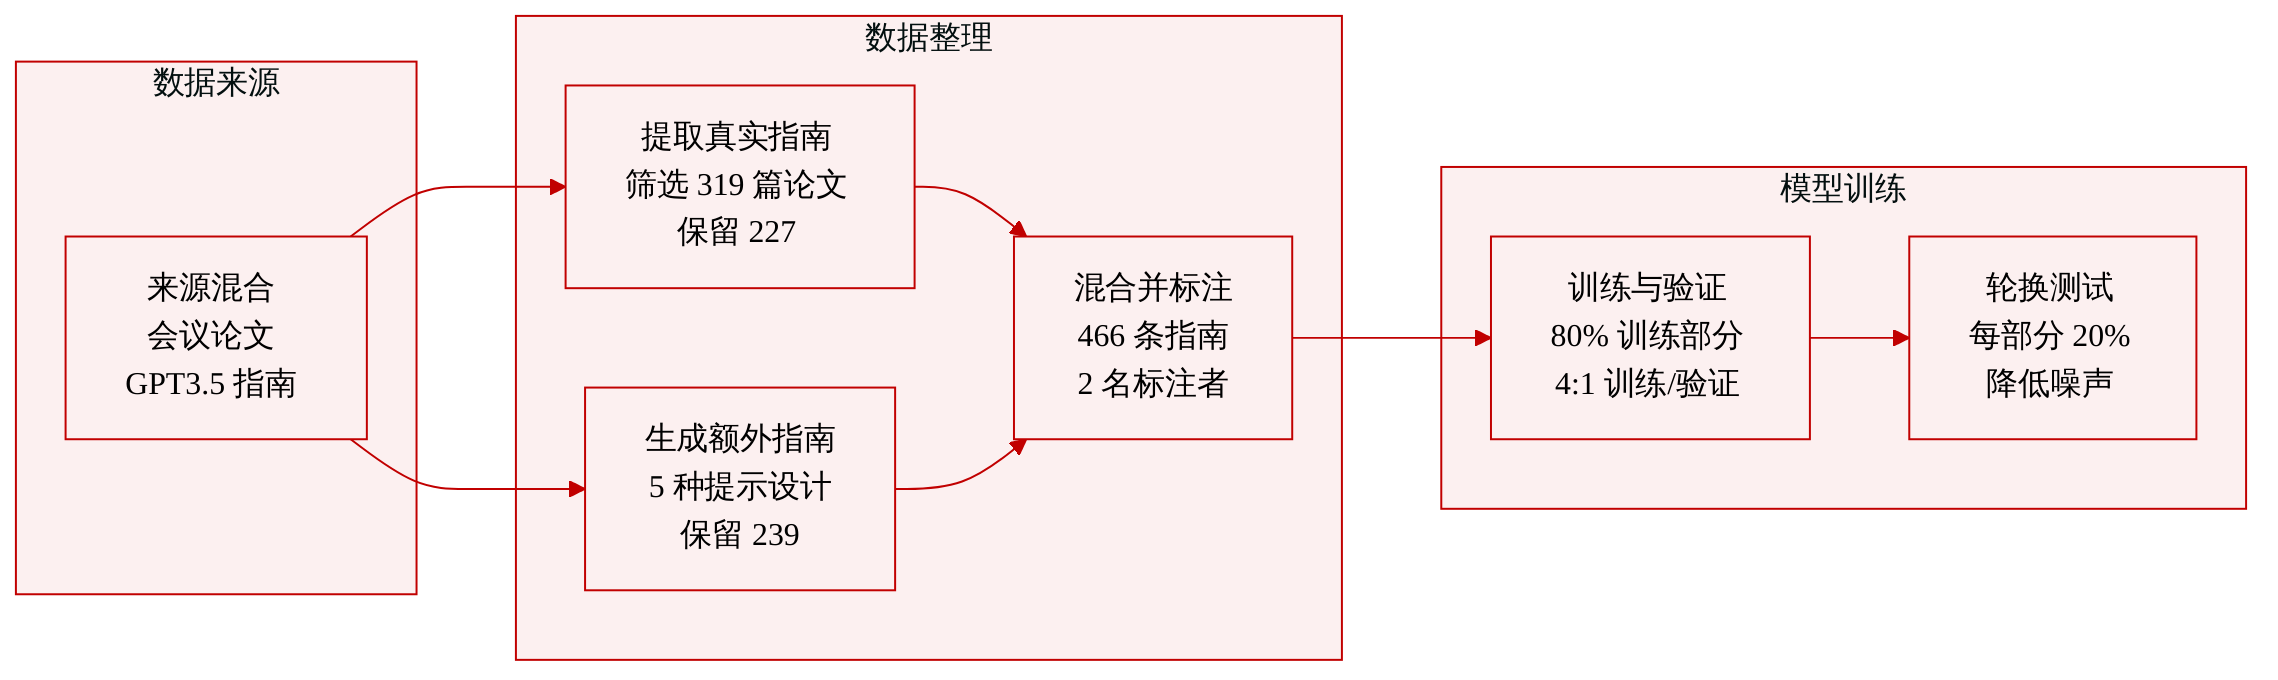
作者构建该数据集是因为现有资源没有直接评估人工评估指南。数据集融合从已发表论文中抽取的真实指南和由 GPT3.5 Turbo 生成的合成指南。
-
真实子集:从 ACL、EMNLP 和 NAACL 爬取 2020 至 2022 年论文,得到 3,233 篇原始论文。关键词过滤使用人工评估、人工评价、指南、指令、问卷、界面、截图等术语,筛选出 677 篇评估相关论文,并将候选论文集合缩小至 319 篇。经过 NLG 任务的人工筛选,作者提取 227 条指南:来自 ACL 的 111 条、来自 EMNLP 的 62 条、来自 NAACL 的 54 条。原本以图表形式展示的指南转换为文本形式。
-
合成子集:作者为 GPT3.5 Turbo 设计五种提示方案,包括原始提示、带评估维度的原始提示、结构化提示、带评估维度的结构化提示、带评估维度和约束的结构化提示。每个提示覆盖 12 项 NLG 任务和 2 种评估设置,并在关键词 instruction 和 guideline 之间交替,每种提示生成 48 条指南。最终合成集合包含 239 条生成指南。
-
最终组成:数据集共包含 466 条人工评估指南,其中真实指南 227 条、合成指南 239 条。真实指南平均长度为 247.64 个单词,合成指南平均长度为 237.05 个单词。
-
模式与元数据:每个样本为一条指南文本,并关联来源信息,例如真实或合成来源,以及标注标签。合成指南还可追溯到提示类型、NLG 任务、评估设置和关键词选择。数据集按八种漏洞类型标注:伦理问题、无意识偏见、定义模糊、评分不清、边界情况、先验知识、指令不灵活和其他。若不存在漏洞,则标注为 None。
-
标注过程:四名英语能力良好的合格标注员为指南打标签。真实指南和合成指南在标注界面中随机混合,以降低来源偏差。每条指南由两名标注员标注,第三名标注员解决分歧。数据集经过批量分配、每日审核,并在每日准确率低于 80% 时重新标注。标注员之间针对真实指南的 Cohen kappa 一致性为 0.722,针对合成指南为 0.737。
-
处理细节:未报告裁剪策略。主要处理步骤包括关键词过滤、人工筛选相关 NLG 论文、指南抽取、将可视化指南元素转换为文本、通过提示模板进行合成扩展,以及标注质量控制。
-
数据集使用:作者将完整数据集划分为五部分,其中四部分用于训练,占 80%,一部分用于测试,占 20%。训练部分进一步按 4:1 比例划分为训练集和验证集。随后轮流将五部分中的每一部分作为测试集,其余部分用于训练,使完整数据集都参与评估,并降低性能方差。
方法
合成指南生成模块将指南构建视为一种提示控制生成工作流。作者没有依赖人工编写规则,而是利用 GPT-3.5-Turbo 并设计五种提示模板,逐步提高指令程度、结构化程度、评估条件化和约束规定。模板包括原始提示、带评估维度的原始提示、结构化提示、带评估维度的结构化提示,以及同时带评估维度和约束的结构化提示。这种设计使生成的指南能够覆盖不同程度的明确性和正式性,从而提升最终合成数据集的多样性。
生成过程将提示模板控制与组合式任务扩展相结合。对于每个提示模板,作者实例化不同的自然语言生成任务和评估设置,并在关键词“instruction”和“guideline”之间交替。12 项 NLG 任务、2 种评估设置和 2 种关键词变体的组合为每个提示模板生成固定数量的指南:
Nper prompt=12×2×2=48在五种提示模板下,这一工作流形成了广泛的合成指南集合,其中每条指南由特定任务领域、评估视角、提示结构和关键词措辞组合塑造。评估维度的引入提供了面向评估的上下文,而结构化和约束模板则促使语言模型产生更条理、更像规则的输。这种模块化、基于提示的生成设计使得能够系统扩展原始指南数据集,同时控制多样性和格式一致性。
实验
实验将指南漏洞检测视为多标签分类任务,在轮换的训练和测试划分上比较开源与闭源 LLM、Transformer 基线,以及零样本和少样本提示策略。案例研究表明,闭源模型可以提供有用推理,而开源模型常产生无效输出,定量分析证实少样本示例和 Chain-of-Thought 提示通常能提升检测效果。总体而言,采用 CoT VDesc 策略的 Text Davinci 003 被验证为最有效配置,同时结果也表明合成指南比真实指南更容易审计,且模型性能在不同漏洞类型之间仍有差异。
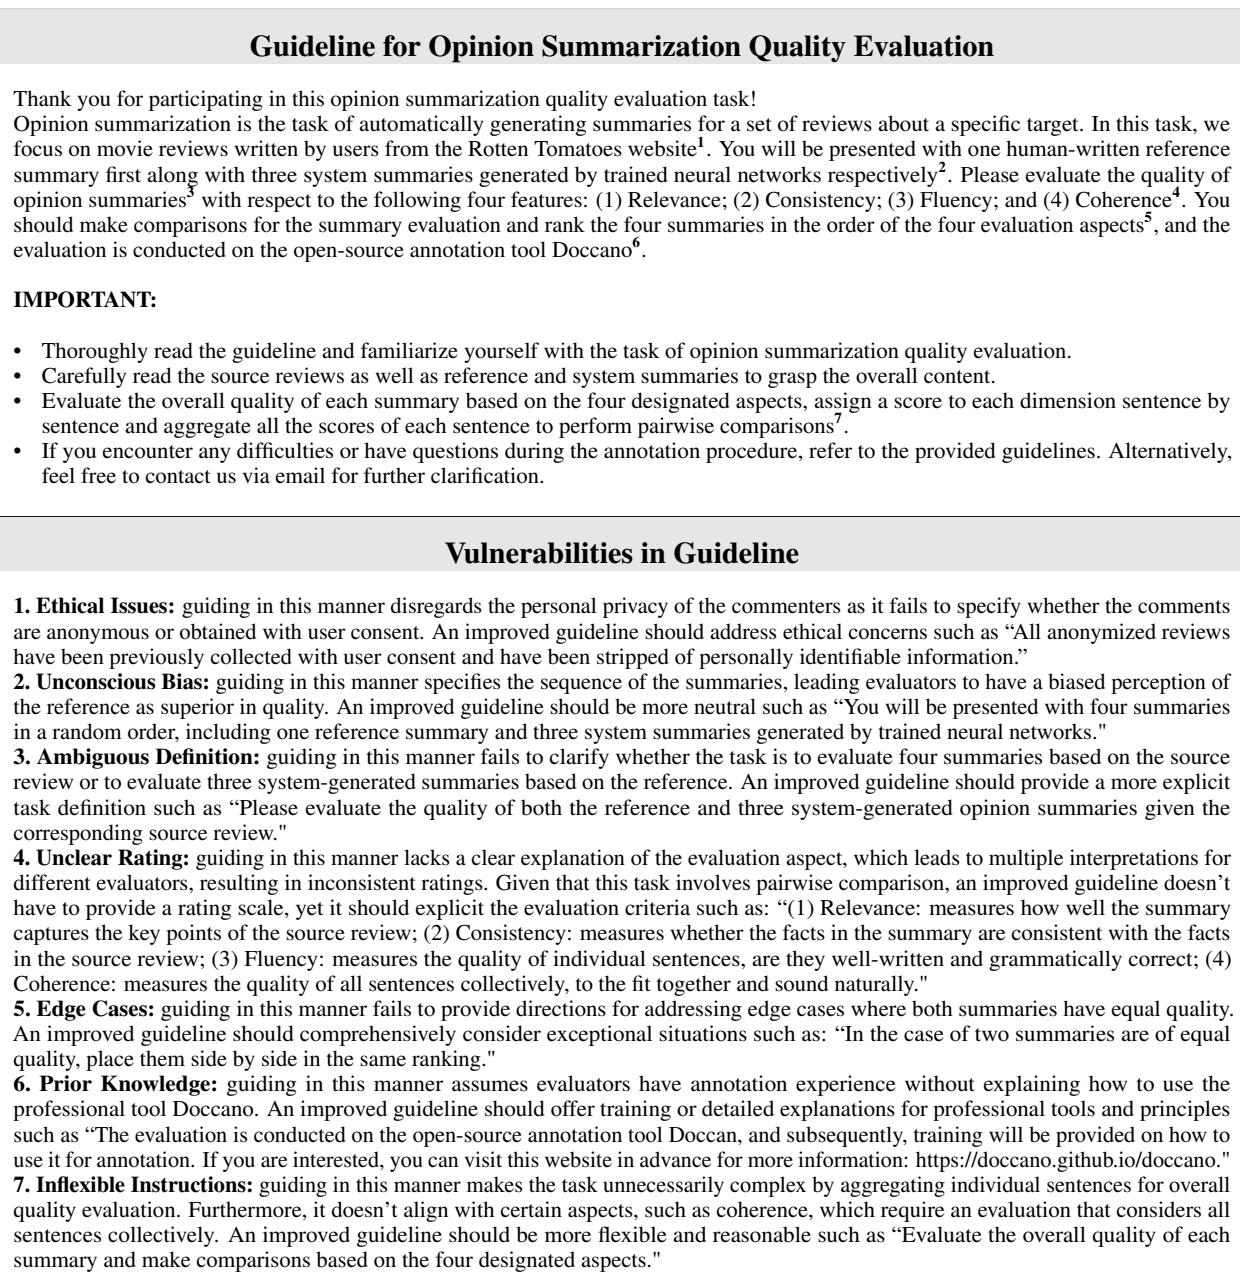
该图展示了人工评估说明中的指南漏洞分类体系。它将一条观点摘要评估指南样本与漏洞诊断及建议修改进行配对,涉及伦理疏漏、顺序偏见、定义不清、标准模糊、缺少平局处理、工具说明不足、程序过于僵化等问题。示例表明,更清晰、更中立、更明确的指南能够降低标注歧义和偏见。示例漏洞包括隐私问题、带有偏见的呈现顺序、任务范围模糊、评分定义不清、缺少边界情况指导、默认已掌握标注工具知识,以及句子分数的不灵活聚合。每种漏洞都配有建议修改,分别规定知情同意与匿名化、随机排序、明确任务范围、具体评估标准、平局处理、工具培训,以及更灵活的整体质量比较。
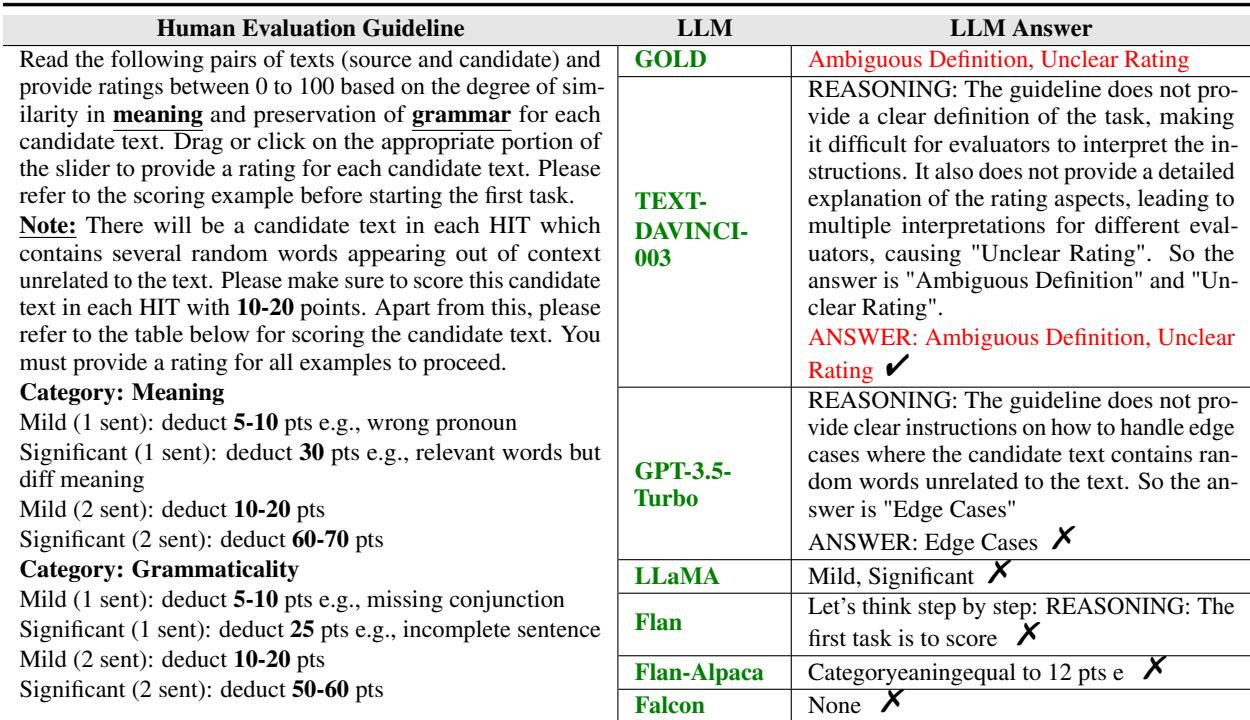
在少样本 CoT 示例中,TEXT-DAVINCI-003 正确识别出该人工评估指南存在 Ambiguous Definition 和 Unclear Rating。其推理还缩小了漏洞范围,使这些问题更容易修正。GPT-3.5-Turbo 则返回 Edge Cases,尽管该指南已经说明了如何处理无关的随机词;开源模型未能产生有效的漏洞答案。TEXT-DAVINCI-003 产生了正确的漏洞类型并给出可用推理,GPT-3.5-Turbo 将指南错误分类为存在 Edge Cases,而开源模型输出无结构或空响应
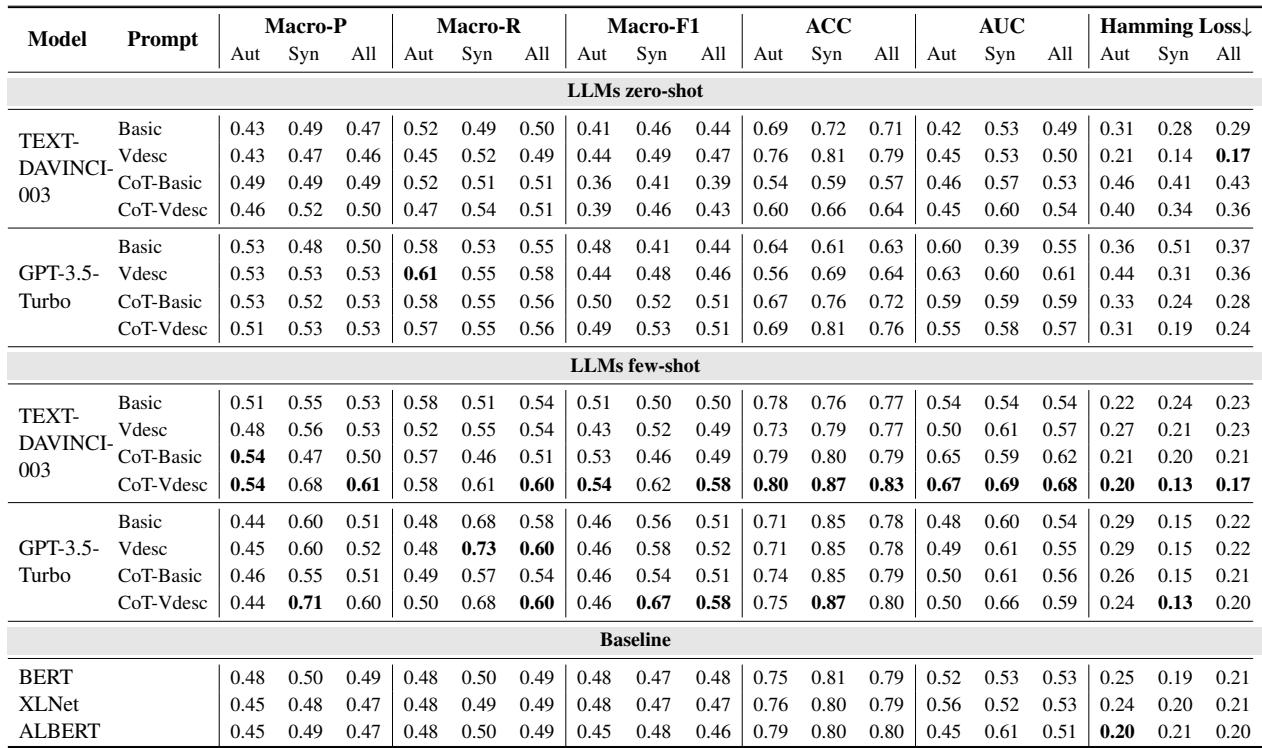
在指南漏洞检测中,LLM 总体优于预训练基线,尤其在使用少样本提示和 Chain-of-Thought 策略时。采用 CoT-Vdesc 策略的 TEXT-DAVINCI-003 是总体最强的配置,GPT-3.5-Turbo 表现相当,而一些预训练模型在没有 Chain-of-Thought 的零样本设置中仍具竞争力。模型检测合成指南通常比检测真实指南更有效,且召回率通常高于精确率,表明存在将指南标记为非漏洞的偏差。采用 CoT-Vdesc 少样本提示的 TEXT-DAVINCI-003 总体检测性能最佳。基于 LLM 的模型在大多数提示策略下持续优于预训练基线。合成指南比真实指南更容易检测。召回率通常高于精确率,显示一种因预测非漏洞而漏检漏洞的倾向。
实验评估了人工评估指南中的漏洞分类体系,并使用指南示例、定性修改和基于提示的检测测试。结果表明,更明确、更中立、更结构化的说明能够降低歧义和偏见,而经过良好提示的大语言模型(尤其是少样本 Chain-of-Thought)在识别漏洞类型方面通常比预训练基线更有效。不过,检测仍然不完美,真实指南比合成指南更具挑战性,并存在不平衡或保守漏洞判断的倾向。