Command Palette
Search for a command to run...
R-Tuning: Instructing Large Language Models to Say ‘I Don’t Know’
R-Tuning: Instructing Large Language Models to Say ‘I Don’t Know’
Hanning Zhang Shizhe Diao Yong Lin Yi R. Fung Qing Lian Xingyao Wang Yangyi Chen Heng Ji Tong Zhang
摘要
Large language models (LLMs) have revolutionized numerous domains with their impressive performance but still face their challenges. A predominant issue is the propensity for these models to generate non-existent facts, a concern termed hallucination. Our research is motivated by the observation that previous instruction tuning methods force the model to complete a sentence no matter whether the model knows the knowledge or not. When the question is out of the parametric knowledge, it will try to make up something and fail to indicate when it lacks knowledge. In this paper, we present a new approach called Refusal-Aware Instruction Tuning (R-Tuning). This approach is formalized by first identifying the disparity in knowledge encompassed by pre-trained parameters compared to that of instruction tuning data. Then, we construct the refusal-aware data based on the knowledge intersection, to tune LLMs to refrain from responding to questions beyond its parametric knowledge. Experimental results demonstrate R-Tuning effectively improves a model's ability to answer known questions and refrain from answering unknown questions. Furthermore, when tested on out-of-domain datasets, the refusal ability was found to be a meta-skill that could be generalized to other tasks. Further analysis surprisingly finds that learning the uncertainty results in better calibration and an improved ability to estimate the uncertainty than uncertainty-based testing.
一句话总结
来自香港科技大学和伊利诺伊大学厄巴纳-香槟分校的研究人员提出了 R-Tuning,这是一种具有拒答意识的指令微调方法。该方法识别预训练参数与指令微调数据之间的知识差异,并据此构造训练样本,使 LLM 能够避免回答超出其参数化知识的问题。这种拒答能力被认为可以作为一种元技能泛化到领域外任务,同时改善不确定性校准。
核心贡献
- 提出 R-Tuning 作为一种具有拒答意识的指令微调方法。该方法识别预训练参数化知识与指令微调数据之间的差距,并构造包含不确定性表达的训练样本,使 LLM 能够回答已知问题并拒答未知问题。
- 实验表明,R-Tuning 能够提升回答已知问题的能力,避免回答未知问题,在 AP 得分上优于传统微调基线,并作为一种元技能将拒答能力扩展到领域外任务。
- 不确定性分析表明,与基于不确定性的测试相比,使用显式不确定性表达进行训练能够改善校准和不确定性估计。
引言
大语言模型是强大的通用系统,但模型倾向于生成不存在的事实,这仍然是问答、摘要和知识密集型生成等可靠应用的主要障碍。已有工作通过检索、验证、置信度估计和基于不确定性的过滤来应对幻觉问题,但这些方法往往只处理表面症状,而没有解决根本问题:即使所需知识并不存在于模型的参数化记忆中,模型也通常被迫生成完整答案。
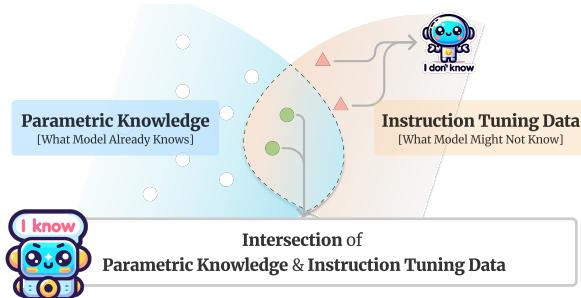
作者认为,这种行为很大程度上源于预训练阶段学到的参数化知识与指令微调数据集之间的不匹配,因为这些数据集可能包含模型无法可靠掌握的信息。在标准微调过程中,仅以完成正确答案为目标的模型可能学会猜测,而不是承认不确定性,因此难以拒绝超出其知识边界的问题。
为了解决这一问题,作者引入了拒答意识指令微调,即 R-Tuning。该方法估计模型与其指令数据之间的知识差距,将确定样本与不确定样本分离,并使用拒答意识数据进行训练。对于不确定输入,训练样本会在答案后附加不确定性或拒答表达。这使模型能够区分已知内容和未知内容,提升模型主动回答问题的可靠性,并带来能够跨任务泛化的拒答行为。
数据集
-
作者从下游问答示例中构造具有拒答意识的指令数据。每个示例的格式为
Q: {Question}, A: {Answer}. {Prompt}.,其中提示语为“是否基于内部知识准确回答了该问题?”。 -
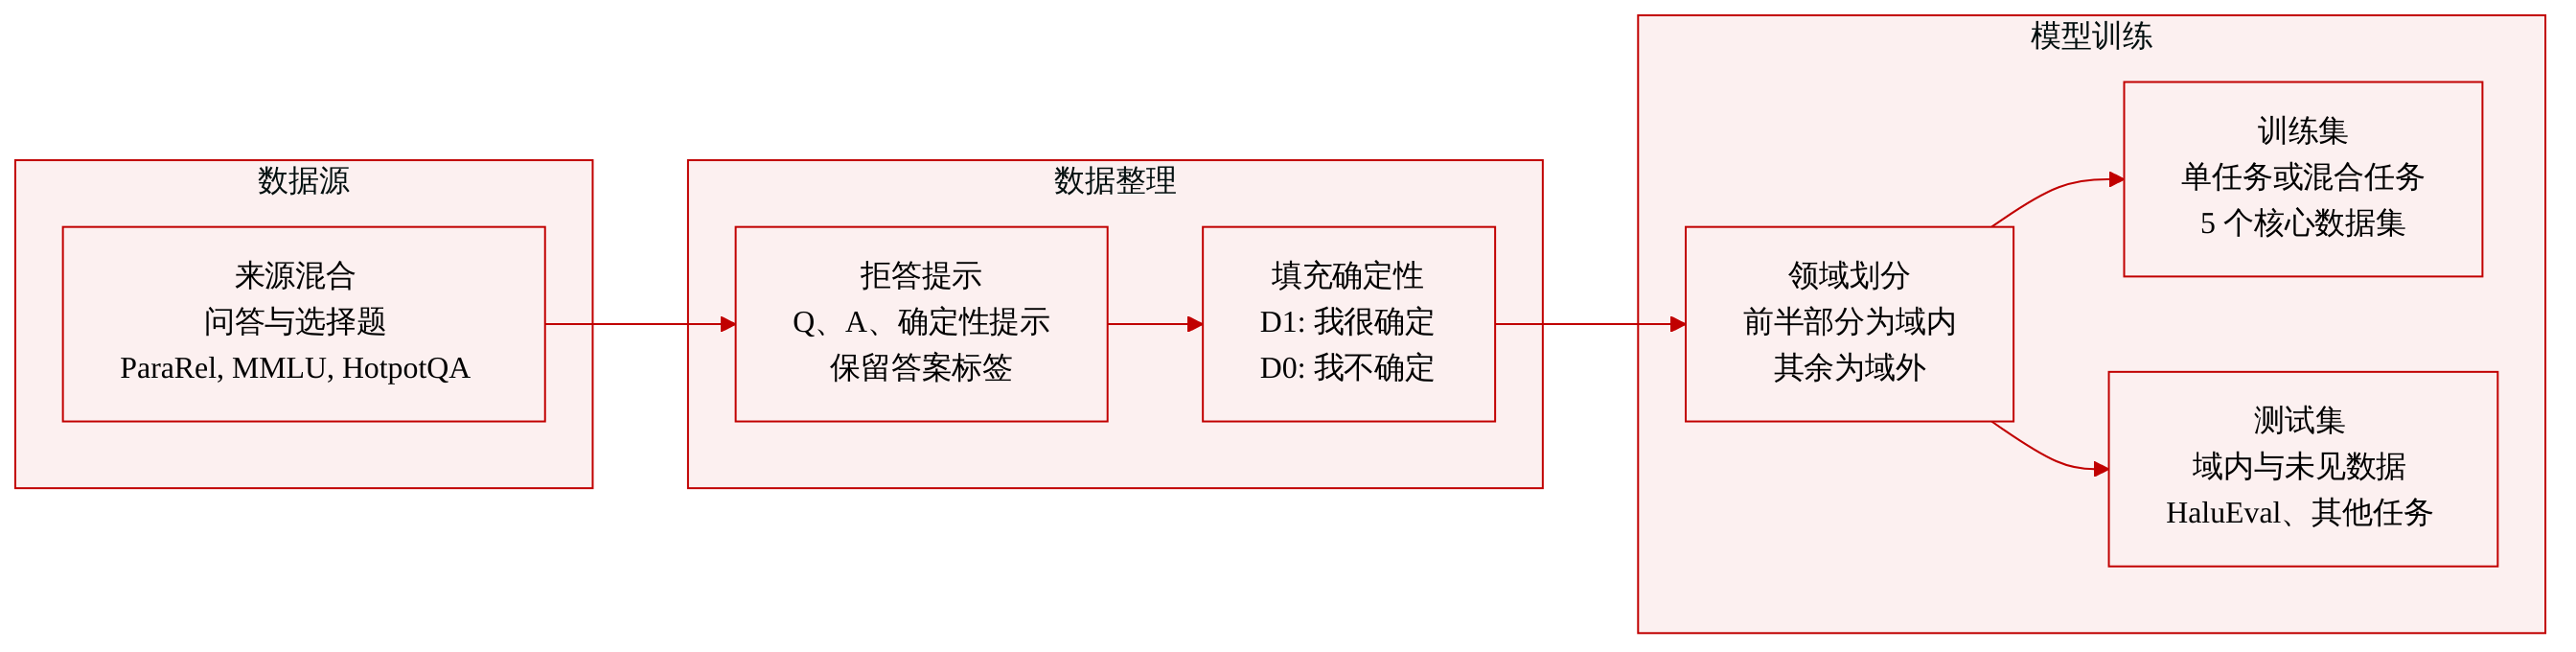
作者采用填充策略加入不确定性信号,同时保留原始答案标签。确定性数据集称为 D1,在模板后追加“确定”;不确定性数据集称为 D0,在模板后追加“不确定”。这使模型能够学习表达不确定性,同时不丢失原始标签信息。
-
论文还提到一种替代的替换方法,即直接用不确定性表达替换标签词,但上文描述的填充方法是主要构造方式。
-
下游评估数据组织为两种任务格式。问答格式包括 ParaRel、HotpotQA、SelfAware、HaluEval、FalseQA 和 NEC。多选题格式包括 MMLU、WiCE 和 FEVER。
-
对于单任务实验,作者分别使用 ParaRel 和 MMLU。每个数据集都根据可用的领域标注手工划分为训练集、领域内测试集和领域外测试集。来自前半部分领域的问题作为领域内数据使用,剩余领域的问题作为领域外数据使用。
-
对于多任务实验,作者混合 ParaRel、MMLU、WiCE、HotpotQA 和 FEVER 的训练数据,形成组合训练集。评估在对应的领域内测试集以及一个未见过的领域外测试集 HaluEval 上进行。
-
给定文本没有报告明确的子集规模、详细过滤规则、裁剪策略,也没有提供除这些格式、划分、任务定义和基于提示构造细节之外的额外元数据。
方法
作者利用拒答意识指令微调,即 R-Tuning,来适配语言模型,使其能够区分可回答问题与超出参数化知识的问题。该方法将原始指令微调数据集视为确定样本和不确定样本的来源。它首先要求预训练模型回答每个训练问题,然后将预测结果与参考标签进行比较。如果预测结果与标签匹配,则将该示例放入确定集 D1。如果预测结果与标签不匹配,则将该示例放入不确定集 D0。这一步用于识别模型内部知识与监督信号一致的位置以及不一致的位置。如下图所示:
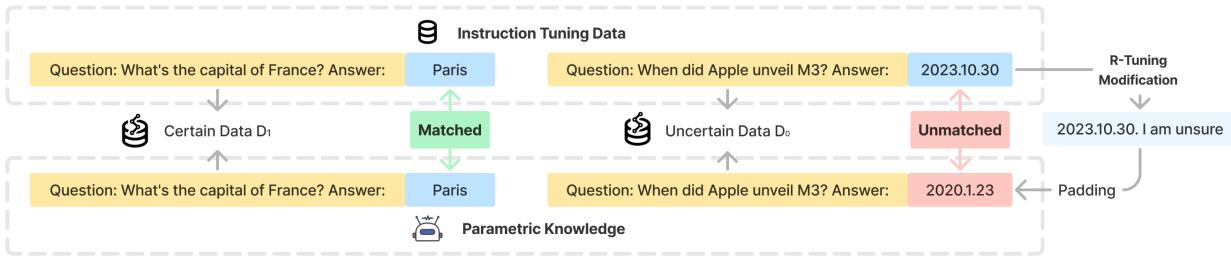
经过这一识别步骤后,作者使用提示模板构造具有拒答意识的训练目标。该模板保留原始问题和答案,然后追加确定性或不确定性表达。从概念上讲,构造后的样本形式如下:
Q:{Question},A:{Answer}.{Prompt}.
该提示询问模型是否基于内部知识准确回答了问题。对于 D1 中的实例,模型被训练为在答案后追加“确定”。对于 D0 中的实例,模型被训练为在答案后追加“不确定”。这种填充设计保留了真实答案,同时教会模型对自身回答表达置信度或不确定性。换句话说,模型仍然看到完整的标签信息,但也学习一种行为信号,即该标签是否对应可靠的参数化知识。
所得数据集用于标准指令微调训练。给定一个包含问题、答案和不确定性表达的 token 序列 t1,t2,…,tT,模型在前面的 tokens 条件下预测下一个 token。目标函数是标准交叉熵损失:
L=−T1i=1∑TlogP(ti∣t1,t2,…,ti−1).重要的是,损失仅应用于答案部分和不确定性部分,而问题部分被掩码掉。这使训练聚焦于答案生成和自我评估,而不是记忆输入提示。
在推理阶段,输入问题首先被放入同一模板,以便模型生成答案。然后在生成上下文后追加提示“是否基于内部知识准确回答了该问题?当前确定程度:”。模型继续生成确定性或不确定性表达。分配给“确定”和“不确定”的概率质量随后可以与答案概率结合,形成置信度估计。这使模型自报的不确定性能够用于判断其应当回答问题还是避免回答问题。
作者还描述了一种无监督变体,用于在无需直接与金标签比较的情况下识别不确定示例。在这种方法中,模型对每个问题采样 k 个答案,并通过熵估计不确定性:
u=−j=1∑kp(aj∣q)logp(aj∣q),其中 p(aj∣q) 是模型对问题 q 预测答案 aj 的频率。熵更高的问题被认为模型回答可靠性更低。最不确定的问题被路由到不确定训练集,并与不确定性表达配对;其余问题被路由到确定集,并与确定性表达配对。这提供了一种无需标签的方式,使模型接触具有知识差距感知能力的训练信号。
实验
实验使用 OpenLLaMA 和 LLaMA 模型,在 ParaRel 和 MMLU 上评估具有拒答意识的回答能力,比较预训练模型、普通指令微调基线和 R-Tuning 的主动回答准确率以及平均精度。结果表明,只选择性地回答与模型参数化知识一致的问题,会产生更可靠的预测、更好的置信度校准,以及比回答所有输入更强的拒答行为。基于不确定性的数据选择、不可回答问题基准、困惑度和熵等进一步分析,也支持不确定性有助于识别知识边界并提升模型可信度。
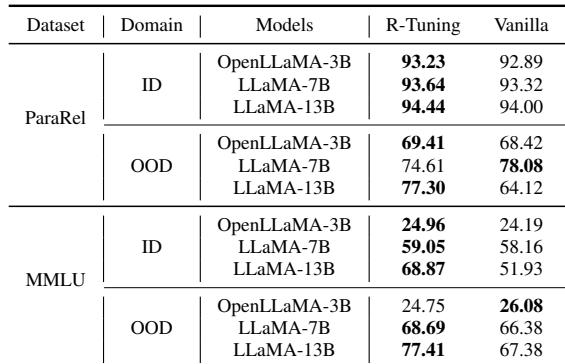
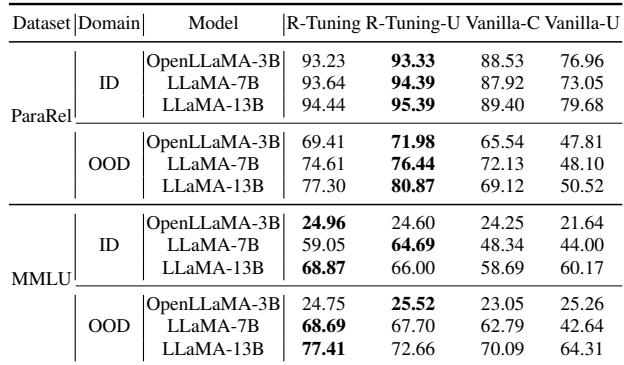
在单任务结果中,R-Tuning 通常比 Vanilla 获得更高的 AP 得分,尤其在领域内 ParaRel、领域内 MMLU,以及最大规模领域外 ParaRel 设置上。提升并不均匀,因为较小的领域外比较结果互有高低,且 7B 模型在 ParaRel OOD 上出现反转。这一模式支持一个观点:仅回答有充分置信支持的问题可以提升性能,而最终结果取决于模型规模和领域。R-Tuning 在大多数报告设置中优于 Vanilla,在 ParaRel ID 上具有一致的小幅优势,并在 MMLU ID 上取得领先。领域外结果互有高低:最大模型显示明显的 R-Tuning 增益,但 7B 模型显示 Vanilla 的优势。
在报告的 ParaRel 和 MMLU 比较中,R-Tuning-U 通常取得最强或接近最强的 AP 表现,支持基于不确定性的数据选择能够创建有效拒答意识训练数据的观点。R-Tuning-U 始终优于 Vanilla-C 和 Vanilla-U,尤其是在 ParaRel 上;同时,无监督变体也接近或略优于监督版 R-Tuning。Vanilla-U 的差距更大,尤其在领域外 ParaRel 上,这表明仅仅对 Vanilla-C 的回答应用置信度评分,不如在训练中学习不确定性可靠。在报告的 ParaRel 领域内和领域外行中,R-Tuning-U 给出高于监督版 R-Tuning 的 AP。在列出的 ParaRel 模型中,训练阶段的不确定性学习优于测试阶段不确定性过滤,后者由 Vanilla-C 表示。Vanilla-U 整体最弱,在领域外 ParaRel 上下降尤为明显。ParaRel 分数远高于报告的 MMLU 分数,并且在 MMLU 上,两种 R-Tuning 方法都强于 Vanilla-C 和 Vanilla-U。
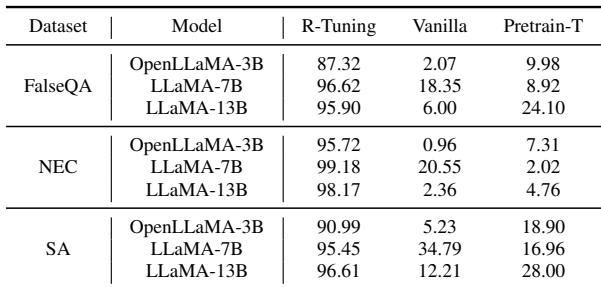
在包含不可回答问题的基准上,R-Tuning 实现了明显高于 Vanilla 和 Pretrain 基线的拒答率。它在不同模型规模上几乎全部拒绝这些问题,而其他经过微调和预训练的模型即使被允许拒答,也经常会回答这些问题。这表明,当问题违反常识或超出参数化知识时,R-Tuning 表现出更强的保守性。R-Tuning 在不可回答问题基准上显示很高的拒答率。Vanilla 和 Pretrain 基线的拒答率较低,并经常回答无效问题。
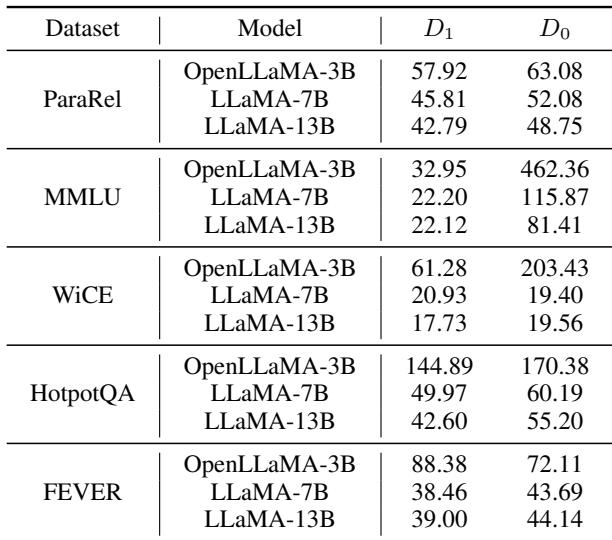
在报告的数据集上,预训练模型对确定数据赋予更低的困惑度,而不是对不确定数据,说明模型认为确定问题更熟悉、难度更低。更大规模的模型通常表现出更低的困惑度,这表明模型规模能够提升处理训练问题的能力,并可能降低不确定性。在不同模型规模上,确定问题始终比不确定问题具有更低的困惑度。不确定问题与显著更高的困惑度相关,小模型尤为如此。大模型通常比小模型产生更低的困惑度。
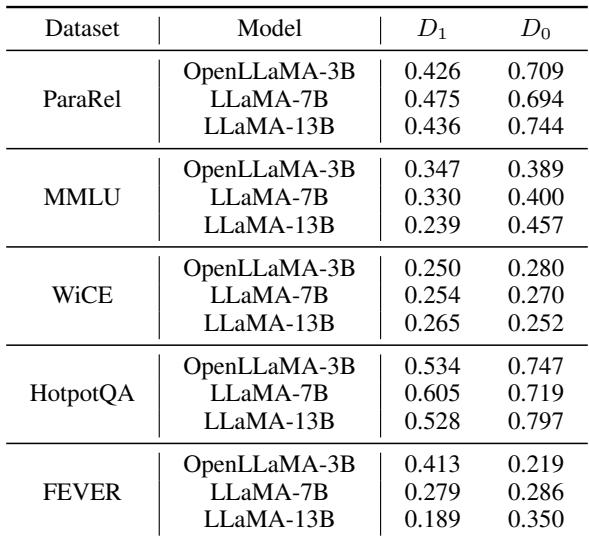
在报告的数据集上,确定数据划分 D1 的答案熵低于不确定划分 D0,这意味着 D1 上的预测更集中、变化更小。对于同时报告两个划分的每种模型配置,都能看到不确定性差距,并且在 ParaRel 和 MMLU 上差距尤其大。这些结果支持将训练数据划分为可回答问题子集和更难、更不确定子集。在报告设置中,D1 上的预测答案比 D0 上的预测答案更一致。在 ParaRel 和 MMLU 上,不确定数据 D0 的熵明显高于确定数据 D1。D0 更高的熵与更大的不确定性,或困难数据上存在多个可能预测答案相一致。
实验在 ParaRel 和 MMLU 上评估 R-Tuning,包括单任务实验、消融实验、拒答实验和不确定性分析。R-Tuning,特别是基于不确定性的变体,通常通过提升答案选择能力优于 Vanilla 基线,在领域内设置上取得最强或接近最强的准确率,并在领域外表现出依赖模型规模的提升;其核心优势是能够拒绝几乎全部不可回答问题。困惑度和熵分析进一步显示,不确定数据比确定数据更不熟悉、更不稳定,这支持使用基于不确定性的训练数据来实现可回答性感知行为。