Command Palette
Search for a command to run...
LM-Infinite:面向大语言模型的零样本极端长度泛化
LM-Infinite:面向大语言模型的零样本极端长度泛化
Chi Han Qifan Wang Hao Peng Wenhan Xiong Yu Chen Heng Ji Sinong Wang
摘要
当前的大语言模型(LLM)由于 Transformer 架构的二次复杂度,通常只能在较短文本段(如 <4K token)上进行训练。因此,当输入长度超过训练阶段所见的长度时,模型性能会急剧下降,极大地限制了其在涉及长上下文的现实任务中的应用,如编码科学论文、代码仓库或长对话。本文通过理论分析与实证研究,识别了导致长度泛化失败的三个主要因素。理论分析表明,常用的技术如滑动窗口注意力模式或相对位置编码不足以解决这些问题。针对这些挑战,我们提出了 LM-Infinite——一种简单而有效的方法,用于增强 LLM 处理长上下文的能力。LM-Infinite 具有高度灵活性,可直接应用于大多数现代 LLM。无需任何参数更新,它使以 2K 或 4K 长度段预训练的 LLM 能够泛化到长达 200M token 的输入,同时保持困惑度不变。此外,在零样本设置下,它还能提升 Passkey Retrieval 和 Qasper 等下游任务的性能。LM-Infinite 带来了显著的效率提升:相比原始模型,实现了 2.7 倍解码加速和 7.5 倍显存节省。相关代码将在论文发表后公开发布。
一句话总结
伊利诺伊大学厄巴纳-香槟分校与 Meta 提出 LM-Infinite,一种零样本方法,识别出 LLM 长度泛化失败背后的三个关键因素,并在不更新参数的情况下解决它们,使在 2K-4K token 段上预训练的模型能够处理最多 200M tokens 的输入,同时实现 2.7× 解码加速和 7.5× 内存减少。
核心贡献
-
论文提供了短上下文 LLM 为何在更长输入上失败的理论解释和实证依据,识别出三个长度泛化因素,并表明仅靠滑动窗口注意力和相对位置编码不足以解决问题。
-
论文提出 LM-Infinite,一种面向现成 LLM 的推理时长上下文泛化方法,使注意力行为更接近训练时的分布,使在 2K 或 4K 段上预训练的模型无需参数更新即可处理最多 200M tokens 的输入,同时保持困惑度。
-
评估表明,LM-Infinite 提升了 Passkey Retrieval 和 Qasper 上的零样本性能,并带来效率增益,包括相对原始模型实现 2.7x 解码加速和 7.5x 内存节省。
引言
大型语言模型通常是在约 4K tokens 以下的序列上进行训练的,因为 Transformer 的注意力机制随输入长度扩展性较差。这给需要长程上下文的应用造成了实际差距,例如科学论文理解、代码仓库和长对话。
现有工作使用了相对位置编码、滑动窗口、检索记忆或长序列微调,但这些方法仍难以解释和修复长度泛化失败。作者识别出三个核心问题:未见过的 token 距离、未见过的注意力上下文大小,以及靠近序列起点处的隐藏绝对位置效应。
作者提出 LM-Infinite,一种免训练方法,使用 Λ 形注意力掩码和注意力距离上限。这使得配备相对位置编码的现成 LLM 能够泛化到非常长的输入,在实验中达到 200M tokens,同时提升速度并降低 GPU 显存使用。
方法
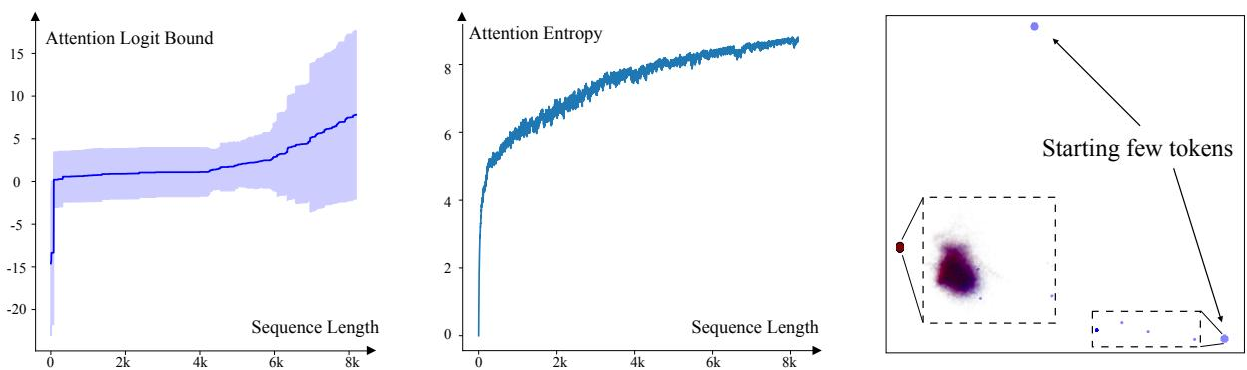
作者利用了关于 Transformer 隐藏状态的一个重要观察:即使没有显式绝对位置嵌入,最前面的几个 token 也可以在特征空间中占据一个独特区域。Llama-2 第二层隐藏状态的 PCA 投影显示,初始 token 的表示形成与后面 token 表示分离的簇。由于注意力会聚合 value 向量,移除这些起始 token 会阻止注意力输出到达与序列开头相关的特征区域。这促使在注意力中显式保留一小段起始 span。如下方可视化所示:
基于这一观察,作者提出 LM-Infinite,一种针对配备相对位置编码的 Transformer 模型的参数无关注意力机制修改。该方法面向零样本长度泛化设计:它改变注意力 logits 和注意力掩码的计算方式,但无需参数更新或重新训练。其核心架构包括 Λ 形注意力掩码、距离上限,以及可选的 top-k 中间 token 检索机制。参考下方框架图:
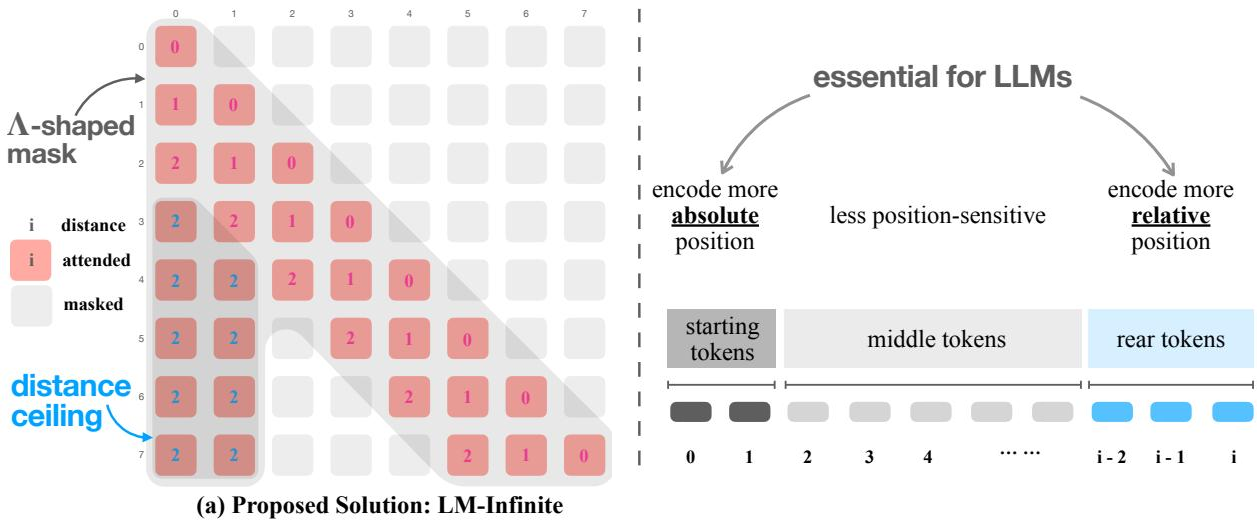
Λ 形注意力掩码将每个 token 的注意力限制为两个 span。起始 span 允许查询 token 关注最初 nstarting 个 token,条件是这些 token 出现在当前位置之前。结束 span 允许查询 token 仅关注预训练上下文长度内最近的 token。对于位置 i 的查询,被关注的集合可以写为
Ai={j≤i:j<nstarting}∪{j≤i:i−j≤Lpretrain}.所有其他中间 token 都被掩码掉。这限制了参与每次注意力计算的 token 数量,同时仍保证起始 token 保持可见。如果 nstarting=0,模型退化为近期窗口注意力模式,并失去访问初始 token 特征空间的能力,从而损害性能。
LM-Infinite 还引入了距离上限。对于相对距离为
dij=i−j,的原始相对位置注意力 logit,可以看作函数
w(qi,kj,dij).该方法用有界有效距离替换原始距离:
dij′=min(dij,Lpretrain),并计算注意力 logit 为
w(qi,kj,dij′).这一修改只有在较远的查询 token 关注起始 span 时才起作用。它防止未见过的过大规模距离值进入注意力 logit 函数,从而把位置输入保持在预训练期间观察到的范围内。
可选的 top-k 组件通过重新引入少量中间 token 来扩展掩码。对于每个注意力头,该方法可以选择注意力 logit 最大的 k 个中间 token,并将它们加入被关注集合。所选 token 在层号大于阈值层 h 的层中按注意力头独立选择。这对于需要检索长上下文中间信息的下游任务很有用,同时仍限制因序列长度增长而引入的整体注意力熵。
该设计可以概念性地概括为将长上下文划分为三个功能区域。起始 token 携带强位置敏感特征,应保持可见。后部 token 提供当前查询附近的近期相对位置信息。中间 token 编码对精确位置依赖较弱的信息,关注过多中间 token 会增加注意力熵,并在未见过的长度上使推理不稳定。
实现很轻量,因为 LM-Infinite 只改变注意力计算。对于基于 RoPE 的模型,近期窗口内的 token 遵循原始的旋转注意力计算。对于起始 span,排除其与近期窗口的重叠部分后,key 向量保持未旋转,query 向量在组成最终 logits 前被旋转至固定有效距离 Lpretrain。对于 AliBi 风格模型,位置偏移矩阵会被裁剪,使有效距离遵守同一上限,然后再应用 Λ 形掩码。这保留了原始相对位置编码接口,同时使其适应扩展的推理长度。
实验
实验在多个长上下文语言模型上评估 LM-Infinite,使用 ArXiv 和 OpenWebText2 进行语言建模,使用零样本 Passkey Retrieval 和 Qasper 进行下游任务,并使用 BLEU 和 ROUGE 进行长文本生成。结果表明,它使模型能够泛化远超预训练上下文的长度,同时保持稳定的困惑度;消融实验证实,有界 token 距离和选择性注意力对长度泛化都是必要的。它还改善长输入检索和问答,在超过训练长度后保持生成质量,并为昂贵的微调提供有前景的替代方案。
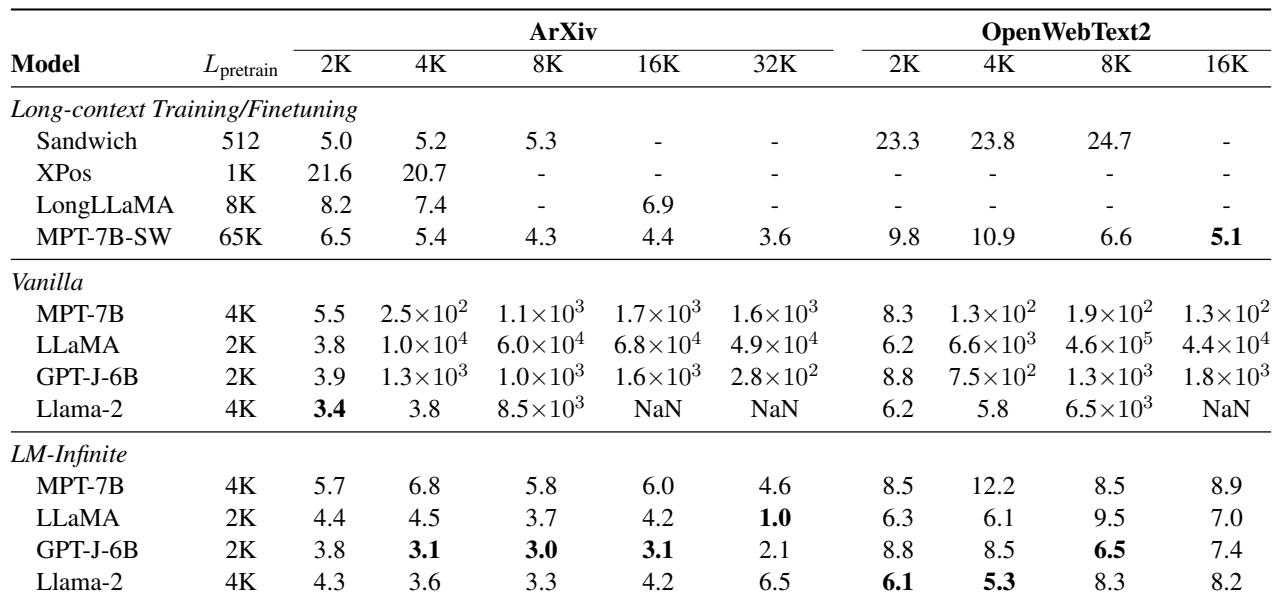
LM-Infinite 在无需参数更新的情况下改善了 ArXiv 和 OpenWebText2 上的长上下文语言建模。在评估长度上,它通常实现对比模型中最低的困惑度,尤其是在测试序列超过训练段长度时。尽管不需要微调,它仍接近微调的长上下文基线。LM-Infinite 在大多数评估长度列中获得最佳困惑度。原始基线在超过训练长度后性能急剧下降,而 LM-Infinite 保持稳定的困惑度。使用 LM-Infinite 的 MPT-7B 几乎可以匹敌微调后的 Storywriter 模型。
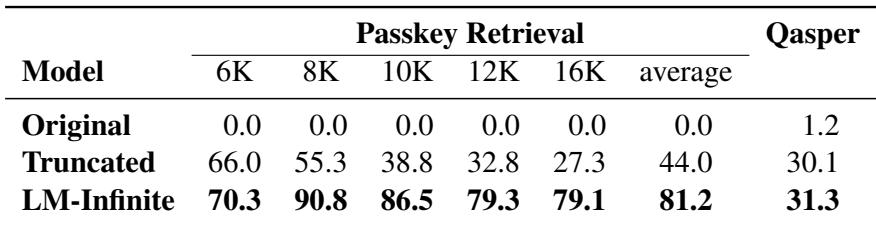
LM-Infinite 使 Llama-2 在长输入检索和问答方面优于未修改模型和截断基线。随着上下文长度增加,它保持相对较高的 Passkey Retrieval 准确率,而基线在丢弃较早上下文时会丢失有用信息。原始模型无法检索 passkey,Qasper 准确率也仅表现出很低提升。随着上下文长度增长,LM-Infinite 始终相对于截断提升 Passkey Retrieval。LM-Infinite 在 Qasper 上相对于截断带来较小的平均增益,表明更好地利用了出现在近期上下文之外的信息。
在所报告的 ArXiv 长文本生成结果中,LM-Infinite 帮助预训练模型在上下文长度超过原始训练长度时维持可用生成质量。原始 MPT-7B 和 Llama-2 在更长的里程碑处常退化到接近零的分数,而 LM-Infinite 仍然更接近强大的微调 MPT-7B-Storywriter 基线。BLEU 和 ROUGE 趋势表明,无需参数更新也能获得更好的长程生成质量。原始模型在更长的长度上出现显著生成失败,许多分数接近零。LM-Infinite 在更长序列上保持生成质量,并与微调的 MPT-7B-Storywriter 基线保持可比。将 LM-Infinite 添加到 Llama-2 在更长生成里程碑上相对原始模型带来明显改善。
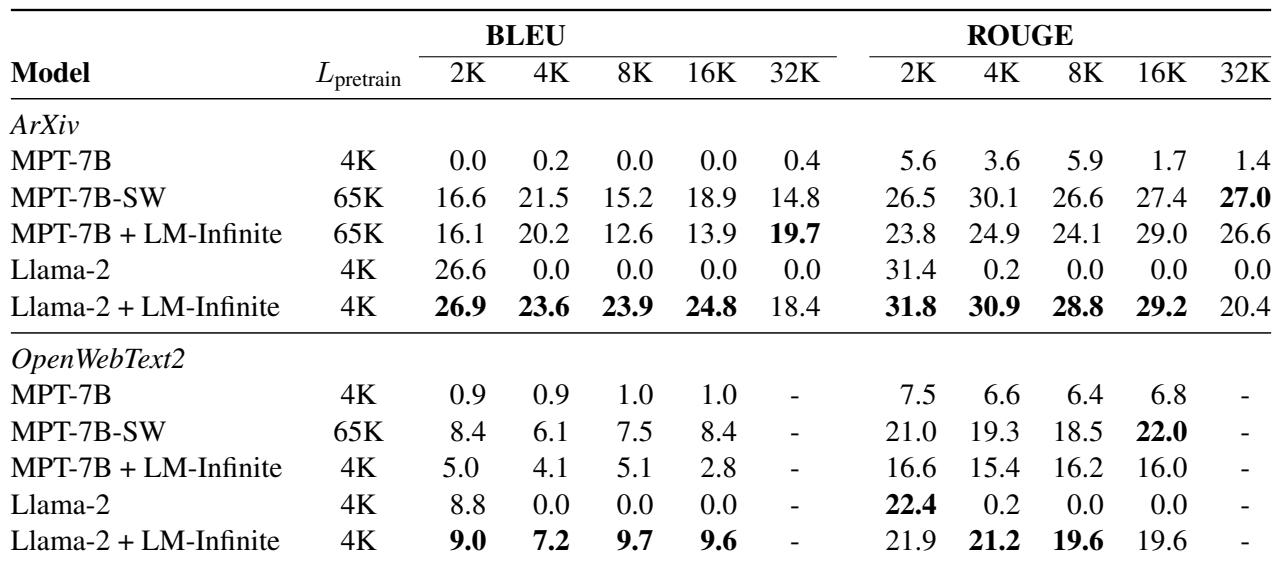
实验在长上下文语言建模、长输入检索和问答、长文本生成上评估 LM-Infinite,使用 ArXiv、OpenWebText2、Passkey 和 Qasper 基准。结果表明,当上下文长度超过原始训练限制时,它通常实现更低的困惑度,以及更稳定的生成和检索性能,而未修改或截断的基线会急剧退化。总体而言,LM-Infinite 无需参数更新即可改善长上下文行为,并接近强大的微调长上下文基线。