Command Palette
Search for a command to run...
预训练者训练数据指南:量化数据时效、领域覆盖、质量与毒性的影响
预训练者训练数据指南:量化数据时效、领域覆盖、质量与毒性的影响
摘要
预训练数据的设计严重缺乏文献记录,且往往依赖缺乏实证支撑的直觉。我们在以下三类策划数据上预训练模型:(1)不同时间点收集的数据,(2)应用不同毒性与质量过滤器的数据,(3)具有不同领域构成的数据。首先,我们发现评估数据与预训练数据之间的时间偏移会导致性能下降,且微调无法弥补这一损失。其次,我们量化了质量与毒性过滤器的影响,发现标准基准测试性能与有毒生成风险之间存在权衡关系。我们还发现,不同类型的过滤效果无法从文本领域特征中预测。第三,我们从实证角度验证了异构数据源(如书籍和网络数据)具有优势,值得给予更高的优先级。迄今为止,这些实验构成了公开记录的规模最大的预训练数据影响实证研究。涵盖 28 个从零开始预训练的 15 亿参数模型,这些发现验证、量化并揭示了许多关于文本预训练的未记录直觉,最终为模型开发中更有依据的数据导向决策提供支持。
一句话总结
来自 MIT、Cornell、Google Research 和其他机构的研究人员开展迄今规模最大的公开记录预训练数据设计实证研究,从零开始训练 28 个独特的 15 亿参数模型,以量化数据时效、领域覆盖、质量和毒性过滤对性能的影响,揭示基准分数与毒性生成风险之间的权衡,并验证长期存在的数据中心直觉。
核心贡献
-
该研究通过从零开始训练 28 个独特的 15 亿参数模型,提供了关于预训练数据筛选的可控实证证据,这些模型分别采用不同的采集时间、毒性和质量过滤器以及领域组成。该研究量化了数据集时效、过滤和来源组成如何塑造下游性能。
-
分析表明,预训练数据与评估数据之间的时间漂移会导致性能退化,且微调并不能完全克服。这确立了预训练语料时效性作为重要建模因素,而非偶然属性。
-
实验揭示,质量和毒性过滤在标准基准性能与毒性生成风险之间形成权衡,而书籍和网页数据等异构来源能带来广泛收益。结果还表明,仅凭文本领域特征无法可靠预测过滤效果。
引言
作者指出,现代语言模型依赖在大规模文本数据集上的自监督预训练,开发者会在采集时间、质量和毒性过滤以及领域组成方面做出关键选择。这些选择会强烈影响模型行为,但许多知名模型很少记录为何选择某些筛选协议,或这些协议如何影响下游性能。这种记录缺口使从业者依赖未经检验的直觉和先例,可能削弱负责任的数据使用、模型比较和开发效率。
先前工作主要关注预训练数据的规模和优化步骤数量,将筛选策略视为隐含约定,而非可测量的模型设计选择。现有过滤方法在应用时也缺乏对其下游后果的清晰理解,而预训练与评估数据之间的时间错配可能扭曲性能比较,尤其对较新或较大的模型。
作者对预训练数据筛选进行了系统研究,分析数据集时效、内容过滤和领域组成。该研究将对 C4 和 The Pile 等主要语料库的观察测量与对 28 个 15 亿参数解码器模型的受控预训练实验相结合。结果显示,时间错配会降低性能,质量过滤可能提升能力但增加毒性生成,毒性过滤可能降低危害但损害泛化,而书籍和网页数据等多样高质量来源对强下游性能仍然重要。
数据集
-
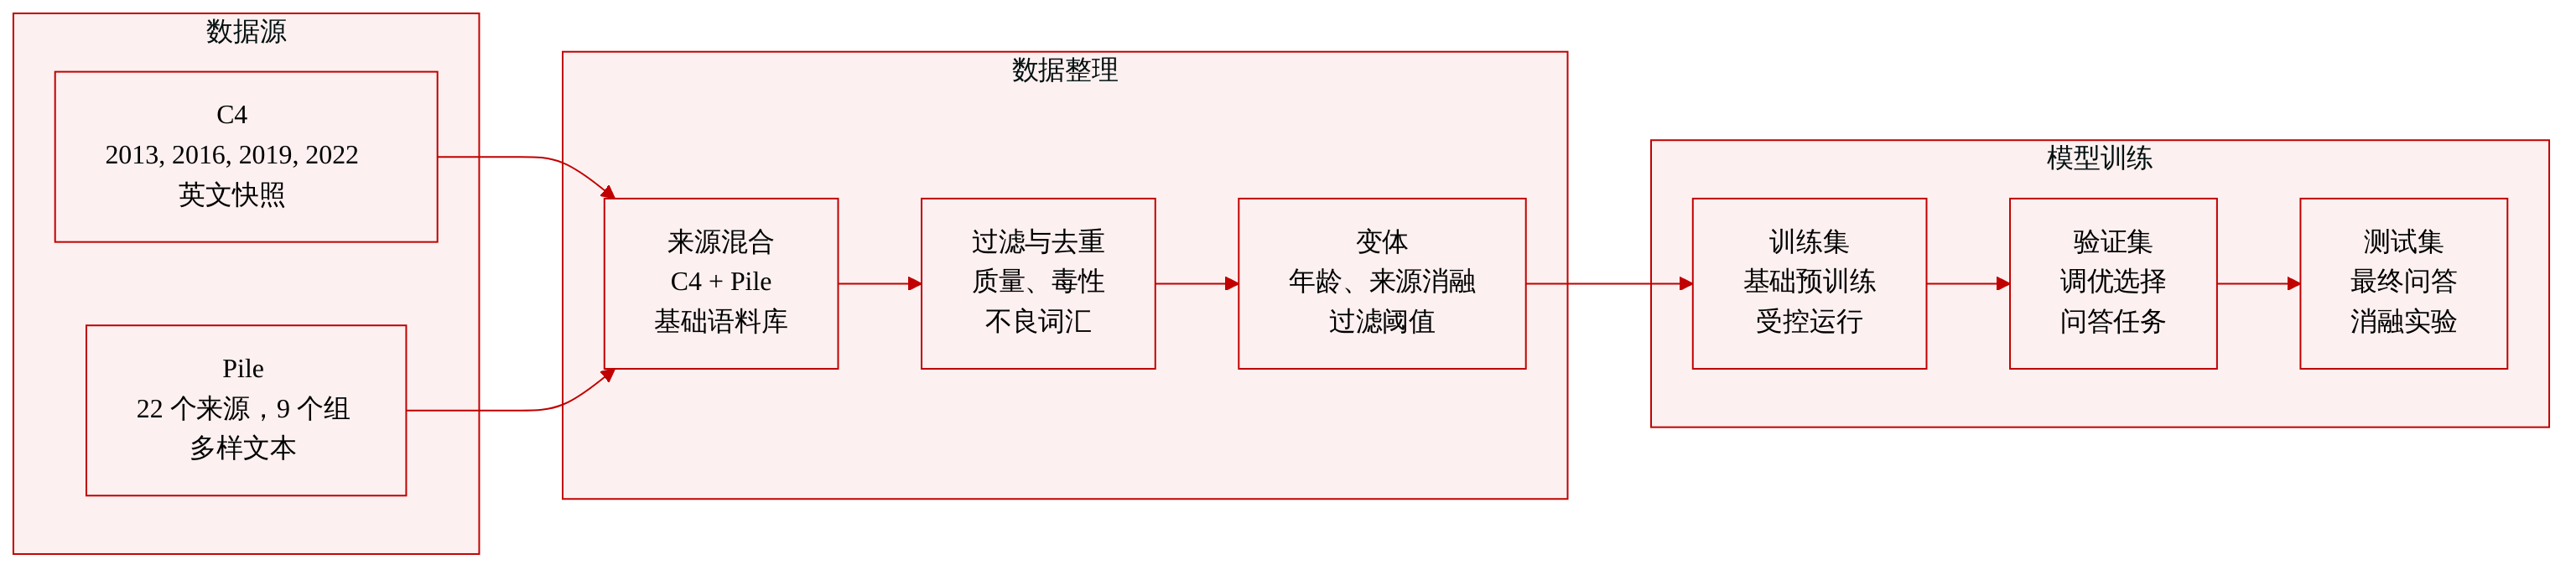
作者使用两个公开预训练语料库,C4 和 The Pile。两者都经过启发式过滤,以保留英文内容并筛选内容质量,随后去重。
-
作者基于 2013、2016、2019 和 2022 年 Common Crawl 快照创建四个 C4 变体,以研究预训练数据时效如何影响结果。
-
作者将 The Pile 的 22 个原始来源归为 9 类:Common Crawl、OpenWebText、书籍、Wikipedia、法律、社交、生物医学、学术和代码。每次消融一个类别,以测量其对多样化问答任务的影响。
-
作者应用 PaLM 和 GLaM 使用的文档级质量过滤器,将每篇文档从 0 到 1 打分,0 表示高质量,1 表示低质量。文档在 0.975、0.95、0.9 和 0.7 阈值下被过滤,并测试反向过滤器以移除质量最高的文档。
-
作者使用 Jigsaw Perspective API 在 0.95、0.9、0.7、0.5 和 0.3 阈值下进行毒性过滤,并加入一个反向过滤器以移除毒性预测最低的文档。它们还使用原始 C4 bad words 过滤器,该过滤器会移除包含所列粗俗词列表的文档。
-
论文分析数据集特征,发现质量与毒性并不高度一致。书籍子集具有更高的预测质量,但也包含更多粗俗、毒性和露骨性内容。PubMed、代码和学术文本等技术领域获得较低的预测质量分数。
-
这些数据集被用作基础预训练语料库,也被用于评估数据时效、来源组成和过滤选择影响的可控变体。
方法
作者围绕可控的数据筛选与评估流程设计实验。该流程从大规模预训练语料库出发,应用文档级过滤器生成经过筛选的子集,在该子集上训练语言模型,然后对模型进行微调并在下游任务上评估。这一设置使具体预训练数据选择与最终模型性能的可测量变化相联系。
如下图所示:
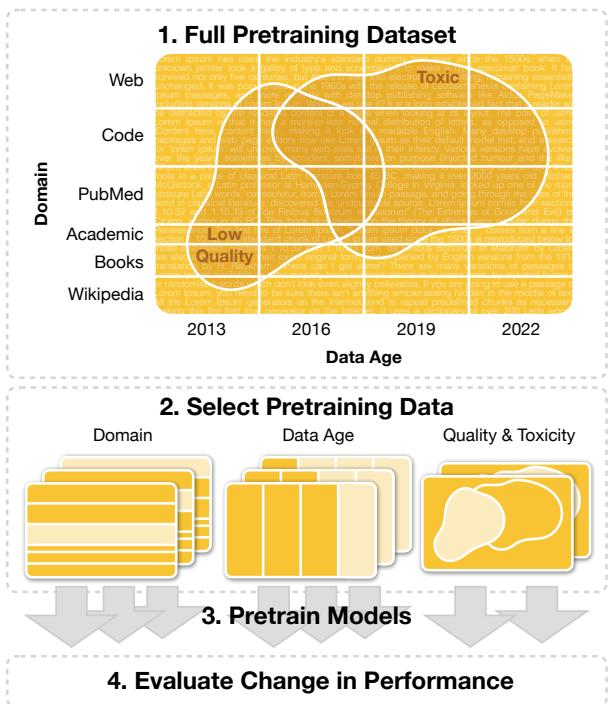
该流程由三个主要操作依次组织。首先,整个预训练数据集在多个维度上表示,包括数据来源领域、数据时效和文档级质量或毒性。其次,作者每次只变化一个维度,从完整数据池中子选择数据。第三,使用选定的数据变体预训练模型,然后测量下游性能。这使得该方法成为一种因果式比较,比较其他方面相似的训练运行,而差异被隔离在预训练数据筛选上。
数据过滤模块是方法的核心。作者考虑三类干预:时间变化、来源组成变化和基于过滤器的变化。对于时间变化,作者从不同年份创建基于 Web 的语料库的多个快照。对于来源组成变化,作者将混合来源语料库划分为 Web、书籍、百科全书、法律、社交、生物医学、学术和代码等类别,然后每次移除一个来源组以观察下游影响。流程的这一部分将预训练语料库视为结构化混合体,而非单一文本池。
质量过滤模块为每篇文档分配一个标量质量分数,并移除超过所选阈值的文档。作者扫描多个阈值,以创建逐渐更强的过滤数据集。它们还尝试该过滤器的反向操作,即移除质量最高的文档,从而检验质量过滤提升性能是因为移除坏文档、保留好文档,还是二者兼有。
毒性过滤模块使用训练好的分类器,预测文档包含有害或冒犯性内容的概率。作者应用多个置信度阈值,并评估一种反向过滤变体,移除预测毒性最低的文档。此外,它们测试一个更简单的基于 n-gram 的过滤器,移除包含粗俗词列表中任何单词的文档。这提供了基于分类器的过滤与基于规则的过滤之间的比较,二者都在文档级运行。
模型训练模块使用仅解码器 Transformer 语言模型。主要实验依赖一个 15 亿参数模型,使用自回归 next-token 预测目标训练。在扩展性研究中,还使用一个 20M 参数的小得多的模型,具有相同总体架构族。训练在 T5X 风格实现中执行,所有变体共享基本相同模型设计,以便将评估结果差异更清晰地归因于预训练数据差异,而非模型架构或训练程序。
预训练后,模型通过下游微调和基准测试进行评估。该评估阶段对方法至关重要,因为论文核心问题并非过滤数据是否改善预训练语料上的验证损失,而是不同筛选策略是否在适配后改变任务性能。通过这种方式,完整流程将数据选择决策、过滤阈值和数据混合变化直接连接到下游模型效用。
实验
实验在 C4 和 The Pile 的经筛选变体上预训练模型,然后进行微调,并在英语毒性、问答和时间敏感任务上评估它们,以研究数据集时效、质量过滤、毒性过滤和领域组成。结果表明,预训练与评估之间的时间错位会继续降低性能,尽管进行相关微调,尤其当模型更大且评估数据比预训练数据更新时。质量过滤器通常改善大多数下游任务,尽管效果因领域而异,而毒性过滤在减少毒性生成与保留毒性识别之间造成权衡。领域消融表明,多样化的 Web 和书籍数据对广泛下游性能特别重要,支持在预训练语料库中结合异构性、质量和规模的价值。
评估设置检验语料库时效、毒性和质量过滤以及领域组成如何影响微调模型行为。它将每个筛选选择与目标任务相联系,包括时间退化、毒性生成、毒性识别和跨领域问答。选择这些基准以捕获广泛数据集消融效应,同时承认毒性和质量标签仍是不完美代理。语料库时效通过时间数据集评估,以测量随时间增加导致的退化。毒性和质量过滤器使用毒性生成和毒性识别任务进行评估。领域组成通过跨越多个领域的问答基准进行评估。
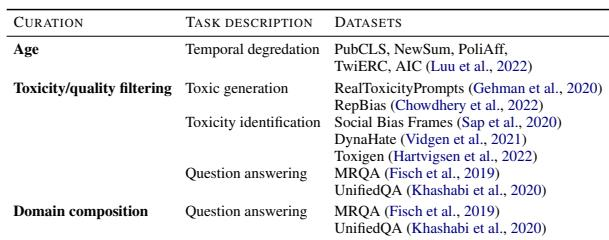
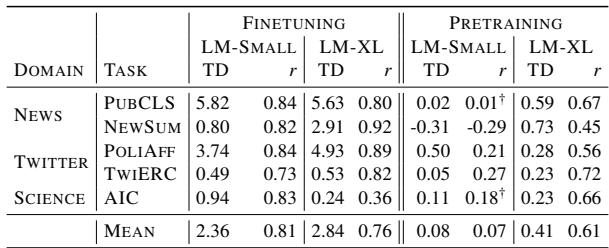
结果显示,时间错位会同时降低微调和预训练相关性能,一年的微调漂移造成的下降大于一年的预训练漂移。预训练相关退化在微调后持续存在,在新闻和依赖模型规模的场景中最为明显,而与时间间隔的相关性通常足够强,足以支持系统性效应。微调年份不匹配导致最大退化,而预训练年份不匹配仍导致显著性能损失。较大模型上的新闻任务表现出强时间敏感性,且大多数时间与性能相关性显著,仅有少数例外。
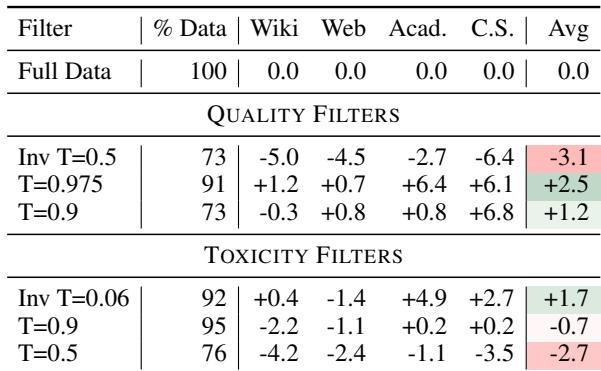
C4 上的质量过滤通常提升平均问答性能,在学术和 Contrast Set 任务上增益最强。即使移除大量预训练数据,仍可能出现增益,不过效果因领域和来源质量而异。毒性过滤造成权衡:它能减少毒性生成,但可能削弱毒性识别并损害无关的问答性能。更强的质量过滤提升平均问答性能,并尤其使学术等低质量来源领域受益。毒性过滤并不一致地改善模型行为;它可能损害无关问答,同时仅改善选定的毒性相关结果。
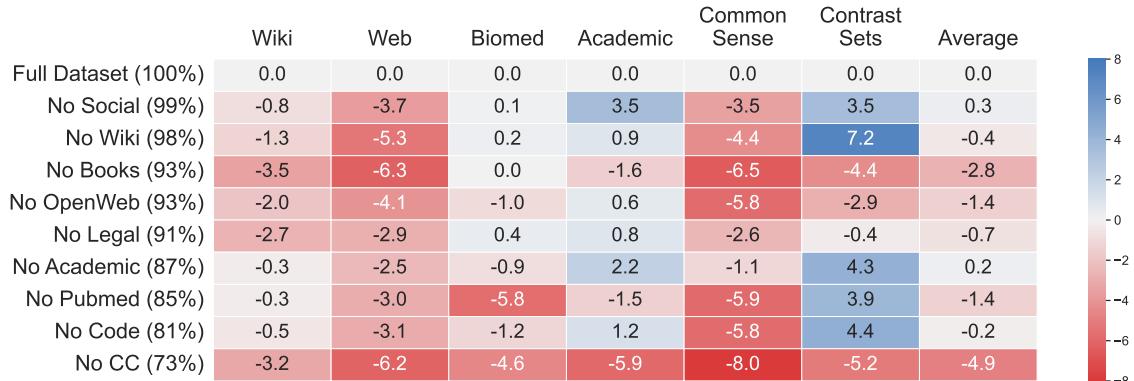
从预训练混合体中移除来源领域会在问答评估中产生不均衡影响。移除书籍导致最明显的平均下降,而移除学术文本使平均值接近基线,并可提升某些问答分数。Web 和常识问答对领域移除普遍敏感,而生物医学分数保持相对稳定。书籍移除导致最大的整体问答下降,学术移除平均而言危害最小,并提升某些问答分数。Web 问答在多数领域移除后倾向于下降,常识问答对移除多个领域敏感,生物医学问答在多数移除下变化很小。
实验评估语料库时效、质量和毒性过滤以及领域组成如何在时间、毒性和问答基准上影响微调模型行为。结果表明,时间错位系统性损害性能,尤其当微调和预训练年份不匹配时,新闻和较大模型最敏感。质量过滤通常提升问答性能,而毒性过滤仅提供选择性收益并可能损害无关问答,领域移除产生不均衡效应,书籍移除最具损害性,而生物医学问答相对稳定。