Command Palette
Search for a command to run...
解锁大语言模型中的涌现模块化
解锁大语言模型中的涌现模块化
Zihan Qiu Zeyu Huang Jie Fu
摘要
模块化神经网络(MNN)相比单体模型展现出多种优势。现有的 MNN 通常是显式的:其模块化架构被预先定义,各模块被期望实现不同的功能。近期研究揭示,标准预训练 Transformer 中存在隐式模块化结构,即涌现模块化(Emergent Modularity),并表明此类模块化结构会在预训练早期阶段自发涌现。尽管模块化具有诸多优势,大多数语言模型(LM)在预训练-微调范式中仍被视为单体模型,其涌现模块化处于被锁定且未被充分利用的状态。本工作聚焦于解锁大语言模型中的涌现模块化,展示了标准 LM 无需引入任何额外参数即可微调为混合专家(MoE)模型。此类 MoE 源自涌现模块化,被称为涌现混合专家(EMoE)。实验表明,对 EMoE 进行微调相比原始微调能有效提升下游领域内和领域外的泛化性能。分析与消融实验进一步证明该方法对多种配置具有鲁棒性,并可扩展至大语言模型(如 Llama2-7B 和 Llama-30B)。代码已开源于此仓库。
一句话总结
来自 HKUST、IIIS、清华大学和爱丁堡大学的研究人员提出 Emergent MoEs(EMoE),其利用预训练期间涌现的模块化,将标准语言模型微调为 Mixture-of-Experts 架构,且不引入额外参数,从而实现更好的域内和域外泛化,并可扩展至 Llama2-7B 和 Llama-30B。
核心贡献
- Emergent MoE 将标准预训练语言模型重新解释为隐式模块化系统:将选定的 Feed-Forward Network 层拆分为由涌现模块化导出的 Mixture-of-Experts 层,且不增加参数。
- 微调涌现式 Mixture-of-Experts 视图会暴露任务相关的专家激活,并改变训练期间的参数更新;随后可以丢弃 MoE 拆分,因此部署架构保持不变。
- 在域内和域外任务、参数高效与全量微调设置,以及包括 Llama2-7B 和 Llama-30B 在内的大模型上的实验表明,相较于普通微调,下游泛化能力更强,对配置具有鲁棒性,并能掩蔽具有负迁移效应的神经元。
引言
大语言模型越来越多地受益于模块化,因为专家式计算可以提升适应性、效率和泛化能力。研究表明,预训练 Transformer 会自发形成稀疏且任务敏感的神经元组,但标准微调把这些模型视为整体;先前的模块化变体大多复制 FFN 层,或只面向推理速度,而没有利用涌现的模块化来支持下游学习。研究团队通过将选定的 FFN 层转换为 mixture-of-experts 模块,启用这一隐藏结构,创建出 Emergent MoEs,即 EMoE。实验表明,微调 EMoE 可改善域内和域外泛化,并表现出任务相关的专家路由、更平滑的参数更新,以及可能掩蔽造成负迁移的神经元。
方法
研究团队利用将 Transformer 前馈网络解释为键值记忆的方式,把密集 FFN 转换为稀疏 Mixture-of-Experts 模块,且不新增可训练参数。对于键矩阵为 K∈Rh×d、值矩阵为 V∈Rd×h、输入为 x∈Rh、非线性激活为 σ(⋅) 的标准 FFN,其输出可写为
y=FFN(x;K,V)=σ(x⋅K)⋅V.等价地,每一列键和每一行值都可视为一个神经元或一个键值记忆对:
y=i=1∑dσ(x⋅K:,i)Vi,:.这种形式使 FFN 类似于 MoE 结构。在常规稀疏 MoE 中,FFN 被 N 个并行专家和一个门控模块替代,得到
y=n=1∑Ngn(x;G,k)FFNn(x;Kn,Vn),其中 gn 为专家赋分,Top-k 激活仅保留得分最高的专家。所提出方法通过分组现有神经元来外化这种涌现的模块化结构,而不是初始化新的专家池。
专家构建基于这样的观察:具有相似键向量的神经元倾向于被共同激活。给定预训练 FFN 层 FFN(⋅;K,V),研究团队使用约束聚类将键向量划分为 N 个专家组。令 Ei⊂[d] 表示被分配给专家 i 的键索引。对每个 j∈Ei,提取神经元 (K:,j,Vj,:) 以形成第 i 个专家 FFN(⋅;Ki,Vi)。参见框架图,该图展示了隐式键值激活模式、将键聚类为显式专家的过程,以及随后的门控机制。
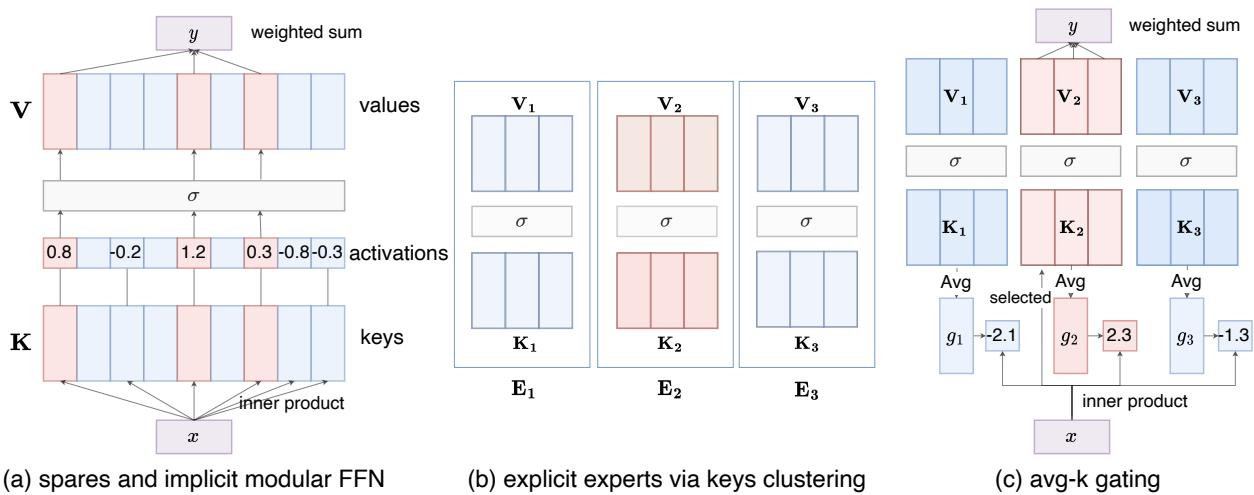
在构建专家之后,该方法通过键平均计算引入无参数门控模块。门控矩阵 G∈Rh×N 不是通过添加可训练门控网络得到,而是通过对每个专家内部的键求平均来构建:
G:,i=Avg(Ki,dim=0).对于输入 x,专家 i 的分数计算为 x⋅G:,i。由于该分数与专家内部键的预激活分数之和成正比,
x⋅G:,i=x⋅Avg(Ki)=dNj∈Ei∑xK:,ji,更大的门控值表示该专家内预期会有更多神经元强激活。最终门控输出是二值化的 Top-k 选择:
gi(x;G,k)={1,0,if i∈Top-K(x⋅G;k),otherwise.稀疏 MoE 输出随后是所选专家的加权和,只使用现有 FFN 神经元作为专家,并使用现有键向量作为门控锚点。在下游微调过程中,门控通过键平均规则与 FFN 参数保持绑定,因此该方法不会引入额外权重、额外专家初始化或额外预训练数据。
研究团队进一步分析该设计如何影响训练和推理。一个关键观察是,EMoE 的主要收益并非直接来自稀疏激活改变推理;相反,其主要收益来自影响 LoRA 权重的学习方式。为分离这些影响,该方法可在不同阶段应用。在一种变体中,先对普通模型使用 LoRA 微调,然后仅在推理时将其拆分为 EMoE 专家。该设置主要测试测试时的稀疏激活是否能提升泛化。在另一种变体中,先将模型转换为 EMoE,在稀疏专家激活下使用 LoRA 微调,然后合并回标准 FFN 进行推理。该设置测试 EMoE 是否改善训练期间的参数更新。如比较训练和推理变体的图表所示,使用 EMoE 微调再合并回去可以保留大部分收益,而仅在推理时应用稀疏激活平均只带来很少提升。
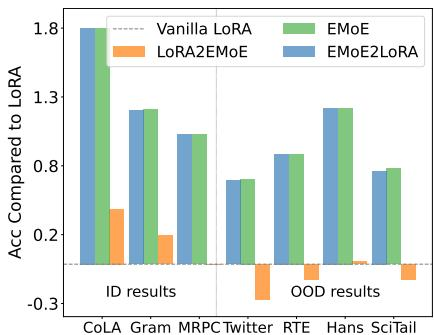
这一结果支持一种实用训练流程:EMoE 可用作微调时的正则器或专家路由机制,而得到的模型可以转换回原始密集架构进行部署。研究团队报告,该属性也不局限于 LoRA,并可用于全量微调设置。
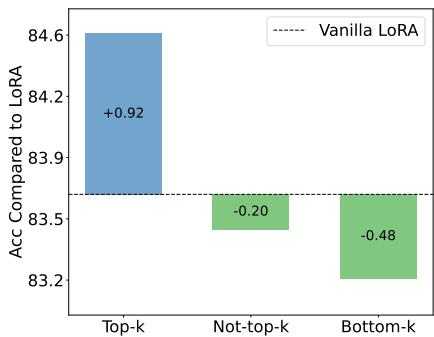
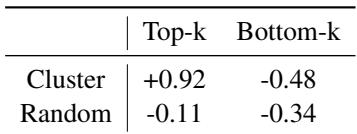
机制性解释聚焦于低分神经元造成的负迁移。由于 EMoE 通过 Top-k 专家选择屏蔽部分激活神经元,研究团队比较不同专家选择规则,以测试被屏蔽专家是否有害。选择 Top-k 专家优于普通 LoRA 微调,而 Bottom-k 和 Not-top-k 选择表现更差。这一模式表明,被掩蔽的神经元并非仅仅用处较小;它们可能主动干扰学习。下图比较图表总结了不同专家选择规则下的相对训练准确率。
实验
实验在域内和域外基准上,主要于 LoRA 微调设置下,评估 EMoE 在 BERT、GPT2 和 Llama 模型上的表现,并与普通 LoRA 和 GMoE 进行比较。结果显示,EMoE 在使用很少或没有额外可训练参数的情况下稳定提升微调性能,增强域外泛化,并且比学习门控变体更稳定。进一步分析与消融表明,基于键向量的专家构建能够揭示依赖任务的模块化,EMoE 主要受益于微调期间的权重更新而非推理,其增益来自掩蔽发生负迁移的神经元,而非稀疏激活、MoE 结构或仅剪枝本身。
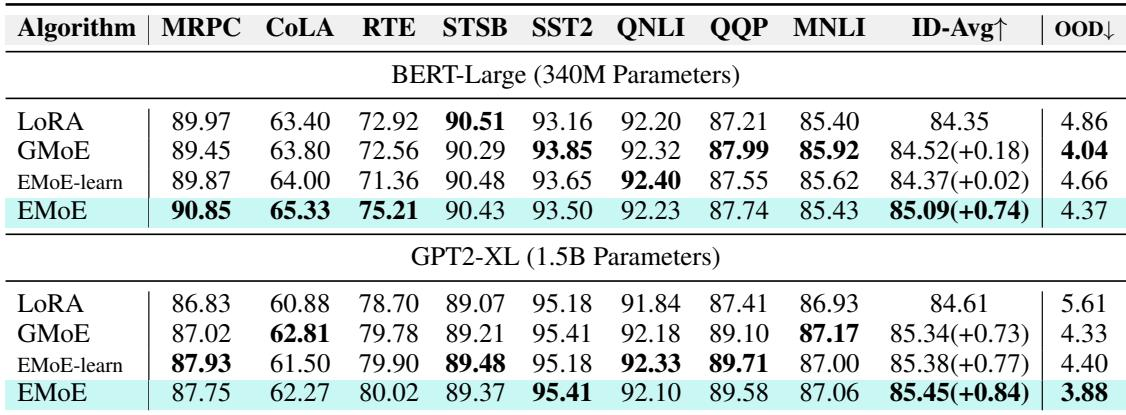
所报告的 BERT-Large 结果显示,EMoE 相较普通 LoRA 和学习门控消融提升了平均域内性能。与 LoRA 相比,EMoE 也降低了平均域外排名,尽管在列出的 BERT-Large 行中,GMoE 具有最低的报告 OOD 排名。总体来看,EMoE 提供最强的域内平均性能,同时相对于普通 LoRA 基线保持改善的域外排名。EMoE 在 BERT-Large 变体中给出最高报告域内平均值。avg-k EMoE 变体在平均域内性能上优于学习门控消融。EMoE 相较普通 LoRA 改善平均 OOD 排名,而 GMoE 显示最低报告 OOD 排名。
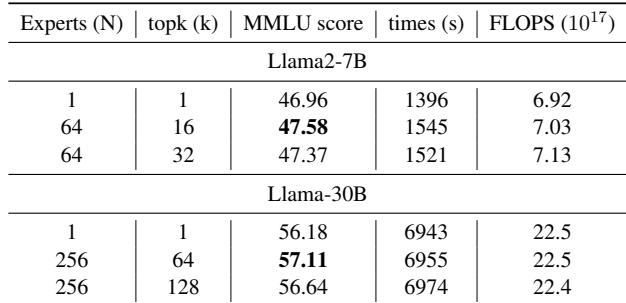
对指令微调 Llama 的评估显示,稀疏专家路由在 7B 和 30B 规模上都相对单专家 LoRA 基线提升 MMLU 准确率。7B 设置以较小开销带来小幅准确率提升,较大的 top-k 设置表现略优。30B 设置也提升准确率,同时实际运行时间和 FLOPS 几乎不变。EMoE 式专家选择在 Llama 模型上相对普通 LoRA 微调提高 MMLU 分数。7B 模型在训练成本仅有小幅增加的情况下从稀疏专家选择中获益。30B 模型以几乎不变的计算时间和 FLOPS 实现更高准确率。
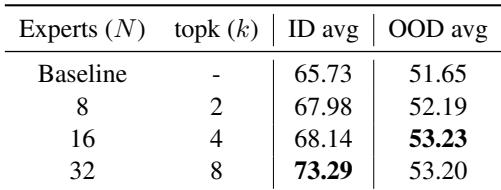
在 T5-base 多任务设置中,EMoE 配置相对基线同时提升分布内和分布外平均准确率。更大的专家预算和更高的 top-k 值主要提升分布内性能,而分布外收益较小并可能趋于饱和。EMoE 设置在 ID 和 OOD 平均准确率上都优于基线。增加专家数量和被选专家数量会提高 ID 平均准确率,在 32 专家设置中增益最大。OOD 准确率提升小于 ID 准确率,并可能在较小专家预算下饱和。
基于聚类的专家构建与 top-k 选择搭配时改善平均结果,而随机构建相对普通微调降低性能。在 bottom-k 选择下,两种构建方法都出现退化,说明选择策略和专家组织方式共同影响结果。在 top-k 选择下,基于聚类的专家更有帮助,而随机专家损害性能。bottom-k 选择会降低聚类和随机两种构建的性能。
实验在 BERT-Large、指令微调 Llama 模型和 T5-base 上评估 EMoE,并通过专家构建与选择的消融来验证设计。EMoE 相对普通 LoRA 和学习门控消融稳定提升域内或分布内性能,相对基线也改善域外结果,尽管某些替代方法如 GMoE 可能在域外排名上更强。基于聚类的专家与 top-k 选择最有效,而 bottom-k 选择和随机专家构建会降低性能。