Command Palette
Search for a command to run...
仇恨符号还是仇恨之人?用于 Twitter 仇恨言论检测的预测特征
仇恨符号还是仇恨之人?用于 Twitter 仇恨言论检测的预测特征
Zeerak Waseem Dirk Hovy
摘要
以种族主义和性别歧视言论为形式的仇恨言论在社交媒体上屡见不鲜。因此,许多社交媒体服务致力于解决仇恨言论的识别问题,但仇恨言论的定义差异显著,且主要依赖人工工作(BBC, 2015; Lomas, 2015)。我们基于批判种族理论提出了一套标注标准,并利用该标准对一个包含超过 16k 条推文的公开语料库进行标注。我们分析了多种超语言特征与字符 n-gram 相结合对仇恨言论检测的影响。我们还基于数据中最具指示性的词汇构建了一个词典。
一句话总结
哥本哈根大学提出了一种面向 Twitter 的仇恨言论检测框架,该框架的标注标准基于批判种族理论,构建并标注了一个超过 16k 条推文的语料库,并分析语言外特征与字符 n-gram 相结合对识别仇恨言论的影响。
核心贡献
- 针对仇恨言论人工定义不一致的问题,论文提出了一套基于批判种族理论的标准,并发布了一个超过 16,000 条推文、针对种族主义和性别歧视内容进行标注的语料库。
- 该研究分析了字符 n-gram 与语言外人口统计和地理特征,表明字符级特征提供了强有力的基线,而大多数非语言特征几乎没有提升检测效果,性别除外。
- 该研究还引入了一个由标注数据中最具指示性的词语构成的词表,并评估哪些特征组合能产生最佳仇恨言论识别效果。
引言
在线仇恨言论是社交媒体平台内容审核面临的重大挑战,系统必须在保护言论自由和公共安全的同时识别辱骂性帖子。已有研究受限于模糊定义、依赖脏话列表或狭窄的词汇线索,并且对人口统计因素或有效语言学特征的分析不足。作者引入了一个包含 16k 条推文的仇恨言论语料库,并分析检测特征,发现字符级 n-gram 提供了强有力的基线,而除性别之外的其他人口统计信息带来的实际收益很小。
数据集
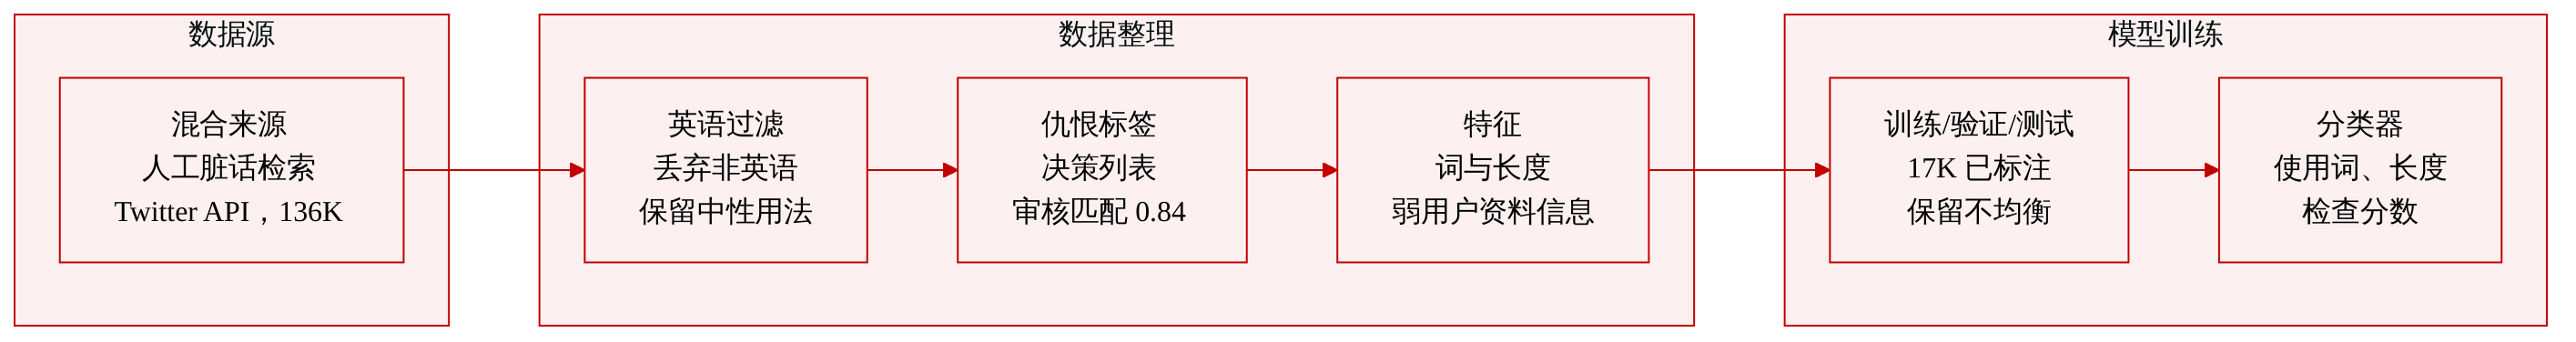
- 作者基于在 2 个月内收集的推文构建 Twitter 仇恨言论语料库,共检索到 136,052 条推文,并标注了 16,914 条推文。
- 标注集有意保持不平衡,以保留真实的类别分布。该集合包含来自 613 名用户的 3,383 条性别歧视推文、来自 9 名用户的 1,972 条种族主义推文,以及来自 614 名用户的 11,559 条既非性别歧视也非种族主义的推文。计划通过 GitHub 发布的格式为推文 ID 和标签。
- 语料库收集首先通过人工检索常见侮辱词,以及与宗教、性、性别和族裔少数群体相关的词语进行。根据这些结果,作者识别出高频仇恨言论词语、相关实体(例如 #MKR 话题标签)以及一小部分高产用户,然后使用公开 Twitter 搜索 API 收集更大的语料库。
- 过滤掉非英语推文。该收集策略旨在纳入在中立语境中包含潜在冒犯性词语的非冒犯性推文,因此标签基于词语的使用方式,而不是敏感词的出现与否。
- 标注遵循明确的仇恨言论判定列表。如果推文使用性别或种族侮辱词、攻击或企图压制少数群体、在没有充分论据的情况下批评少数群体、宣扬仇恨言论或暴力犯罪、使用稻草人谬误、歪曲关于少数群体的事实、支持有问题的话题标签、对少数群体进行负面刻板化、为仇外心理或性别歧视辩护,或者含义模糊但与带有冒犯性的用户名以及符合限定条件的主题相关,则该推文被视为冒犯性内容。
- 为减少标注者偏差,作者请外部标注者审核其标签。标注者间一致性为 kappa = 0.84。大多数分歧发生在性别歧视标注中,并且大多数审核修改将推文移入非仇恨类别,通常由上下文差异导致。
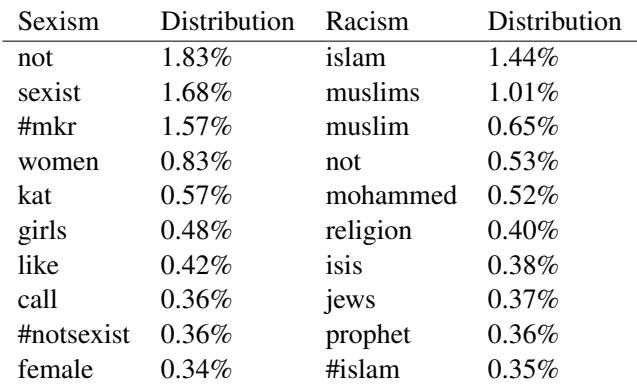
- 在文本处理中,作者除“not”外移除停用词,并移除转推标记(例如“RT”)、用户名和标点符号。作者还推导每个类别中的高频词,显示出显著的类别特定词汇模式,包括种族主义推文中与 Islam 和 Judaism 相关的词语,以及性别歧视推文中与电视竞赛相关的词语。
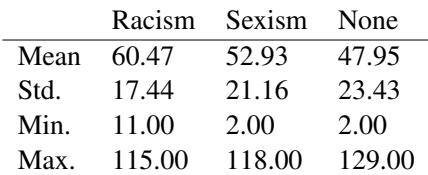
- 作者添加简单量化特征,包括平均推文长度、总推文长度以及用户简介长度,作为区分仇恨言论和非仇恨言论推文的潜在特征。
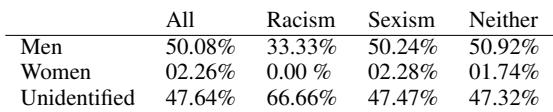
- Twitter 不直接提供性别,因此作者从个人简介文本、显示名称、用户名、代词、敬称和性别相关名词推断性别。仇恨言论用户明显偏向男性,但许多用户无法识别,这限制了性别作为特征的价值。
- 由于只有约 2% 的用户披露位置,地理信息稀疏。作者通过明确的位置标签、时区,以及推文或用户元数据中的位置提及来推断位置。在可能情况下,位置会被映射为经度和纬度,像“Sydney”这样的具名位置也可作为分类特征。作者指出位置特征对 F1 score 产生负面影响。
- 作者将标注语料库作为仇恨言论分类实验的标注数据,依赖词汇特征、推文和个人简介长度,以及从语料库派生的弱人口统计或地理元数据。
实验
实验使用逻辑回归、10 折交叉验证和网格搜索,比较分类任务的不同特征集。结果表明,字符 n-gram,尤其是长度最多为 4 的 n-gram,优于词 n-gram,并形成最有效的表示,可能因为它们更不稀疏。添加性别可获得最佳整体配置,但仅带来轻微且不具统计显著性的改进;位置和长度特征会降低性能。特征权重分析表明,具有影响力的 n-gram 在很大程度上与高频判别性词语一致,包括性别相关侮辱词和被挪用的普通词。
性别分析发现,在各类仇恨言论的已识别性别分布中,男性占多数,而女性非常稀少。许多用户仍未被识别,尤其在种族主义内容中,这限制了性别作为特征的价值。性别歧视推文与非仇恨推文中的性别模式相似,表明仅靠性别不太可能显著区分这些群体。在所有仇恨类别中,已识别性别标签中的大多数为男性。种族主义文档中未识别用户比例最高,并且没有识别出的女性。
性别歧视推文与种族主义推文的词汇分布存在强烈差异。种族主义列表以 Islam 相关词语为主,而性别歧视列表混合了 sexist、women 等词语,以及来自 My Kitchen Rules 的数据集特定标记。not 在两个类别中都很突出。与 Islam 相关的 tokens 在种族主义类别中处于核心地位。#mkr 及相关名称反映了性别歧视数据中的采样效应。
种族主义内容的平均字符长度最高,非仇恨内容最低,性别歧视内容居中。种族主义内容的变异性最窄,而非仇恨内容分布最宽,并包含更短的最小样例。所有类别中报告的长度范围都达到相似的高极值。种族主义内容具有最大平均长度和最窄分布。非仇恨内容具有最低平均长度,并包含更短的最小样例。
字符 n-gram 特征产生明显更强的分类器性能,优于词 n-gram 特征。在字符 n-gram 模型中添加性别可获得最佳结果,尽管改进较小。添加位置或长度会降低性能,而包含性别和位置的结果是唯一被认定为具有统计显著性的结果。字符 n-gram 明显优于词 n-gram。性别是唯一能提升得分的附加特征,而位置和长度特征不利。
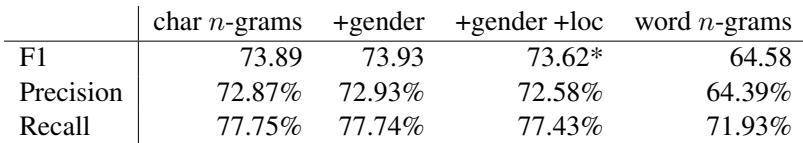
短字符 n-gram 是仇恨言论检测中最具指示性的特征,并在性别歧视和种族主义中呈现不同模式。与性别歧视相关的线索主要来自包含 sexist 和 women 相关词语片段的 n-gram,而与种族主义相关的线索主要来自与 Islam 和负面挪用相关的片段。字符 n-gram 优于词 n-gram,添加性别可获得最强结果,而位置和长度特征会降低效用。字符 n-gram 在检测仇恨言论时明显优于词 n-gram。与性别歧视相关的特征以包含 sexist 和 women 相关词片段为中心。与种族主义相关的特征以包含 Islam 和负面话语相关片段为中心。性别可轻微提升性能,而位置和长度特征没有帮助。
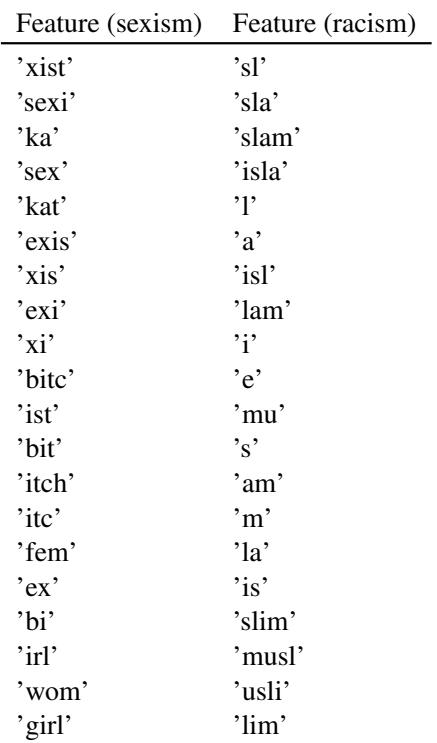
这些实验考察用户性别、词汇内容、推文长度和元数据是否为区分仇恨言论类别提供有用信号。性别分析显示,已识别用户以男性为主,许多用户未知,尤其在种族主义内容中,并且与非仇恨或性别歧视材料之间几乎没有区分度。词汇和长度模式因类别而异:种族主义推文以 Islam 相关词语为中心且平均长度更长,而性别歧视推文反映数据集特定线索和与 women 相关的词汇。分类器结果表明,字符 n-gram 最有效,短字符片段揭示出不同的性别歧视和种族主义线索,性别带来轻微改进,而位置和长度通常无用。