Command Palette
Search for a command to run...
概率 Earley 解析器作为心理语言学模型
概率 Earley 解析器作为心理语言学模型
John Hale
摘要
在人类句子加工中,认知负荷可以有多种定义方式。本报告考虑了以下认知负荷的定义:在句子某一位置处已被排除的所有结构选项的总概率,即短语结构语言模型中词 w_i 在其前缀 w_0...i-1 条件下的意外度。这些负荷可以通过概率 Earley 解析器(Stolcke, 1995)高效计算,该解析器被解释为逐词地生成关于阅读时间的预测。在由语料库频率数据所支持的语法假设下,Stolcke 的概率 Earley 解析器能够正确预测与花园路径结构歧义以及主语/宾语关系从句不对称性相关的加工现象。
一句话总结
约翰霍普金斯大学的研究人员证明,Stolcke 的概率 Earley 解析器被解释为基于短语结构语言模型逐词生成阅读时间预测;根据词 wi 在其前缀 w0...i−1 条件下的 surprisal 值,该模型能够正确预测人类句子处理中的花园路径结构歧义以及主语和宾语关系从句不对称性。
核心贡献
-
该论文为句子处理中的认知负荷给出了计算定义,把每个词上的负荷视为被当前前缀否定掉的短语结构替代分析的全部概率。这种负荷可以由概率 Earley 解析器产生的前缀概率高效计算。
-
论文构建了一种完全并行语言模型,其中层级 PCFG 概率生成逐词处理预测。花园路径难度以及主语和宾语关系从句不对称性由即时排除解释,而不是由重新分析的顺序解释。
-
利用语料库频率数据和经验性推导的语法,该模型刻画了结构歧义以及主语和宾语关系从句加工现象。结果支持使用短语层面的条件频率解释理解效应,并生成可检验的心理语言学预测。
引言
在人类句子理解和语音识别中,系统必须把说话人的语法知识与逐词增量处理句子的表现连接起来。这一点很重要,因为解析决定歧义如何消解,以及句子在实时阅读或听音过程中显得有多困难。以往工作常诉诸自主加工原则,从而把语法和处理分开;传统的 n-gram 语言模型缺少层级句法结构,而概率上下文无关语法又不便于在线使用,因为它们主要为完整句子分配概率。基于频率的模型也未能确定,短语层面的统计量是否是解释局部性及其他约束之外的理解效应所必需。
作者利用 Stolcke 的概率 Earley 解析器和概率上下文无关语法,将句子处理建模为一个由概率驱动的即时过程。他们计算前缀概率和逐词 surprisal,把处理难度视为对可能性较低的句法替代分析的在线排除。其主要贡献是一种完全并行解析理论,其中短语层面的概率语法能够解释结构歧义和加工表现效应,同时只需要最少的语法外机制。
方法
作者采用概率 Earley 解析器作为核心模型。该框架结合了概率上下文无关语法、维护活跃解析假设的 Earley 图表,以及一个跟踪语法规则上前缀概率的概率累积过程。规则概率根据已解析语料库中的相对频率估计,因此该语法通过将观察到的句法选择转换为非终结符类别扩展上的条件概率来训练。
一个 Earley 状态记录到目前为止已处理的输入位置、当前正在考虑的语法规则、表示规则已被识别多少的点位置,以及该规则所生成子串的左边界。解析器有三种操作。Predict 为可以扩展点右侧紧邻非终结符的语法规则引入新状态。Scan 在下一个所需符号与输入词匹配时,使点跨越一个输入词向前移动。Complete 将成功的自底向上识别结果传播回正在等待新识别成分的状态。这些操作使解析器能够维护所有与输入前缀相容的推导。
概率扩展为每个状态增加两个量。第一个是 α,即前缀或前向概率,它存储与已见输入一致且通向该状态的全部推导的总概率。第二个是 γ,即内部概率,它存储一个未完成短语的内部结构概率。Predict 将当前前缀概率乘以所选语法规则的概率。Scan 不改变概率。Complete 通过把正在期待的状态的 α 值乘以已完成成分的 γ 值,将自顶向下的预测与自底向上的识别结合起来。当多个先行状态可以产生同一个新状态时,它们的贡献相加。
位置 n 的前缀概率是所有与观察到的前缀相容推导的概率之和。公式形式如下:
αn=d∈D(x1:n)∑P(d)其中 x1:n 是输入前缀,D(x1:n) 是与该前缀相容的推导集合。由于 Earley 路径与最左推导一一对应,解析器可以不必显式枚举树,而是通过对解析器操作求和来计算前缀概率。
模型还定义了解析器行为与处理难度之间的联结假设。前缀总概率被解释为仍与输入相容的所有分析的概率质量。当一个词减少该概率质量时,解析器必须否定之前相容的结构。认知负荷被建模为某个词出现前后前缀概率的对数比:
log(αnαn−1)该量捕获了同时否定在该词之前仍活跃、但在该词之后不相容的结构所产生的综合难度。
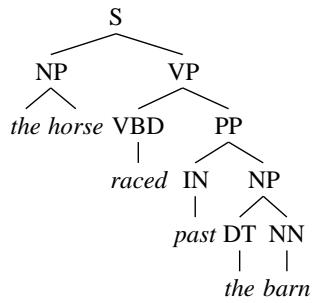
为了说明这一机制,方法考察了一个词允许两种结构解读的情形。一种解读把相关动词视为句子的主要谓语。参见下图。
竞争的解读把同一个词视为缩减关系从句内部的过去分词。如下图所示:
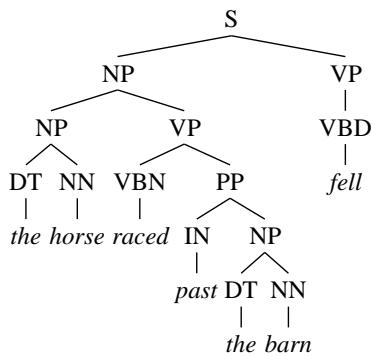
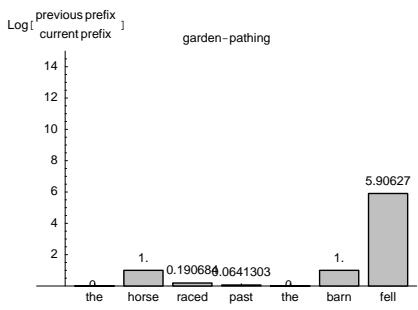
在简单语法下,两种解读都会一直可用,直到后面的词使其中一种解释不可能。主要动词结构最初概率高得多,但它无法在最后一个词处存活,而缩减关系从句结构确实能够存活。由此产生的前缀概率下降会在触发排除的那个词上产生较高的预测加工代价。简单语法给出的预测曲线如下所示。
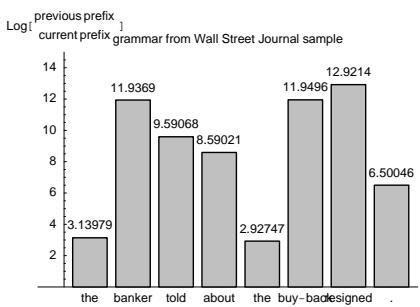
当解析器使用丰富得多的经验性语法时,也会应用同样的逻辑。在这种设定下,中间位置可以保持更多语法替代假设,因此解析器可能在每个词上排除更多假设。词汇语境也会增加 surprisal,因为可预测性较低的词携带更多信息。尽管如此,结构性花园路径效应仍然可见,表现为迫使拒绝高概率分析的那个词上出现较大的前缀概率下降。如下图所示:
实验
实验评估概率解析器对花园路径缩减关系从句的预测,比较歧义性主要动词加缩减关系从句句子和无歧义的主语关系从句控制条件。结果表明,插入 who was 等材料会压制竞争性的主要动词解读,并预测控制条件加工更快;同时,尽管词汇歧义更大,完全经验性语法仍在最终动词处预测花园路径效应。总体来看,结果支持完全并行主义,把结构花园路径化解释为竞争性解释的共时可用与取消。