Command Palette
Search for a command to run...
MKA:面向端到端专业任务的多模态知识智能体评测
MKA:面向端到端专业任务的多模态知识智能体评测
摘要
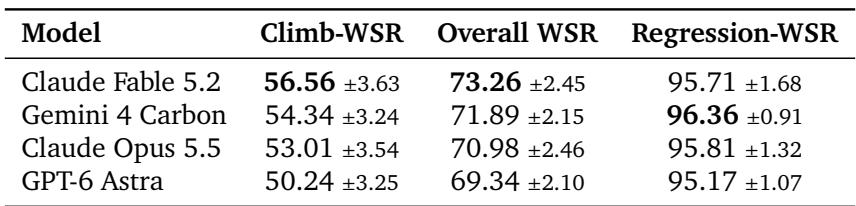
我们提出了多模态知识智能体(MKA)基准,用于衡量自主智能体在依赖视觉理解的端到端专业知识工作中的表现。每项任务都要求智能体从多个视觉信息密集的文件中提取并整合信息,例如 CAD 蓝图、电子原理图、放射影像、复杂图表和地理空间地图,并生成 .xlsx、.pptx、.pdf、.docx、.html 或 .png 格式的独立交付成果。现有基准在很大程度上尚未检验这一能力:移除图像查看工具后,Gemini 4 Carbon 在 GDPval(Patwardhan 等,2025)上的得分保持不变(第 4.3 节),而 GDP.pdf(Garre 等,2026)和 GDP.xlsx(Surge AI,2026)等单一格式评测并不要求跨文件或跨模态推理。MKA 包含覆盖 10 个经济部门的 200 项任务。交付成果由沙箱化的智能体自动评分器依据专家加权评分标准进行评分,在我们的专家评分研究中,该评分器与人类领域专家在 96.2% 的标准判断上达成一致(Cohen's κ = 0.91),并以加权满足率(WSR)进行总体评分,同时针对先前一代模型尚未饱和的前沿标准进行评分(Climb-WSR)。在我们评测的前沿模型中(Gemini 4 Carbon、Claude Fable 5.2、Claude Opus 5.5 和 GPT-6 Astra),Claude Fable 5.2(Climb-WSR 为 56.6%,总体 WSR 为 73.3%)和 Gemini 4 Carbon(Climb-WSR 为 54.3%,总体 WSR 为 71.9%)取得了最高分,而 Carbon 使用的 token 数量少 5.7 倍。即使对于最强的模型,Climb-WSR 仍低于 57%,为多模态智能体留下了巨大的提升空间。
一句话总结
Google DeepMind 与 Artificial Analysis 提出了 Multimodal Knowledge Agent (MKA) 基准,这是一项包含 200 个任务、覆盖 10 个行业领域的自主 agent 评估,衡量 agent 执行端到端专业知识工作的能力;这些工作需要从视觉密集的文件中提取并整合信息,并产出独立交付物。与以往基准不同,MKA 采用与专家对齐的沙箱化自动评分器,该评分器在 96.2% 的标准判定上与人类领域专家一致(Cohen’s κ=0.91);评估中最强的模型 Claude Fable 5.2 和 Gemini 4 Carbon 分别仅达到 56.6% 和 54.3% 的 Climb-WSR。
核心贡献
- 本文提出了 Multimodal Knowledge Agent (MKA) 基准,这是一个跨 10 个行业领域的 200 任务评估。在该评估中,agent 必须整合来自多个视觉密集文件的信息,例如 CAD 蓝图、电子原理图、射线影像、复杂图表和地理空间地图,并产出 .xlsx、.pptx、.pdf、.docx、.html 或 .png 格式的独立交付物。
- 本文贡献了一个沙箱化的 agentic 自动评分器。该评分器依据专家加权评分标准对交付物进行评分,报告总体加权满意率以及先前一代模型尚未饱和标准上的 Climb-WSR,并且在 96.2% 的标准判定上与人类领域专家一致(Cohen's kappa = 0.91)。
- 基准评估显示,Claude Fable 5.2(Climb-WSR 56.6%,Overall WSR 73.3%)和 Gemini 4 Carbon(Climb-WSR 54.3%,Overall WSR 71.9%)在已评估的前沿模型中取得最高分,其中 Gemini 4 Carbon 使用的 token 少 5.7 倍。评估还发现,移除视觉工具会降低 Climb-WSR,同时增加轮次(1.28 倍)和输出 token(1.40 倍);并且最高 Climb-WSR 仍低于 57%,为多模态 agent 留下了大量提升空间。
引言
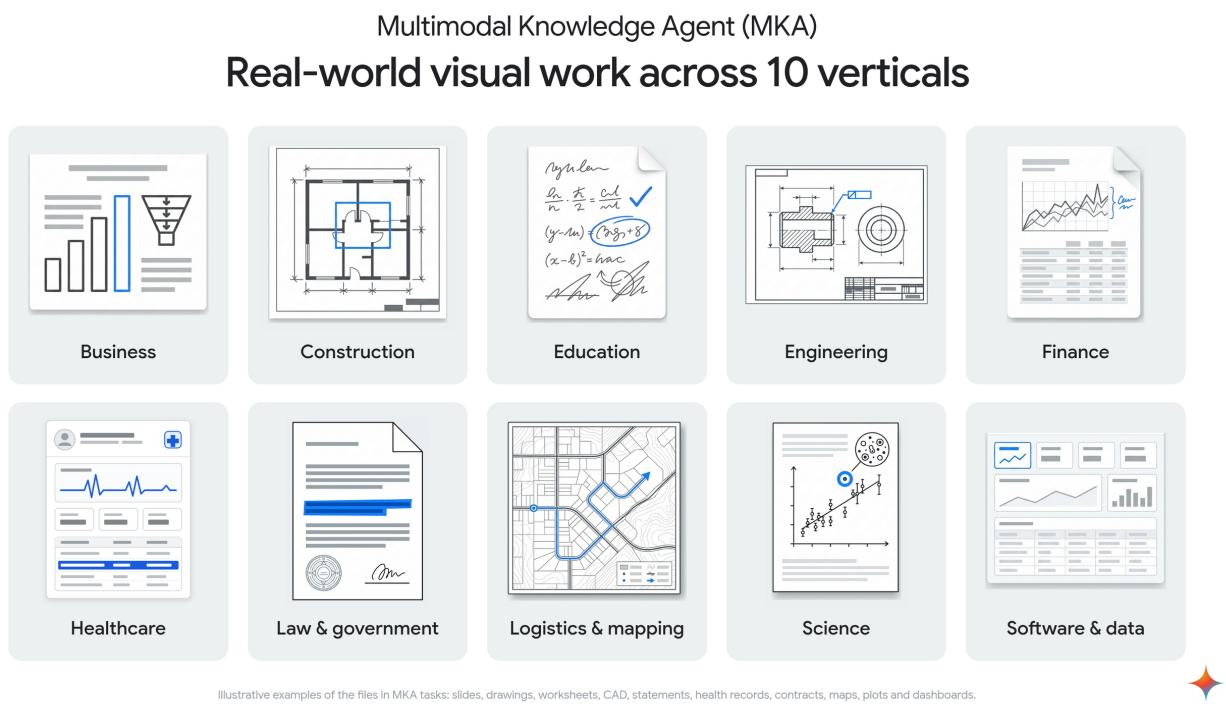
现实世界中的知识工作具有高度视觉性,专业人员需要解读图表、原理图、图形和扫描文档,同时核验所产出文件的版式。然而,前沿 agent 表现出文本和代码偏好:它们将文件转换为纯文本或 Markdown,依赖脆弱的 OCR 或计算机视觉脚本,并且在直接查看图像时仍然存在几何盲区和文本先验偏差。现有基准未能捕捉到这一点,因为工作场所套件通常允许通过脚本提取对任务至关重要的信号,而视觉问答、电子表格、浏览和 GUI 基准则将多模态推理限制为单轮答案、表格数据、短字符串或像素级点击。为解决这一问题,作者提出了 MKA,这是一个包含 200 个任务、覆盖 10 个行业领域和 83 种职业的基准,包含异构视觉工件,如平面图、原理图、路线图和射线影像;其中 88% 的任务需要独立文件交付物。作者将其与一个沙箱化的 Agentic Autorater 配对,该评分器以视觉方式渲染输出并以编程方式检查输出,并表明视觉对交付物质量和计算效率都起关键作用,而顶级模型仍留有显著提升空间。
数据集
数据集构成与来源
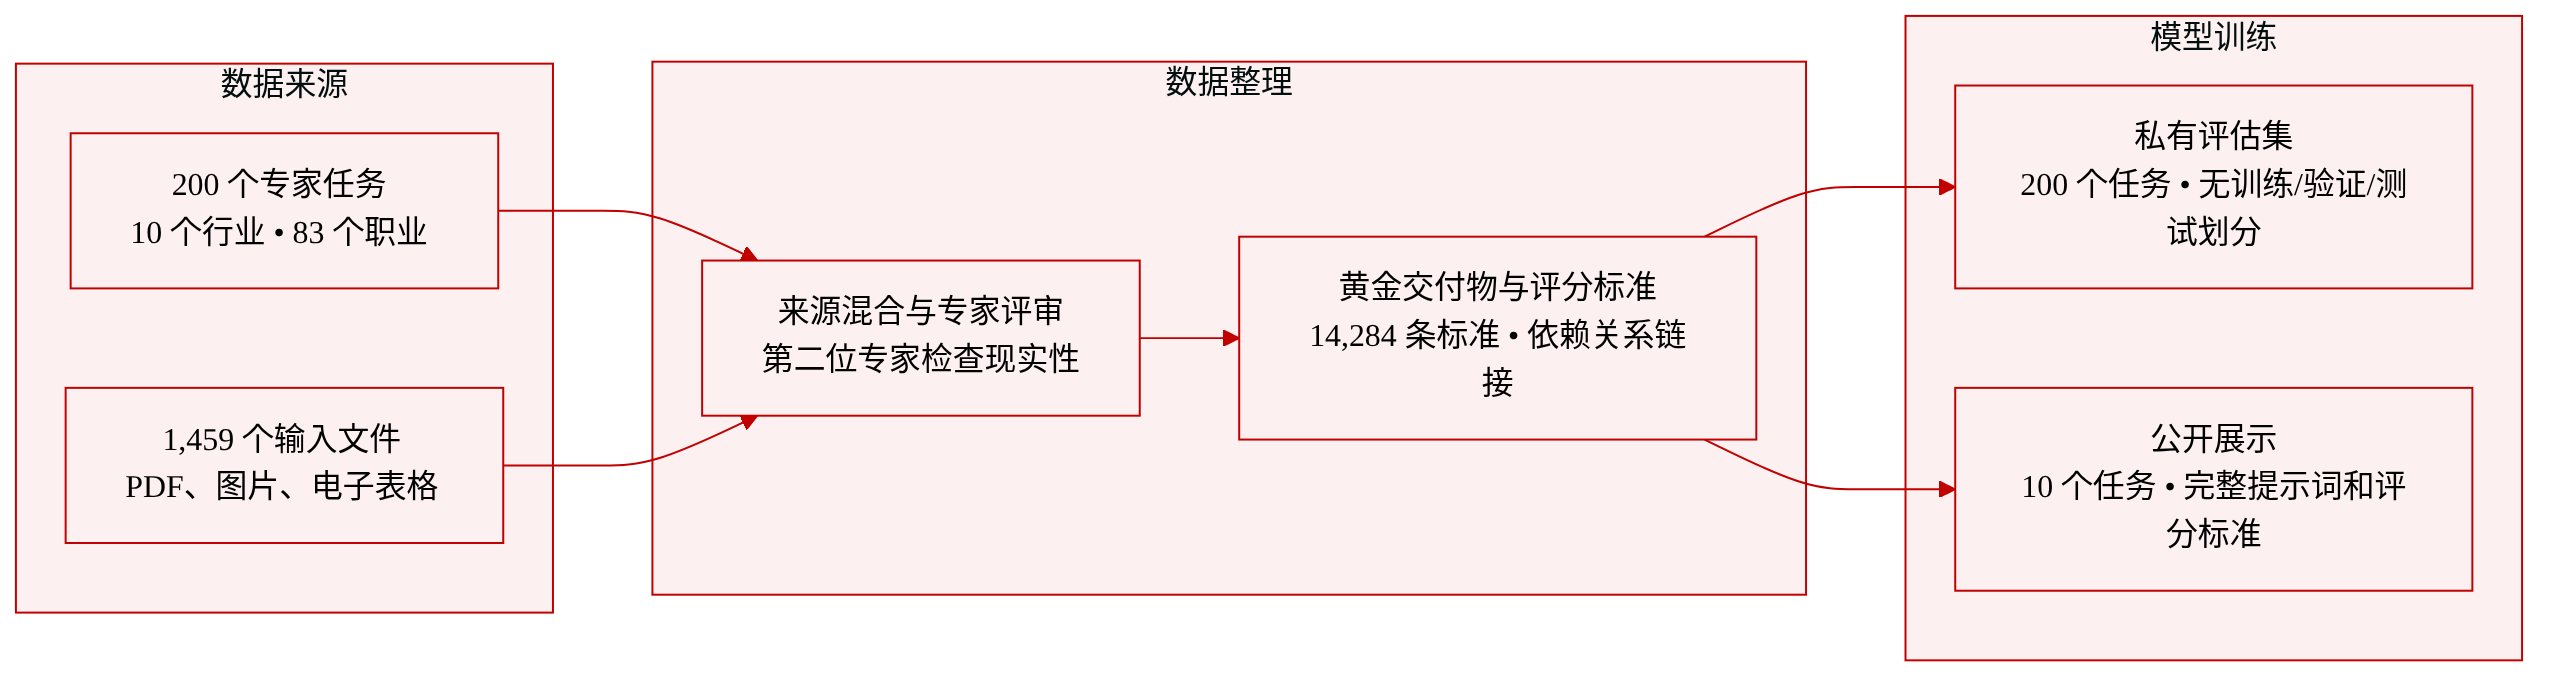
- MKA 包含 200 个真实世界任务,由经过审核的领域专家编写和验证。
- 任务在 10 个行业领域中均匀分布,每个领域 20 个任务,涵盖 83 种职业,如金融分析师、建筑师、工程师、GIS 测量员、数据科学家、律师和医生。
- 每位作者至少具有五年专业经验,每个任务都由第二位专家审核其真实性和准确性。
- 每个任务包含一个 prompt,用于说明用户场景、要求和目标交付物。
公开与私有拆分
- MKA 完整的 200 任务集用作私有评估套件。
- 它由 Artificial Analysis 使用开源 Stirrup 框架托管,并在公开排行榜上独立评分。
- MKA-Showcase 是单独公开发布的数据集,包含 10 个任务,每个领域一个,并提供完整 prompt、输入文件和评分标准。
- 这种拆分有助于防止基准污染,同时仍支持独立评估。
输入文件
- 每个任务包含 2 到 45 个输入文件。
- 数据集总共包含 1,459 个输入文件,平均每个任务 7.30 个,中位数为 6.0 个。
- 输入格式分布:
- PDF 文档:43.0%,628 个文件。
- 图像和扫描件:22.9%,334 个文件。
- 电子表格:10.9%,159 个文件。
- Word 文档:10.2%,149 个文件。
- 地理空间与文本/JSON:6.0%,88 个文件。
- 幻灯片:3.5%,51 个文件。
- CSV 和 TSV:3.4%,50 个文件。
- 示例包括建筑平面图、SEC Form 10-K 文件、CT 扫描、多工作表 Excel 工作簿、GIS 图层、LiDAR 栅格、邮件线程和临床试验表格。
交付物
- 200 个任务中有 176 个(88.0%)需要创建或修改独立文件。
- 其余 24 个任务(12.0%)直接在文本回复中回答。
- 交付物格式分布:
- PDF 报告:45 个任务,22.5%。
- Word 文档:42 个任务,21.0%。
- 演示文稿:34 个任务,17.0%。
- 电子表格:32 个任务,16.0%。
- 文本报告:30 个任务,15.0%。
- 图像和图表:9 个任务,4.5%。
- Web 应用:8 个任务,4.0%。
评分标准元数据与构建细节
- MKA 总共包含 14,284 条评分标准。
- 平均每个任务 71.4 条标准,中位数为 68.5,范围为 20 到 150。
- 91.3% 的标准用于评估 176 个独立文件任务,8.7% 直接评估 24 个文本回复任务。
- 每条标准具有 1 到 5 的整数权重。
- 每条标准被标注为主要目标(94.5%)或次要目标(5.5%)。
- 29.5% 的标准列出了明确的前置标准,在每个任务内形成有向无环图。
- 99.6% 的标准包含专家撰写的金标准理由,引用 ground truth 的来源位置,并在适用时说明其推导。
- 该摘录未描述图像裁剪或增强;主要处理是专家组装多文件输入束、创建金标准交付物和编写评分标准。
数据使用方式
- 作者将 200 任务 MKA 集用作私有评估基准,而不是训练集。
- 本数据集章节未指定训练拆分或混合比例。
- MKA-Showcase 提供了一个较小的公开样本,包含完整 prompt、输入和评分标准,用于外部检查和排行榜使用。
方法
Agentic 执行框架与自动评分器
评估过程使用共享的 agentic 执行环境,使所有模型在相同的操作约束下接受评估。作者在 Stirrup 中评估每个模型;Stirrup 是 Artificial Analysis 维护的轻量级开源 agent 框架。执行框架将任务 prompt 和输入文件路径以文本形式提供给 agent。因此,agent 必须自行检查文件并通过自己的工具调用构建最终交付物。所有模型使用相同的执行框架、系统指令、工具集、容器镜像和资源预算,仅模型端点发生变化。这种外部维护的极简执行框架避免了特定于模型的脚手架,使交付物质量和 token 效率在不同模型系列之间具有可比性。
Agent 循环与执行环境
agent 循环在无人工干预的情况下运行,直到模型调用 finish 工具或达到 250 轮的上限。每个任务有 8 小时的墙钟时间限制,并且当模型支持时最多可使用 1M token 的上下文窗口。当模型达到其上下文长度的 70% 时,会触发压缩。如果模型回复时没有工具调用,执行框架会提示其继续。在最后 20 轮中,执行框架会附加一个包含剩余轮数的警告,以便 agent 能在轮次上限前提交其交付物。
每个任务都在一个全新的隔离 Linux 容器中运行,该容器具有 4 个 vCPU 和 128 MB 基础 RAM,最高可动态扩展至 16 GB。容器基于 Debian 镜像,包含 Python 3.13,工作目录为 /workspace,输入文件存放在 /workspace/input 下。沙箱具有互联网访问权限。镜像包含文档、PDF、OCR 和渲染工具,如 LibreOffice、Tesseract、pymupdf、weasyprint 以及 Python Office 库。这使 agent 无需额外安装软件即可解析输入并构建交付物。
Stirrup 暴露四个工具:code_exec、view_image、web_search 和 finish。code_exec 工具运行 bash 命令和 Python 脚本,每个命令的超时时间为 300 秒;web_search 发起网络查询,超时时间为 180 秒。view_image 工具将栅格图像加载到模型的视觉上下文中,并旨在保留输出文件的原始图像分辨率。为以视觉方式检查文档或幻灯片,agent 首先通过 code_exec 使用 LibreOffice 和 pdftoppm 等命令行工具将页面渲染为 PNG 文件,然后用 view_image 查看所需页面。在轨迹结束时,finish 会检查所有声明的交付物是否存在,并终止会话。
用于交付物评分的 Agentic Autorater
作者使用 agentic 多模态评判器对生成的文件进行评分。静态文本提取会遗漏图表和格式信息,而静态页面渲染会隐藏单元格公式,并可能截断宽表格。由于评分标准同时检查视觉布局和底层文件内部结构,评判器需要直接访问这两种表示。
Agentic Autorater 同样实现为 Stirrup agent。它在独立的全新容器中运行,可以访问 code_exec、view_image 和结构化的 submit_verdicts finish 工具,但没有网络访问权限。其工作区仅包含候选交付物文件和最终文本回复。自动评分器不会收到任务输入文件,因为评分标准是自包含的:每条标准直接说明期望值、容差或属性。在单次会话中,自动评分器根据逐字的任务 prompt 和评分标准检查候选输出,并针对每条标准返回通过/失败判定、理由以及所引用的文件。
对于评判模型,作者使用 OpenAI GPT-6 Luna。选择 Google 模型系列之外的评判器可以避免偏向 Gemini 模型。作者还指出,同系列偏好假设未得到结果支持,因为 GPT-6 Astra 在已评估模型中排名最后。
实验
所有模型都在共享的 Stirrup agent 执行框架中,在多模态知识 agent 任务上接受评估;独立的 agentic 自动评分器与专家人类判断高度一致。前沿模型在较简单的回归标准上已趋于饱和,而更困难的爬升标准仍未得到解决;Claude Fable 5.2 和 Gemini 4 Carbon 在质量上领先,Gemini 4 Carbon 则实现显著更低的 token 使用量和成本。移除视觉工具访问对 GDPval 影响很小,但会大幅降低 MKA 性能,表明基于代码的 OCR 和图像变通方法可以部分补偿,但无法替代复杂视觉输入所需的真正视觉感知。
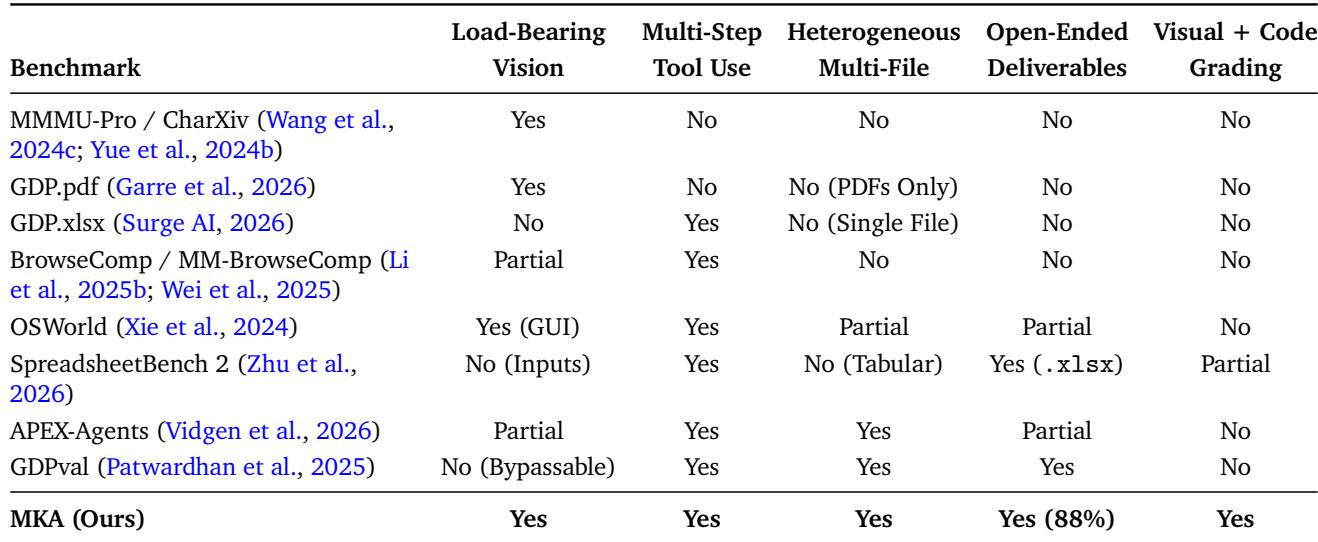
MKA 旨在将关键视觉感知、多步工具使用、异构多文件输入、开放式交付物以及视觉加代码评分结合在单个基准中,这种组合在所比较的基准中并不存在。现有套件只覆盖该组合的一部分:多模态问答基准需要视觉,但仍是单轮和封闭式的;而电子表格、浏览、GUI 和工作场所基准则缺乏或仅部分满足视觉、多文件和开放式交付物要求。消融实验显示,移除图像查看对 GDPval 的质量或计算几乎无影响,但会降低 MKA 成功率并增加轨迹长度,表明视觉对该基准至关重要。MKA 被提出为唯一同时要求关键视觉、多步工具使用、异构多文件输入、开放式交付物以及视觉加代码评分的设置。MMMU-Pro 和 CharXiv 等多模态问答套件需要视觉感知,但不包含工具使用、多个异构文件或开放式交付物。电子表格和浏览基准支持多步工具使用,但视觉或开放式交付物并非关键要求。APEX-Agents 和 OSWorld 等工作场所和 GUI 基准仅部分满足视觉、异构文件和开放式交付物的组合要求。移除图像查看后,GDPval 几乎不变,而在 MKA 中则降低成功率并增加轮次和输出 token,因为 agent 会退回到代码变通方法。
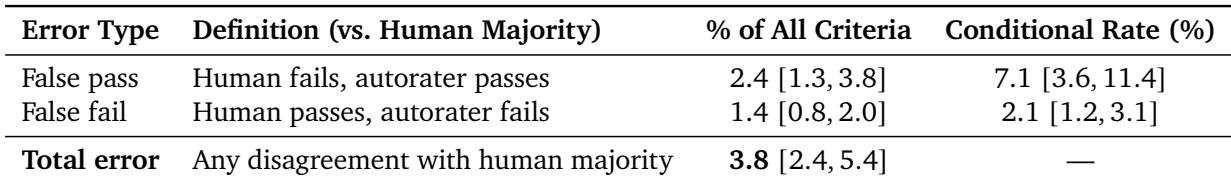
自动评分器在少量标准上与人类多数判断不一致,总体错误率为 3.8%。不一致主要由假通过而非假失败主导,无论是在绝对数量上还是在考虑基础比率后都是如此。这表明自动评分器更可能忽略人类标记的失败,而不是拒绝人类已接受的工作。假通过是更大的错误类型,占所有标准的 2.4%,而假失败占 1.4%。在人类判定失败的标准上,条件假通过率为 7.1%;而在人类判定通过的标准上,条件假失败率为 2.1%,表明评分器更倾向于宽松。
在 MKA 上,所有四个模型在回归质量上均已饱和,使爬升质量成为主要区分因素。Claude Fable 5.2 和 Gemini 4 Carbon 在爬升和整体交付物质量上领先。在成对 bootstrap 下,前三个模型在爬升质量上统计不可区分,而前两个模型显著优于 GPT-6 Astra。所有模型的回归性能都接近上限,因此质量差异集中在爬升上。Claude Fable 5.2 和 Gemini 4 Carbon 取得最高的爬升和整体质量,GPT-6 Astra 落后。成对 bootstrap 比较显示,前三个模型在爬升质量上没有明显差异,但前两个模型优于 GPT-6 Astra。
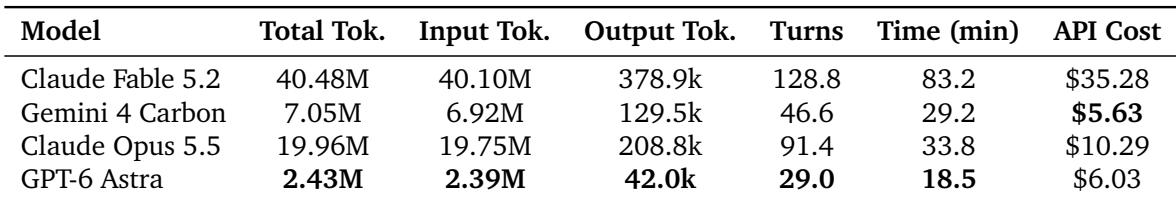
在 MKA 基准上,这些前沿模型的效率差异很大。Gemini 4 Carbon 是每个任务成本效率最高的模型,并且在得分最高的模型中提供了最佳的每 token 质量。几个成本更高的模型消耗了显著更多的 token、轮次和运行时间,却没有提高 Climb-WSR;即使是最节省 token 的模型,也由于每 token 定价更高而比 Gemini 4 Carbon 略贵。Gemini 4 Carbon 实现每个任务最低的 API 成本,同时在得分最高的模型中提供最佳的每 token 质量。Claude Fable 5.2 使用的总 token、输出 token、轮次和墙钟时间显著多于 Gemini 4 Carbon,但其 Climb-WSR 差异在统计上不显著。GPT-6 Astra 的 token 和轮次最少,运行时间最快,但由于其每 token 标价更高,其每个任务成本略高于 Gemini 4 Carbon,尽管 Climb-WSR 更低。
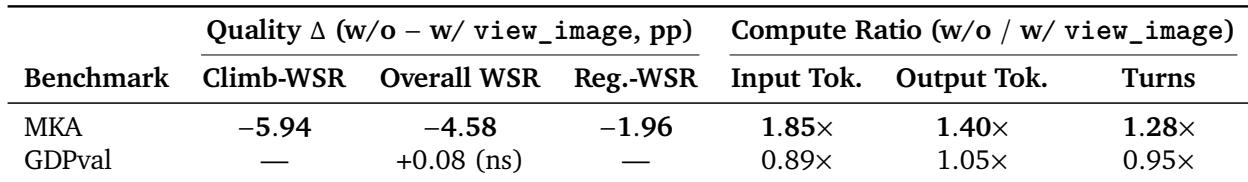
移除 view_image 工具对 GDPval 的质量或计算影响很小,这与其依赖机器可读的电子表格和文本输入一致。在 MKA 上,同一消融降低了成功率,尤其是在以爬升为重点的任务上,同时大幅增加输入 token、输出 token 和轮次。agent 通过基于代码的变通方法进行补偿,如 ASCII 渲染和 OpenCV 流水线,但这些方法只能部分恢复视觉理解,且成本更高。在 GDPval 上,移除 view_image 后,分析质量和计算基本不变。在 MKA 上,移除 view_image 导致爬升相关成功率比回归成功率下降更多,并显著增加轨迹长度和 token 使用量。没有 view_image 时,模型退回到基于代码的视觉变通方法,如 ASCII art、Braille 渲染和 OpenCV 流水线,但仍会遗漏细微的感知细节。
这组实验通过与现有基准对比,以及通过消融实验和模型比较,评估了 MKA;该基准独特地结合了关键视觉感知、多步工具使用、异构多文件输入、开放式交付物以及视觉加代码评分。自动评分器验证显示,与人类判断的总体不一致率较低,但存在倾向于假通过的宽松偏差。在 MKA 上,前沿模型在回归质量上饱和,因此爬升质量驱动差异;Claude Fable 5.2 和 Gemini 4 Carbon 整体领先,而前三个模型在爬升质量上统计相似。效率结果突出显示,Gemini 4 Carbon 是每个任务成本效率最高的模型;移除 view_image 工具后,GDPval 几乎不变,但 MKA 成功率下降,尤其是在爬升方面,因为 agent 退回到成本较高的基于代码的视觉变通方法。