HyperAIHyperAI

Command Palette

Search for a command to run...

视频生成的运动归因

Xindi Wu Despoina Paschalidou Jun Gao Antonio Torralba Laura Leal-Taixé Olga Russakovsky Sanja Fidler Jonathan Lorraine

摘要

尽管视频生成模型取得了快速进展,数据对运动的影响仍知之甚少。我们提出了 MOTIVE(MOTIon attribution for Video gEneration,视频生成的运动归因),这是一个以运动为中心的、基于梯度的数据归因框架,能够扩展至现代大规模高质量视频数据集和模型。我们利用该框架研究哪些微调片段能够改善或恶化时序动态。MOTIVE 通过运动加权损失掩码将时序动态与静态外观分离,从而实现高效且可扩展的运动特定影响力计算。在文本到视频模型上,MOTIVE 能够识别对运动有显著影响的片段,并指导数据筛选以改善时序一致性和物理合理性。使用 MOTIVE 筛选出的高影响力数据,我们在 VBench 上同时提升了运动流畅度和动态程度,与预训练基础模型相比达到了 74.1% 的人类偏好胜率。据我们所知,这是首个针对视频生成模型中的运动(而非视觉外观)进行归因并利用其筛选微调数据的框架。

一句话总结

NVIDIA、MIT 和 UIUC 提出了 MOTIVE,这是首个面向视频生成的、以运动为中心的、基于梯度的数据归因框架。它通过运动加权损失掩码将时间动态与静态外观分离,从而实现可扩展的影响计算,并构建微调数据,以提升时间一致性和物理合理性。

核心贡献

  • 该工作提出了 MOTIVE,这是一个面向视频生成模型的、以运动为中心的、基于梯度的数据归因框架。在大规模现代视频规模下,它将微调片段归因于时间动态,而非静态视觉外观。

  • MOTIVE 使用运动加权损失掩码将时间动态与静态外观分离,从而实现高效的运动特定影响计算,并识别对运动平滑度、时间一致性和物理合理性有强烈影响的片段。

  • 在文生视频模型上的实验表明,MOTIVE 引导的数据筛选在 VBench 上提升了运动平滑度和动态程度,相对于预训练基础模型达到了 74.1% 的人类偏好胜率。

引言

使用扩散模型或流匹配模型进行视频生成超出了图像合成的范畴,因为模型必须学习时间动态,例如物体运动、相机移动、形变和物理交互。随着这些模型随数据规模扩展,理解哪些训练片段能够教会模型良好运动,对于诊断伪影和选择微调数据非常重要,尤其是在无法获得大规模预训练语料库时。

现有数据归因方法主要解释静态视觉内容。若直接应用于视频,它们会将外观与运动混为一谈。这些方法可能无法定位动态区域,在跨帧整合梯度时代价高昂,并会受到片段长度或扩散时间步效应等偏差影响。

作者利用基于梯度的归因构建 MOTIVE。这是一个运动感知框架,会通过掩码聚焦动态区域、修正帧长效应,并将生成运动追溯到有影响力的训练片段。该框架还使用高效近似扩展到大规模模型和数据集,并且能够用少量训练数据提升运动平滑度和动态程度。

方法

作者为微调场景下的视频扩散模型设计了一个归因框架。输入是一个微调语料库 Dft={(vn,cn)}n=1N\mathcal{D}_{\mathrm{ft}} = \{(\mathbf{v}_n, \mathbf{c}_n)\}_{n=1}^{N}Dft​={(vn​,cn​)}n=1N​ 和一个查询视频字幕对 (v^,c^)(\hat{\mathbf{v}}, \hat{\mathbf{c}})(v^,c^)。目标是为每个训练片段 (vn,cn)(\mathbf{v}_n, \mathbf{c}_n)(vn​,cn​) 分配一个运动感知影响分数,以解释该片段如何影响在生成的查询视频中观察到的时间动态。设计遵循两个实际约束:该分数应能预测哪些数据子集在微调期间真正改善目标运动,并且应能扩展到大规模视频模型和大型语料库,而无需计算逆 Hessian、逐样本轨迹积分或完整梯度存储。

该流程将归因转化为一个紧凑的梯度几何问题。作者不估计经典影响函数中的精确曲率,而是使用恒等预条件子近似逆 Hessian,并通过训练梯度与测试梯度之间的对齐程度估计影响。扩散损失梯度在配对随机变量下计算,因此训练片段和查询片段使用相同的时间步和噪声向量。这种共享随机性降低方差,并使候选样本的排序更稳定。

对于一组采样的噪声时间步对 T\mathcal{T}T,配对的多样本估计器可以写为

Idiff1(xn,xtest)=1∣T∣∑t,ϵ∈T∇θLdiff(θ;xtest,t,ϵ)⊤∥∇θLdiff(θ;xtest,t,ϵ)∥∇θLdiff(θ;xn,t,ϵ)∥∇θLdiff(θ;xn,t,ϵ)∥.I_{\mathrm{diff}}^{1}(\mathbf{x}_n,\mathbf{x}_{\mathrm{test}}) = \frac{1}{|\mathcal{T}|} \sum_{t,\boldsymbol{\epsilon}\in\mathcal{T}} \frac{ \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_{\mathrm{test}},t,\boldsymbol{\epsilon})^{\top} }{ \left\| \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_{\mathrm{test}},t,\boldsymbol{\epsilon}) \right\| } \frac{ \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_n,t,\boldsymbol{\epsilon}) }{ \left\| \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_n,t,\boldsymbol{\epsilon}) \right\| }.Idiff1​(xn​,xtest​)=∣T∣1​t,ϵ∈T∑​∥∇θ​Ldiff​(θ;xtest​,t,ϵ)∥∇θ​Ldiff​(θ;xtest​,t,ϵ)⊤​∥∇θ​Ldiff​(θ;xn​,t,ϵ)∥∇θ​Ldiff​(θ;xn​,t,ϵ)​.

为了进一步降低成本,该框架将所有查询训练比较中的共享时间步 tfixt_{\mathrm{fix}}tfix​ 和共享噪声采样 ϵfix∼N(0,I)\boldsymbol{\epsilon}_{\mathrm{fix}} \sim \mathcal{N}(\mathbf{0}, \mathbf{I})ϵfix​∼N(0,I) 固定为一个值,从而把上式归约为单样本估计器。由此得到的类似余弦的分数是

Idiff2(xn,xtest)=∇θLdiff(θ;xtest,tfix,ϵfix)∥∇θLdiff(θ;xtest,tfix,ϵfix)∥⊤∇θLdiff(θ;xn,tfix,ϵfix)∥∇θLdiff(θ;xn,tfix,ϵfix)∥.I_{\mathrm{diff}}^{2}(\mathbf{x}_n,\mathbf{x}_{\mathrm{test}}) = \frac{ \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_{\mathrm{test}},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) }{ \left\| \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_{\mathrm{test}},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \right\| }^{\top} \frac{ \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_n,t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) }{ \left\| \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{x}_n,t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \right\| }.Idiff2​(xn​,xtest​)=∥∇θ​Ldiff​(θ;xtest​,tfix​,ϵfix​)∥∇θ​Ldiff​(θ;xtest​,tfix​,ϵfix​)​⊤∥∇θ​Ldiff​(θ;xn​,tfix​,ϵfix​)∥∇θ​Ldiff​(θ;xn​,tfix​,ϵfix​)​.

由于原始梯度对于数十亿参数的视频模型而言难以存储,该方法加入了一个结构化随机投影步骤。Johnson-Lindenstrauss 风格的 Fastfood 投影将高维梯度映射到更小的空间中,同时保留相对余弦几何。投影矩阵由一系列随机化变换构成,

P=1ξD′SQGΠQB,\mathbf{P} = \frac{1}{\xi\sqrt{D'}} \mathrm{SQG}\Pi\mathrm{QB},P=ξD′​1​SQGΠQB,

其中 Q\mathbf{Q}Q 是 Walsh-Hadamard 矩阵,B\mathbf{B}B 是对角 Rademacher 矩阵,Π\PiΠ 是随机排列,G\mathbf{G}G 是对角高斯缩放矩阵,S\mathbf{S}S 是对角重新缩放矩阵,ξ\xiξ 用于稳定方差。每个梯度先投影,再进行归一化,

g~(θ,x)=P∇θLdiff(θ,x,tfix,ϵfix)∥P∇θLdiff(θ,x,tfix,ϵfix)∥.\tilde{\mathbf{g}}(\boldsymbol{\theta},\mathbf{x}) = \frac{ \mathbf{P} \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta},\mathbf{x},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) }{ \left\| \mathbf{P} \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta},\mathbf{x},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \right\| }.g~​(θ,x)=∥P∇θ​Ldiff​(θ,x,tfix​,ϵfix​)∥P∇θ​Ldiff​(θ,x,tfix​,ϵfix​)​.

最终的视频级分数是投影空间中的余弦相似度,

Idiff3(xn,xtest)=g~(θ,xtest)⊤g~(θ,xn).I_{\mathrm{diff}}^{3}(\mathbf{x}_n,\mathbf{x}_{\mathrm{test}}) = \tilde{\mathbf{g}}(\boldsymbol{\theta},\mathbf{x}_{\mathrm{test}})^{\top} \tilde{\mathbf{g}}(\boldsymbol{\theta},\mathbf{x}_n).Idiff3​(xn​,xtest​)=g~​(θ,xtest​)⊤g~​(θ,xn​).

这样可以在仅保存每个样本低维向量的同时,近似梯度相似度。

作者还修正了一个视频特有尺度问题。原始扩散梯度会随视频帧数 FFF 增长,这会使排序偏向更长的片段。为了移除这种依赖长度的膨胀,在投影和归一化之前,将梯度除以帧数:

∇θLdiff(θ;v,tfix,ϵfix)←1F∇θLdiff(θ;v,tfix,ϵfix).\nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{v},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \leftarrow \frac{1}{F} \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{diff}}(\boldsymbol{\theta};\mathbf{v},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}).∇θ​Ldiff​(θ;v,tfix​,ϵfix​)←F1​∇θ​Ldiff​(θ;v,tfix​,ϵfix​).

框架之后仍会应用 L2L_2L2​ 归一化,以稳定跨片段比较。

仅有视频级梯度相似度不足以理解运动,因为它可能奖励共享外观、背景或物体,而非时间动态。因此,方法的核心模块是运动归因。该模块在视频扩散模型使用的潜空间中运行。给定一个视频

v∈RF×H×W×3,\mathbf{v}\in\mathbb{R}^{F\times H\times W\times 3},v∈RF×H×W×3,

编码器将其映射到潜特征

h=E(v)∈RF×H/s×W/s×C,\mathbf{h} = E(\mathbf{v}) \in \mathbb{R}^{F\times H/s\times W/s\times C},h=E(v)∈RF×H/s×W/s×C,

其中空间下采样因子为 sss,潜空间通道维度为 CCC。在所述实现中,潜空间几何与视频 VAE 骨干网络匹配,其中 s=8s=8s=8 且 C=16C=16C=16。

运动信息使用密集运动跟踪器或光流提取器在像素空间中计算。跟踪器产生

A=A(v)∈RF×H×W×4,\mathbf{A} = \mathcal{A}(\mathbf{v}) \in \mathbb{R}^{F\times H\times W\times 4},A=A(v)∈RF×H×W×4,

其中前两个通道编码帧间像素水平位移和垂直位移,其余通道编码可见性或置信度信息。在帧 fff 和像素位置 (h,w)(h,w)(h,w) 处的位移向量为

Df(h,w)=(Af,h,w,0,Af,h,w,1).\mathbf{D}_f(h,w) = (A_{f,h,w,0}, A_{f,h,w,1}).Df​(h,w)=(Af,h,w,0​,Af,h,w,1​).

原始运动幅值是欧几里得范数

Mf(h,w)=∥Df(h,w)∥2.M_f(h,w) = \|\mathbf{D}_f(h,w)\|_2.Mf​(h,w)=∥Df​(h,w)∥2​.

为了避免具有异常大绝对运动幅值的视频占主导地位,这些值在所有帧和所有像素位置上进行 min-max 归一化:

W(f,h,w)=Mf(h,w)−mmin⁡mmax⁡−mmin⁡+ζ,\mathbf{W}(f,h,w) = \frac{M_f(h,w)-m_{\min}}{m_{\max}-m_{\min}+\zeta},W(f,h,w)=mmax​−mmin​+ζMf​(h,w)−mmin​​,

其中

mmin⁡=min⁡f′,h′,w′Mf′(h′,w′),mmax⁡=max⁡f′,h′,w′Mf′(h′,w′),m_{\min} = \min_{f',h',w'} M_{f'}(h',w'), \qquad m_{\max} = \max_{f',h',w'} M_{f'}(h',w'),mmin​=f′,h′,w′min​Mf′​(h′,w′),mmax​=f′,h′,w′max​Mf′​(h′,w′),

并且 ζ=10−6\zeta = 10^{-6}ζ=10−6 防止除以零。这种归一化强调相对运动显著性,而非原始位移尺度。

然后将运动权重从像素分辨率双线性下采样到潜空间网格:

W~(f,h~,w~)=Bilinear(W(⋅,⋅,⋅),F,Hs,Ws).\tilde{\mathbf{W}}(f,\tilde{h},\tilde{w}) = \mathrm{Bilinear} \left( \mathbf{W}(\cdot,\cdot,\cdot), F, \frac{H}{s}, \frac{W}{s} \right).W~(f,h~,w~)=Bilinear(W(⋅,⋅,⋅),F,sH​,sW​).

使用固定的 tfixt_{\mathrm{fix}}tfix​ 和 ϵfix\boldsymbol{\epsilon}_{\mathrm{fix}}ϵfix​,该方法在每个潜帧和每个潜空间位置计算预测噪声与目标噪声之间的逐位置平方误差:

L~θ,v,c(f,h~,w~)=([ϵθ(z(v,tfix,ϵfix),tfix,c)]f,h~,w~−[ϵtarget(tfix,ϵfix)]f,h~,w~)2.\tilde{\mathcal{L}}_{\boldsymbol{\theta},\mathbf{v},\mathbf{c}}(f,\tilde{h},\tilde{w}) = \left( \left[ \boldsymbol{\epsilon}_{\boldsymbol{\theta}} \left( \mathbf{z}(\mathbf{v},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}), t_{\mathrm{fix}}, \mathbf{c} \right) \right]_{f,\tilde{h},\tilde{w}} - \left[ \boldsymbol{\epsilon}_{\mathrm{target}}(t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \right]_{f,\tilde{h},\tilde{w}} \right)^2.L~θ,v,c​(f,h~,w~)=([ϵθ​(z(v,tfix​,ϵfix​),tfix​,c)]f,h~,w~​−[ϵtarget​(tfix​,ϵfix​)]f,h~,w~​)2.

运动加权归因损失是这些误差在潜空间对齐运动掩码下的加权平均:

Lmot(θ;v,c)=1Fvmean⁡f,h~,w~[W~v,c(f,h~,w~)⋅L~θ,v,c(f,h~,w~)].\mathcal{L}_{\mathrm{mot}}(\boldsymbol{\theta};\mathbf{v},\mathbf{c}) = \frac{1}{F_{\mathbf{v}}} \operatorname*{mean}_{f,\tilde{h},\tilde{w}} \left[ \tilde{\mathbf{W}}_{\mathbf{v},\mathbf{c}}(f,\tilde{h},\tilde{w}) \cdot \tilde{\mathcal{L}}_{\boldsymbol{\theta},\mathbf{v},\mathbf{c}}(f,\tilde{h},\tilde{w}) \right].Lmot​(θ;v,c)=Fv​1​f,h~,w~mean​[W~v,c​(f,h~,w~)⋅L~θ,v,c​(f,h~,w~)].

因子 1/Fv1/F_{\mathbf{v}}1/Fv​ 再次移除帧长偏差。当运动权重都等于 1 时,目标退化为不包含运动强调的标准平均扩散损失。

运动感知梯度为

gmot(θ,v)=∇θLmot(θ;v),\mathbf{g}_{\mathrm{mot}}(\boldsymbol{\theta},\mathbf{v}) = \nabla_{\boldsymbol{\theta}} \mathcal{L}_{\mathrm{mot}}(\boldsymbol{\theta};\mathbf{v}),gmot​(θ,v)=∇θ​Lmot​(θ;v),

投影并归一化后的运动梯度为

g~mot(θ,v)=Pgmot(θ,v,tfix,ϵfix)∥Pgmot(θ,v,tfix,ϵfix)∥.\tilde{\mathbf{g}}_{\mathrm{mot}}(\boldsymbol{\theta},\mathbf{v}) = \frac{ \mathbf{P} \mathbf{g}_{\mathrm{mot}}(\boldsymbol{\theta},\mathbf{v},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) }{ \left\| \mathbf{P} \mathbf{g}_{\mathrm{mot}}(\boldsymbol{\theta},\mathbf{v},t_{\mathrm{fix}},\boldsymbol{\epsilon}_{\mathrm{fix}}) \right\| }.g~​mot​(θ,v)=∥Pgmot​(θ,v,tfix​,ϵfix​)∥Pgmot​(θ,v,tfix​,ϵfix​)​.

最终运动归因分数为

Imot(vn,v^)=g~mot(θ,v^)⊤g~mot(θ,vn).I_{\mathrm{mot}}(\mathbf{v}_n,\hat{\mathbf{v}}) = \tilde{\mathbf{g}}_{\mathrm{mot}}(\boldsymbol{\theta},\hat{\mathbf{v}})^{\top} \tilde{\mathbf{g}}_{\mathrm{mot}}(\boldsymbol{\theta},\mathbf{v}_n).Imot​(vn​,v^)=g~​mot​(θ,v^)⊤g~​mot​(θ,vn​).

在实践中,候选片段 (vn,cn)(\mathbf{v}_n,\mathbf{c}_n)(vn​,cn​) 和查询片段 (v^,c^)(\hat{\mathbf{v}},\hat{\mathbf{c}})(v^,c^) 为扩散模型提供条件信息,而运动掩码决定哪些潜误差位置主导归因梯度。由于掩码应用于归因损失,而非前向加噪或生成过程,扩散模型本身不被改变。运动加权梯度转而使归因目标偏向动态区域,并远离静态背景。

归因分数随后用于构建微调子集。对于单个查询片段和预算 KKK,框架按运动感知分数选择前 KKK 个候选样本。在实际数据选择中,KKK 可以指定为候选语料库的百分位,例如前百分之一到百分之十,以使被选子集在不同数据集规模上一致扩展。

对于多个查询运动,框架使用多数投票机制跨查询聚合分数。对于 QQQ 个查询片段,如果某个训练片段相对于某个查询的运动感知分数超过该查询的百分位截断 τ\tauτ,则该查询为该训练片段贡献一个二元投票。共识投票计数为

MajVoten=∑q=1QI[Imot(vn,v^q)>τ].\mathrm{MajVote}_n = \sum_{q=1}^{Q} \mathbb{I} \left[ I_{\mathrm{mot}}(\mathbf{v}_n,\hat{\mathbf{v}}_q) > \tau \right].MajVoten​=q=1∑Q​I[Imot​(vn​,v^q​)>τ].

最终微调子集包含 MajVoten\mathrm{MajVote}_nMajVoten​ 最大的前 KKK 个样本。这避免跨不同查询运动校准原始影响分数的需要,同时仍优先选择被反复识别为具有运动影响力的片段。

计算设计使工作流在大视频语料库上保持可行。在大量时间步和噪声样本上平均的朴素归因所需成本与数据集大小乘以样本数成正比。单固定噪声时间步变体将每个样本的梯度计算减少为一次前向后向传播。投影为每个梯度增加结构化 O(D′log⁡D′)\mathcal{O}(D'\log D')O(D′logD′) 成本,相对于扩散模型反向传播很小。系统不存储维度为 DDD 的完整梯度,而是存储维度为 D′D'D′ 的投影向量,加上紧凑的随机投影状态。候选排序随后简化为在 RD′\mathbb{R}^{D'}RD′ 中做内积和排序。运动掩码提取会增加帧分辨率开销,但掩码可以每个片段计算一次并缓存,使其成本相对于梯度计算可忽略。

实验

实验使用大规模数据集、多样运动类别查询、预训练扩散视频模型、自动 VBench 指标、人类偏好研究和消融实验,评估面向视频生成微调的运动归因。结果表明,所提出的归因方法能够选择具有物理意义的运动样本,并在保留视觉质量的同时,相较于随机选择、基于幅度、基于嵌入和整视频基线,提升生成运动的保真度与时间动态。消融实验进一步确认,紧凑的归因设置,包括固定去噪时间步、投影梯度和帧长归一化,能够保持排序质量并降低偏向视频长度的偏差。

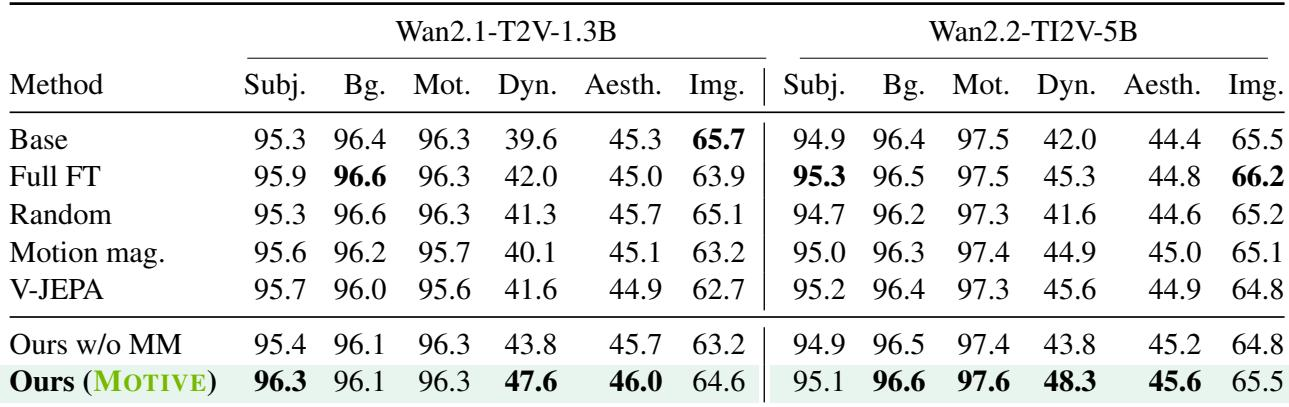
MOTIVE 使用运动感知归因选择训练数据,并在两种视频模型上展现出最强的 VBench 运动质量。它取得最高动态程度分数,同时保持良好的审美质量和有竞争力的运动平滑度。这些提升来自仅选择少量训练数据,并在动态程度上超过全量微调,体现了运动特定数据选择的价值。MOTIVE 在两种评估模型中均达到最高动态程度。它在面向运动表现上优于随机选择和整视频归因。小数据预算下的运动引导选择在动态程度上超过全量微调。
人类评估者通常更偏好归因引导的视频选择,优于受测基线。相对基础模型的偏好最强,并且相对于随机选择和全量微调选择仍保持正向,尽管优势较小。移除运动掩码削弱了优势,导致明显胜出更少且平局更多。人类偏好最强出现在与基础模型对比时。相对于全量微调选择,感知优势持续存在。省略运动掩码会增加平局并减少明显胜出。
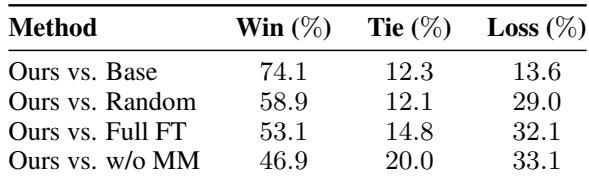
实验通过自动 VBench 和人类偏好测试在多个视频模型上评估 MOTIVE。结果表明,运动感知归因数据选择在保留审美和平滑度结果的同时,取得了最强的动态运动质量,并且小的选择预算可以超过全量微调。人类评估进一步确认了相较于基线的感知优势,尤其是相对于基础模型,而移除运动掩码会降低收益。