Command Palette
Search for a command to run...
灵活性陷阱:重新审视扩散语言模型中任意顺序的价值
灵活性陷阱:重新审视扩散语言模型中任意顺序的价值
摘要
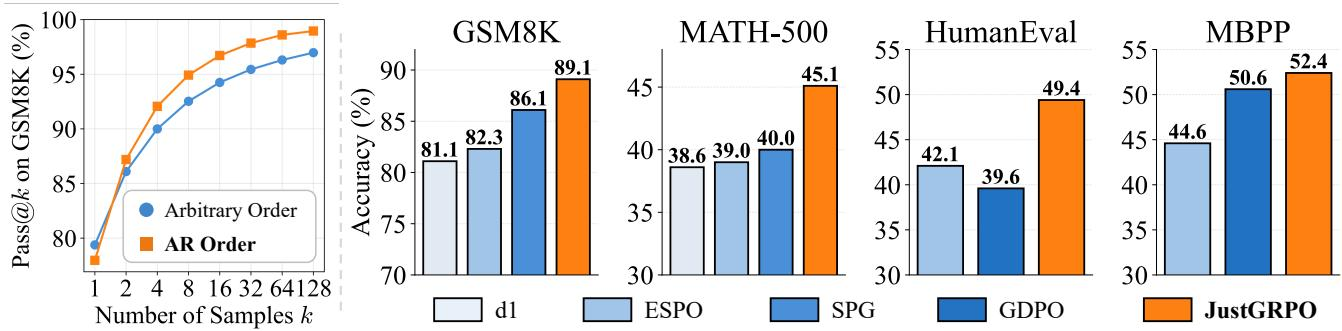
扩散大语言模型(dLLMs)打破了传统大语言模型严格的从左到右约束,使得令牌能够以任意顺序生成。直观上,这种灵活性意味着一个严格超集固定自回归轨迹的解空间,理论上解锁了更优越的推理潜力。然而,在本文中,我们发现对于一般的推理任务(如数学和编码),任意顺序生成实际上可能限制 dLLMs 的推理潜力。我们观察到 dLLMs 倾向于利用这种顺序灵活性来绕过对探索至关重要的高不确定性令牌,这可能导致解覆盖范围的过早坍缩。这一观察促使我们重新思考针对 dLLMs 的强化学习方法,在这些方法中,大量的复杂性(例如处理组合轨迹和难以处理的可能性)通常被用来保留这种灵活性。我们表明,仅仅放弃任意顺序并应用标准的群体相对策略优化(GRPO)就可以有效地激发推理能力。我们的方法 JustGRPO 极简却出人意料地有效(例如,在 GSM8K 上达到 89.1% 的准确率),同时完全保留了 dLLMs 的并行解码能力。
一句话总结
清华大学和阿里巴巴集团的研究人员表明,扩散大语言模型(dLLMs)中的任意顺序生成会阻碍推理,因为这种灵活性使模型能够绕过对探索至关重要的高不确定性 token,并提出 JustGRPO,该方法放弃这种灵活性以应用标准组相对策略优化,在 GSM8K 上达到 89.1% 的准确率,同时保留并行解码能力。
核心贡献
- 识别了扩散大语言模型在一般推理中任意顺序生成的一种限制性行为:这种灵活性导致模型绕过对探索至关重要的高不确定性 token,从而过早导致解空间覆盖率崩溃。
- 提出 JustGRPO,一种极简的对齐方法,放弃任意顺序生成,直接应用标准组相对策略优化(GRPO),有意限制探索顺序以改善推理,同时在推理时保留扩散大语言模型的并行解码能力。
- 在 GSM8K 上达到 89.1% 的准确率,证明无需针对顺序任意性进行复杂的强化学习适配即可激发有效推理,并完全保留推理时的并行解码能力。
引言
扩散大语言模型(dLLMs)通过将文本生成建模为离散去噪过程,正在成为自回归(AR)模型的替代方案。它们相对于固定的从左到右解码具有两个理论优势:高效的并行解码和任意顺序生成 token 的能力。虽然解码速度优势已有充分记录,但任意顺序生成对于数学和编程等复杂任务的价值仍是一个开放问题。先前的工作大多假设这种灵活性至关重要,因此针对 dLLMs 的强化学习(RL)方法变得复杂,需要应对去噪轨迹的组合爆炸、难以处理的边际似然以及依赖不准确的近似。最近的一些方法引入辅助策略或逐步马尔可夫决策过程来处理任意顺序,但所有这些方法都保留了该机制,而没有质疑它是否真正有用。
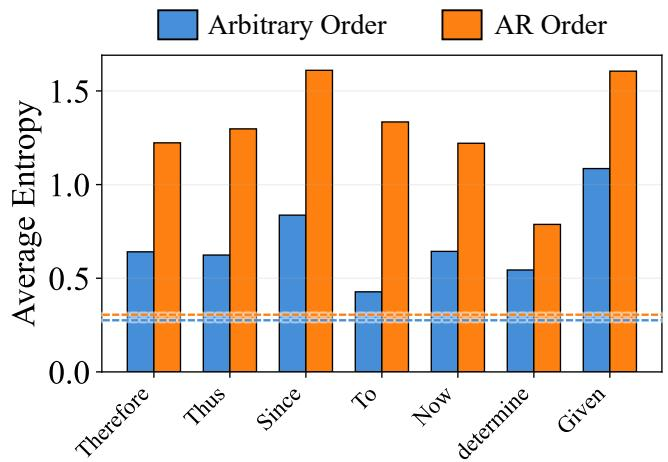
作者用一个反直觉的发现挑战了这一假设:对于一般推理任务,任意顺序生成实际上可能缩小而非扩大 RL 可探索的推理潜力。使用 Pass@k 作为 RL 可开发利用解空间上界的代理指标,他们证明将 dLLM 限制为标准 AR 顺序产生更高的 Pass@k 和更高的推理边界,优于其灵活版本。其背后的机制是“熵退化”:推理依赖于诸如“Therefore”或“Since”这样的稀疏分叉 token,这些 token 引导逻辑轨迹。AR 解码迫使模型面对这些分叉处的高不确定性,从而保持探索的多样性。相反,任意顺序生成倾向于先填充低不确定性 token,将推理路径锚定,并在分叉 token 被填充之前过早地解决其模糊性。
基于这一洞见,作者提出 JustGRPO,回归简单。他们证明,激发推理能力不需要扩散特定的 RL 适配;相反,在 RL 训练期间可以将 dLLM 视为 AR 策略,从而无需修改即可应用标准 GRPO。这种 AR 公式仅作为更好探索的训练脚手架;模型的原始架构,包括双向注意力和离散扩散公式,保持不变。因此,推理激发(受益于顺序探索)和推理执行(受益于并行解码)被解耦。JustGRPO 取得了优秀的结果,包括 GSM8K 上 89.1% 和 MATH-500 上 45.1% 的准确率,与依赖复杂扩散特定 RL 适配的方法相当,同时在推理时保持 dLLM 的并行解码效率。
方法
作者在扩散语言模型(dLLMs)中识别出一个“灵活性陷阱”,即任意顺序生成的理论灵活性无意中限制了推理潜力。这种限制源于一种称为“熵退化”的现象,其中自适应解码过程优先绕过关键的逻辑连接符,导致这些分支点的熵急剧下降。如熵分析所示,虽然整体平均 token 熵在两种解码模式之间相当,但在任意顺序下,逻辑分叉处的熵显著下降,有效地将轨迹锚定到生成过程早期的预定结论。
为了解决这个问题,作者提出 JustGRPO,一种在强化学习阶段明确放弃任意顺序生成的方法。通过将过程限制为严格的自回归顺序,该方法将 dLLM 从混沌序列去噪器转变为定义良好的自回归策略。这一设计选择解决了 token 级信用分配中的歧义以及扩散模型中固有的难以处理的序列似然问题。
JustGRPO 的核心是构建一个替代自回归策略,表示为 πθAR。对于给定查询 q 和历史 O<k,该方法构建序列 x~k,其中过去的 token 被观察到,未来的 token 被掩蔽。下一个 token ok 的概率定义为模型在第 k 个位置的 logits 的 softmax。这一公式允许将难以处理的置换边际化转化为精确可计算的可能性,表示为条件概率的乘积。
在建立该替代策略后,作者应用标准组相对策略优化(GRPO)。对于每个查询,从旧策略采样一组输出。优势 A^i,k 通过将奖励相对于组均值和标准差标准化来计算。优化目标最大化一个带有 KL 正则化项的裁剪替代函数,在利用组级奖励归一化的同时确保稳定更新。
尽管有效,但将精确 GRPO 应用于 dLLM 会带来结构性开销,因为模型必须独立评估每个位置,而不是在一次因果前向传递中完成。为减轻这一计算成本,作者引入 JustGRPO-Fast。该变体受推理由稀疏的高熵分叉 token 引导这一观察启发,仅在 top-25% 最高熵位置计算概率比率 ρi,k。这种优化消除了比率计算所需的 75% 的前向评估。
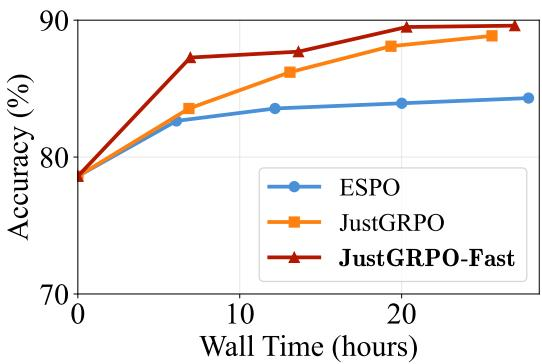
这种定向计算显著改善了准确率与墙钟时间的权衡,使 JustGRPO-Fast 能在更短时间内达到基于近似的基线的峰值准确率,同时继续提升性能。至关重要的是,自回归约束仅在 RL 训练期间应用,保留 dLLM 的并行采样能力以进行高效推理。
实验
评估首先在扩散 LLM 中对比任意顺序解码和自回归(AR)解码,结果显示虽在 k=1 时任意顺序与 AR 匹配,但随着 k 增加其扩展性较差,覆盖有效解空间更小,且随着块大小增加 Pass@k 降低。机制是熵退化:任意顺序延后逻辑连接符,降低其解码时的熵并限制探索。应用 JustGRPO(在 RL 训练期间强制 AR 顺序)产生强大的推理和编程性能,与先前的扩散特定方法竞争,保留并行解码兼容性(在更高并行度下收益更大),并提供有利的准确率/挂钟时间权衡,JustGRPO-Fast 通过将更新聚焦于最高熵位置进一步改进。
JustGRPO 是标准 GRPO 的简单应用,无需扩散特定适配,在 GSM8K 和 MATH-500 等推理基准上达到与先前扩散特定方法相当或更高的准确率。尽管基线设置异构,它仍与使用辅助模块或更大私有训练数据的方法保持竞争力。研究结果表明,对去噪轨迹进行完整组合优化可能不是实现强推理性能所必需的。尽管简单,JustGRPO 在 GSM8K 和 MATH-500 上匹配或超越扩散特定 RL 方法。它仍与依赖辅助模块或显著更大私有训练数据的基线保持竞争力。即使在一致的对齐于 JustGRPO 的统一协议下重现代表性基线,这一结论仍然成立。
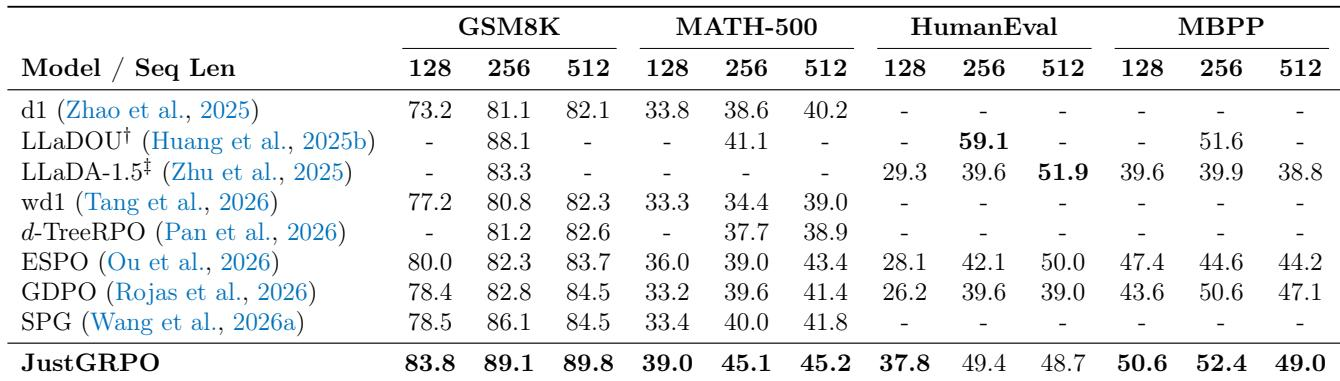
在统一评估协议下,全微调且每解码步骤一个 token,JustGRPO 在所有报告的推理和代码生成基准上达到最高准确率,超越重现的扩散特定基线。收益在数学推理和代码任务中一致,支持训练期间将扩散 LLM 视为顺序生成器的有效性。JustGRPO 在 GSM8K、MATH-500、HumanEval 和 MBPP 上均优于所有重现基线。性能优势在数学推理和代码生成任务中均保持一致,在代码基准上差距最大。统一协议确认,即使与使用辅助模块或更大私有训练数据的基线相比,JustGRPO 仍保持领先。
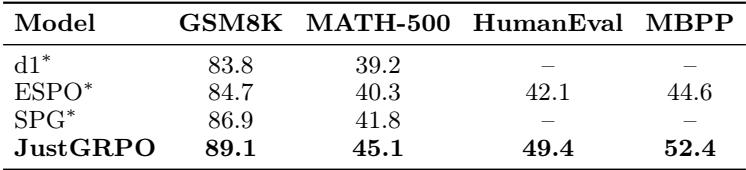
JustGRPO 是标准 GRPO 的直接应用,无需扩散特定适配,在 GSM8K 和 MATH-500 等推理基准上优于或匹配先前的扩散特定强化学习方法。在统一评估协议下,全微调且每解码步骤一个 token,它所有报告的推理和代码生成任务上达到最高准确率,包括 HumanEval 和 MBPP,超越重现基线。研究结果表明,对去噪轨迹进行完整组合优化并非强性能所必需,训练期间将扩散 LLM 视为顺序生成器是有效的。