HyperAIHyperAI

Command Palette

Search for a command to run...

从随机矩阵理论视角看扩散模型的一致性

Binxu Wang Jacob A. Zavatone-Veth Cengiz Pehlevan

摘要

在数据集的不同非重叠子集上训练的扩散模型,当给定相同的噪声种子时,往往会产生极为相似的输出。我们将这种一致性归因于一种简单的线性效应:各划分间共享的高斯统计特性已经能够预测生成图像的很大一部分。为了将其形式化,我们建立了一个随机矩阵理论(RMT)框架,在线性设定下量化有限数据集如何影响学习到的去噪器和采样映射的期望与方差。对于期望,采样变异性充当了通过自洽关系 σ2↦κ(σ2)\sigma^{2} \mapsto \kappa(\sigma^{2})σ2↦κ(σ2) 对噪声水平的重归一化,这解释了有限数据为何会对低方差方向产生过度收缩并将样本拉向数据集均值。对于波动,我们的方差公式揭示了跨划分不一致性的三个关键因素:特征模式间的各向异性、输入间的不均匀性以及与数据集规模的整体标度关系。将确定性等价工具扩展到分数矩阵幂进一步使我们能够分析整个采样轨迹。该理论对线性扩散模型的行为做出了精确预测,我们在 UNet 和 DiT 架构的非记忆化区间验证了这些预测,识别了样本在不同训练数据划分之间偏离的位置和方式。这为扩散模型训练的可复现性提供了一个有原则的基线,将数据的谱特性与生成输出的稳定性联系起来。

一句话总结

哈佛 Kempner 研究所的研究人员开发了一个随机矩阵理论框架,用于解释在不同不重叠数据划分上训练的扩散模型呈现出惊人一致性的现象。该框架通过自洽噪声重整化 σ2↦κ(σ2)\sigma^{2} \mapsto \kappa(\sigma^{2})σ2↦κ(σ2) 形式化有限数据效应,并将各向异性、输入不均匀性和数据集规模缩放识别为跨划分分歧的谱驱动因素。预测在 UNet 和 DiT 架构上得到验证,从而为生成训练建立了有原则的可复现性基线。

核心贡献

  • 该工作识别出共享高斯统计量和稳定线性去噪映射,将其作为使用相同噪声种子在不相交数据集划分上训练的扩散模型产生相似输出的具体机制。
  • 随机矩阵理论框架量化了有限数据对线性扩散模型中学习到的去噪器和采样映射的影响,包括自洽噪声重整化、特征模态各向异性、输入不均匀性和数据集规模缩放。
  • 预测在线性扩散模型以及非记忆化区间下的 UNet 和 DiT 架构中得到验证,识别出跨划分样本偏离的谱方向,并为扩散训练建立可复现性基线。

引言

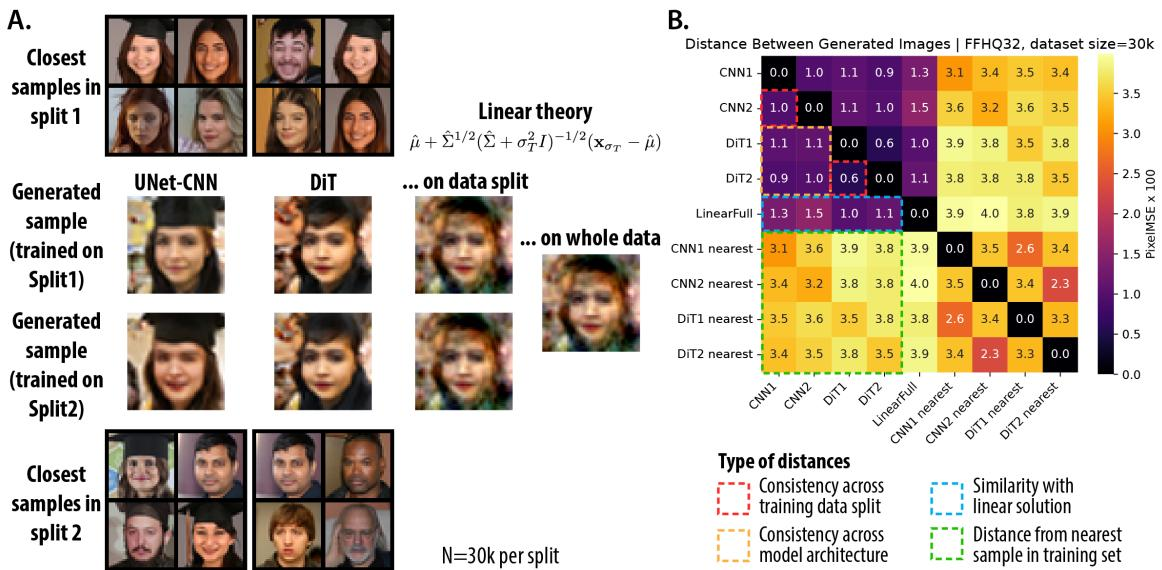
扩散模型和流匹配现在支持图像、视频和蛋白质等领域的生成,并表现出一种不寻常的稳定性:独立训练的模型通常将相同的高斯噪声种子映射到相似输出。这种跨运行一致性很重要,因为它表明学习到的向量场捕捉了数据中稳定的统计结构,这会影响关于泛化、记忆化以及创造性变异性的论断。先前工作观察到这种现象,但缺少清晰的有限样本理论解释其发生原因。与此同时,GANs 和 VAEs 还受到不可识别潜在坐标的进一步复杂化,这些坐标可以在不同训练运行之间旋转。作者利用随机矩阵理论和线性去噪器分析,证明共享高斯统计量已经能够预测跨划分一致性,并且有限数据通过重整化噪声尺度和结构化波动定律引入偏差。他们还把确定性等价扩展至分数矩阵幂,并在 CNN 和 DiT 扩散模型中验证了预测效应。
方法

作者构建了一个分析流程,用于研究有限训练数据如何重塑基于 score 的扩散模型。起点是 EDM 形式,其中目标数据分布 p0(x)p_{0}(\mathbf{x})p0​(x) 被高斯噪声逐渐模糊。对于每个噪声尺度 σ>0\sigma > 0σ>0,噪声化分布为

pσ(x)=(p0∗N(0,σ2I))(x)=∫p0(y)N(x∣y,σ2I)dy.p_{\sigma}(\mathbf{x}) = (p_{0} * \mathcal{N}(0,\sigma^{2}\mathbf{I}))(\mathbf{x}) = \int p_{0}(\mathbf{y}) \mathcal{N}(\mathbf{x} \mid \mathbf{y},\sigma^{2}\mathbf{I}) d\mathbf{y}.pσ​(x)=(p0​∗N(0,σ2I))(x)=∫p0​(y)N(x∣y,σ2I)dy.

扩散模型的中心对象是 score 函数 ∇xlog⁡pσ(x)\nabla_{\mathbf{x}}\log p_{\sigma}(\mathbf{x})∇x​logpσ​(x)。采样随后由概率流 ODE 描述

dxdσ=−σ∇xlog⁡pσ(x).\frac{d\mathbf{x}}{d\sigma} = -\sigma \nabla_{\mathbf{x}}\log p_{\sigma}(\mathbf{x}).dσdx​=−σ∇x​logpσ​(x).

将这条轨迹从大噪声尺度 σT\sigma_{T}σT​ 积分到 σ=0\sigma = 0σ=0,即可将高斯噪声映射到干净样本。在实践中,score 不是直接学习的。作者首先通过最小化去噪 score matching 目标训练去噪器 Dθ\mathbf{D}_{\theta}Dθ​

Lσ=Ex0∼p0, z∼N(0,I)∥Dθ(x0+σz;σ)−x0∥22.\mathcal{L}_{\sigma} = \mathbb{E}_{\mathbf{x}_{0}\sim p_{0},\,\mathbf{z}\sim \mathcal{N}(0,\mathbf{I})} \left\| \mathbf{D}_{\theta}(\mathbf{x}_{0}+\sigma\mathbf{z};\sigma)-\mathbf{x}_{0} \right\|_{2}^{2}.Lσ​=Ex0​∼p0​,z∼N(0,I)​∥Dθ​(x0​+σz;σ)−x0​∥22​.

一旦学习得到去噪器,Tweedie 公式将其转换为 score 估计,

sθ(x,σ)=Dθ(x,σ)−xσ2.\mathbf{s}_{\theta}(\mathbf{x},\sigma) = \frac{\mathbf{D}_{\theta}(\mathbf{x},\sigma)-\mathbf{x}}{\sigma^{2}}.sθ​(x,σ)=σ2Dθ​(x,σ)−x​.

在实用扩散训练中,针对各个噪声尺度上的特定损失通过权重函数 w(σ)w(\sigma)w(σ) 进行组合,形成形式如下的整体损失

L=∫σdσ w(σ)Lσ.\mathcal{L} = \int_{\sigma} d\sigma\, w(\sigma)\mathcal{L}_{\sigma}.L=∫σ​dσw(σ)Lσ​.

这确立了主要训练流程:训练神经去噪器以去除高斯扰动,然后将训练后的去噪器转换为驱动确定性采样的 score 函数。

为了使有限数据行为在分析上可处理,作者在每个噪声尺度下将神经去噪器替换为线性仿射去噪器,

D(x;σ)=Wσx+bσ.\mathbf{D}(\mathbf{x};\sigma) = \mathbf{W}_{\sigma}\mathbf{x} + \mathbf{b}_{\sigma}.D(x;σ)=Wσ​x+bσ​.

在这一设定中,学习到的去噪器仅通过训练数据的经验均值和经验协方差依赖于训练数据。给定经验协方差 Σ^\hat{\Sigma}Σ^,最优线性去噪器为

DΣ^∗(x;σ)=μ^+(Σ^+σ2I)−1Σ^(x−μ^).\mathbf{D}_{\hat{\Sigma}}^{*}(\mathbf{x};\sigma) = \hat{\boldsymbol{\mu}} + (\hat{\boldsymbol{\Sigma}}+\sigma^{2}\mathbf{I})^{-1} \hat{\boldsymbol{\Sigma}} (\mathbf{x}-\hat{\boldsymbol{\mu}}).DΣ^∗​(x;σ)=μ^​+(Σ^+σ2I)−1Σ^(x−μ^​).

作者固定均值,并研究 Σ^\hat{\Sigma}Σ^ 的随机实现如何改变去噪器输出和最终样本,从而隔离协方差波动效应。他们还识别了由最优线性去噪器诱导的采样映射。从初始噪声 xσT\mathbf{x}_{\sigma_{T}}xσT​​ 开始,PF ODE 给出解析轨迹

xΣ^(xσT,σ)=μ^+(Σ^+σ2I)1/2(Σ^+σT2I)−1/2(xσT−μ^).\mathbf{x}_{\hat{\boldsymbol{\Sigma}}}(\mathbf{x}_{\sigma_{T}},\sigma) = \hat{\boldsymbol{\mu}} + (\hat{\boldsymbol{\Sigma}}+\sigma^{2}\mathbf{I})^{1/2} (\hat{\boldsymbol{\Sigma}}+\sigma_{T}^{2}\mathbf{I})^{-1/2} (\mathbf{x}_{\sigma_{T}}-\hat{\boldsymbol{\mu}}).xΣ^​(xσT​​,σ)=μ^​+(Σ^+σ2I)1/2(Σ^+σT2​I)−1/2(xσT​​−μ^​).

令 σ→0\sigma \to 0σ→0 可恢复最终采样映射。因此,在线性情形下,整个训练和采样过程都化为经验协方差在不同独立数据集实现中如何波动。

作者使用的核心分析工具是确定性等价。该方法将涉及 Σ^\hat{\Sigma}Σ^ 的随机矩阵表达式替换为涉及总体协方差 Σ\SigmaΣ 的确定性表达式。核心替换为

Σ^(Σ^+λI)−1≍Σ(Σ+κ(λ)I)−1,\hat{\boldsymbol{\Sigma}} (\hat{\boldsymbol{\Sigma}}+\lambda\mathbf{I})^{-1} \asymp \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\kappa(\lambda)\mathbf{I})^{-1},Σ^(Σ^+λI)−1≍Σ(Σ+κ(λ)I)−1,

其中标量 κ(λ)\kappa(\lambda)κ(λ) 吸收了使用有限样本带来的随机效应。它由自洽方程确定

κ(λ)−λ=γκ(λ)tr⁡[Σ(Σ+κ(λ)I)−1],γ=d/n.\kappa(\lambda)-\lambda = \gamma \kappa(\lambda) \operatorname{tr} \left[ \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\kappa(\lambda)\mathbf{I})^{-1} \right], \qquad \gamma = d/n.κ(λ)−λ=γκ(λ)tr[Σ(Σ+κ(λ)I)−1],γ=d/n.

这里 ddd 是数据维度,nnn 是样本数量。映射 λ↦κ(λ)\lambda \mapsto \kappa(\lambda)λ↦κ(λ) 可以被解释为重整化噪声尺度。对于迹型量,Σ^\hat{\Sigma}Σ^ 中的有限样本噪声会被总体去噪器中更高的有效噪声水平取代。这类似于自能修正,其中经验协方差中的随机性被纳入标量修正项。

作者利用这套工具计算去噪器在不同数据集实现下的期望行为。对于固定探针方向 v\mathbf{v}v,期望满足

EΣ^[v⊤DΣ^∗(x;σ)]≍v⊤[μ+Σ(Σ+κ(σ2)I)−1(x−μ)].\mathbb{E}_{\hat{\boldsymbol{\Sigma}}} \left[ \mathbf{v}^{\top} \mathbf{D}_{\hat{\boldsymbol{\Sigma}}}^{*}(\mathbf{x};\sigma) \right] \asymp \mathbf{v}^{\top} \left[ \boldsymbol{\mu} + \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\kappa(\sigma^{2})\mathbf{I})^{-1} (\mathbf{x}-\boldsymbol{\mu}) \right].EΣ^​[v⊤DΣ^∗​(x;σ)]≍v⊤[μ+Σ(Σ+κ(σ2)I)−1(x−μ)].

该结果表明,有限数据并不只是给去噪器增加噪声。在期望意义上,它们通过用重整化尺度 κ(σ2)\kappa(\sigma^{2})κ(σ2) 替代真实噪声尺度 σ2\sigma^{2}σ2 来发挥作用。由于 κ(σ2)\kappa(\sigma^{2})κ(σ2) 大于 σ2\sigma^{2}σ2,有限样本去噪器会更强烈地压缩输出分量,尤其是在低方差方向。这会产生偏向数据集均值的偏差,类似于在去噪目标中加入自适应 ridge 惩罚。

作者还推导了去噪器在独立训练集之间的方差。作者引入自由度函数

df⁡1(λ)=Tr⁡[Σ(Σ+λI)−1],\operatorname{df}_{1}(\lambda) = \operatorname{Tr} \left[ \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\lambda\mathbf{I})^{-1} \right],df1​(λ)=Tr[Σ(Σ+λI)−1], df⁡2(λ)=Tr⁡[Σ2(Σ+λI)−2],\operatorname{df}_{2}(\lambda) = \operatorname{Tr} \left[ \boldsymbol{\Sigma}^{2} (\boldsymbol{\Sigma}+\lambda\mathbf{I})^{-2} \right],df2​(λ)=Tr[Σ2(Σ+λI)−2],

和

df⁡2(λ,λ′)=Tr⁡[Σ2(Σ+λI)−1(Σ+λ′I)−1].\operatorname{df}_{2}(\lambda,\lambda') = \operatorname{Tr} \left[ \boldsymbol{\Sigma}^{2} (\boldsymbol{\Sigma}+\lambda\mathbf{I})^{-1} (\boldsymbol{\Sigma}+\lambda'\mathbf{I})^{-1} \right].df2​(λ,λ′)=Tr[Σ2(Σ+λI)−1(Σ+λ′I)−1].

输入位置 x\mathbf{x}x 处,沿方向 v\mathbf{v}v 的线性去噪器输出方差可写为

Var⁡Σ^[v⊤DΣ^∗(x;σ)]≍κ(σ2)2n−df⁡2(κ(σ2))◊(v,κ(σ2),Σ)◊(x−μ,κ(σ2),Σ),\operatorname{Var}_{\hat{\boldsymbol{\Sigma}}} \left[ \mathbf{v}^{\top} \mathbf{D}_{\hat{\boldsymbol{\Sigma}}}^{*}(\mathbf{x};\sigma) \right] \asymp \frac{\kappa(\sigma^{2})^{2}} {n-\operatorname{df}_{2}(\kappa(\sigma^{2}))} \Diamond(\mathbf{v},\kappa(\sigma^{2}),\boldsymbol{\Sigma}) \Diamond(\mathbf{x}-\boldsymbol{\mu},\kappa(\sigma^{2}),\boldsymbol{\Sigma}),VarΣ^​[v⊤DΣ^∗​(x;σ)]≍n−df2​(κ(σ2))κ(σ2)2​◊(v,κ(σ2),Σ)◊(x−μ,κ(σ2),Σ),

其中谱核为

◊(u,κ,Σ)=u⊤(Σ+κI)−2Σu.\Diamond(\mathbf{u},\kappa,\boldsymbol{\Sigma}) = \mathbf{u}^{\top} (\boldsymbol{\Sigma}+\kappa\mathbf{I})^{-2} \boldsymbol{\Sigma} \mathbf{u}.◊(u,κ,Σ)=u⊤(Σ+κI)−2Σu.

该表达式可分解为三个可解释部分。第一个因子是由样本量和有效噪声控制的全局尺度。第二个因子是依赖于探针方向 v\mathbf{v}v 的各向异性项。第三个因子是依赖于输入相对均值位移的不均匀性项。当探针方向与 Σ\boldsymbol{\Sigma}Σ 的特征向量对齐,且对应特征值为 λk\lambda_{k}λk​ 时,各向异性核退化为一个函数,其最大值出现在 λk\lambda_{k}λk​ 与 κ(σ2)\kappa(\sigma^{2})κ(σ2) 可比时。这意味着最大的去噪器分歧出现在数据方差与重整化噪声尺度匹配的模式上。

同一视角从单步去噪扩展到完整采样映射。对于较大的终端噪声 σT\sigma_{T}σT​,线性采样映射近似为

xΣ^(xσT,0)=μ+Σ^1/2(Σ^+σT2I)−1/2(xσT−μ)≈μ+Σ^1/2xˉ,\mathbf{x}_{\hat{\boldsymbol{\Sigma}}}(\mathbf{x}_{\sigma_{T}},0) = \boldsymbol{\mu} + \hat{\boldsymbol{\Sigma}}^{1/2} (\hat{\boldsymbol{\Sigma}}+\sigma_{T}^{2}\mathbf{I})^{-1/2} (\mathbf{x}_{\sigma_{T}}-\boldsymbol{\mu}) \approx \boldsymbol{\mu} + \hat{\boldsymbol{\Sigma}}^{1/2}\bar{\mathbf{x}},xΣ^​(xσT​​,0)=μ+Σ^1/2(Σ^+σT2​I)−1/2(xσT​​−μ)≈μ+Σ^1/2xˉ,

其中

xˉ=xσT−μσT.\bar{\mathbf{x}} = \frac{\mathbf{x}_{\sigma_{T}}-\boldsymbol{\mu}}{\sigma_{T}}.xˉ=σT​xσT​​−μ​.

作者随后使用协方差矩阵分数幂的积分表示来推导生成样本的期望:

EΣ^[xΣ^(xσT,0)]≍μ+2π∫0∞Σ(Σ+κ(u2)I)−1xˉ du.\mathbb{E}_{\hat{\boldsymbol{\Sigma}}} \left[ \mathbf{x}_{\hat{\boldsymbol{\Sigma}}}(\mathbf{x}_{\sigma_{T}},0) \right] \asymp \boldsymbol{\mu} + \frac{2}{\pi} \int_{0}^{\infty} \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\kappa(u^{2})\mathbf{I})^{-1} \bar{\mathbf{x}}\,du.EΣ^​[xΣ^​(xσT​​,0)]≍μ+π2​∫0∞​Σ(Σ+κ(u2)I)−1xˉdu.

与总体采样映射相比,该表达式在一个更强的压缩算子上积分,因为 κ(u2)>u2\kappa(u^{2}) > u^{2}κ(u2)>u2。因此,有限数据会产生朝向均值的系统性过压缩,尤其在较低方差特征模态上。

最终样本的方差表示为关于有效噪声变量的双重积分。令 κ=κ(u2)\kappa = \kappa(u^{2})κ=κ(u2) 且 κ′=κ(v2)\kappa' = \kappa(v^{2})κ′=κ(v2),

Var⁡Σ^[v⊤xΣ^(xσT,0)]≍4π2∫0∞∫0∞κκ′n−df⁡2(κ,κ′)◊(v;κ,κ′,Σ)◊(xˉ;κ,κ′,Σ) du dv,\operatorname{Var}_{\hat{\boldsymbol{\Sigma}}} \left[ \mathbf{v}^{\top} \mathbf{x}_{\hat{\boldsymbol{\Sigma}}}(\mathbf{x}_{\sigma_{T}},0) \right] \asymp \frac{4}{\pi^{2}} \int_{0}^{\infty} \int_{0}^{\infty} \frac{\kappa\kappa'} {n-\operatorname{df}_{2}(\kappa,\kappa')} \Diamond(\mathbf{v};\kappa,\kappa',\boldsymbol{\Sigma}) \Diamond(\bar{\mathbf{x}};\kappa,\kappa',\boldsymbol{\Sigma}) \,du\,dv,VarΣ^​[v⊤xΣ^​(xσT​​,0)]≍π24​∫0∞​∫0∞​n−df2​(κ,κ′)κκ′​◊(v;κ,κ′,Σ)◊(xˉ;κ,κ′,Σ)dudv,

其中

◊(a;κ,κ′,Σ)=a⊤Σ(Σ+κI)−1(Σ+κ′I)−1a.\Diamond(\mathbf{a};\kappa,\kappa',\boldsymbol{\Sigma}) = \mathbf{a}^{\top} \boldsymbol{\Sigma} (\boldsymbol{\Sigma}+\kappa\mathbf{I})^{-1} (\boldsymbol{\Sigma}+\kappa'\mathbf{I})^{-1} \mathbf{a}.◊(a;κ,κ′,Σ)=a⊤Σ(Σ+κI)−1(Σ+κ′I)−1a.

同样,方差分解为全局缩放、探针方向各向异性和依赖于初始噪声的不均匀性。初始噪声 xˉ\bar{\mathbf{x}}xˉ 充当采样映射的空间探针。如果输入偏离与高方差特征方向强烈对齐,则这些输入会遇到更大的跨划分分歧。在方向上,方差由同一谱核控制,因此最终采样映射继承去噪器波动的谱结构。

这一分析方案的实证验证总结如下。如下图所示:
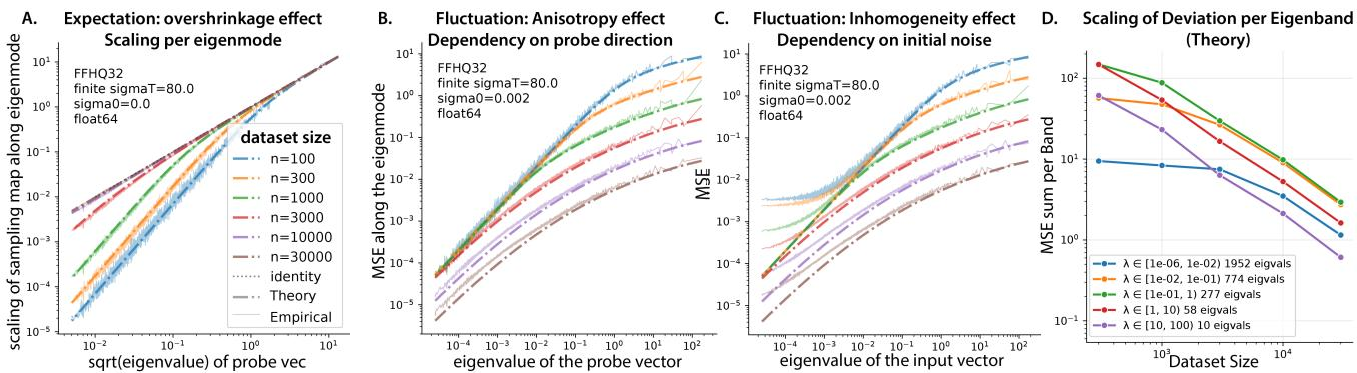
曲线比较了理论确定性等价与经验线性扩散计算,对应不断增大的数据集规模。沿特征模态的采样映射期望缩放显示出朝向均值的过压缩,且在低方差方向上效应最强。跨划分均方误差随探针特征值的变化表明,方向分歧在谱上系统性变化;而随输入特征值的变化表明,沿高方差模式发生位移的位置会带来更大的不确定性。特征能级缩放表明,顶级特征模态可以在中等数据量下迅速稳定,而较低方差模式在跨划分 MSE 衰减之前需要显著更大的数据集。

实验

实验评估了在独立数据划分上训练并使用共享噪声种子采样的扩散模型,比较 UNet 和 DiT 架构,变化数据集规模,并构造统计上失配的划分。这些测试表明,独立训练的模型常常产生相似图像,尤其是在训练数据足够大、超出记忆化区间之后,而数据均值或方差的刻意失配会破坏这种一致性。数值和网络层级的验证进一步表明,高斯与随机矩阵理论框架可以预测样本在划分之间的变化位置,其中各向异性和不均匀偏差集中在数据协方差特征方向上,并需要更大的数据量才能消除。