Command Palette
Search for a command to run...
语言模型能够记忆多少?
语言模型能够记忆多少?
John X. Morris Chawin Sitawarin Chuan Guo Narine Kokhlikyan G. Edward Suh Alexander M. Rush Kamalika Chaudhuri Saeed Mahloujifar
摘要
由于语言固有的结构性,以往关于语言模型记忆的研究难以将记忆与泛化区分开来。我们将记忆形式化地分为两个组成部分:非预期记忆,即模型中包含的关于特定数据集的信息;以及泛化,即模型中包含的关于真实数据生成过程的信息。当我们完全消除泛化时,便可计算总记忆量,从而对模型容量进行估计:我们的测量表明,GPT 类模型的容量约为每个参数 3.6 比特。我们在规模递增的数据集上训练语言模型,并观察到模型持续记忆直至容量耗尽,此时非预期记忆开始下降,模型转而进行泛化。我们训练了数百个参数量从 500K 到 1.5B 不等的 Transformer 语言模型,并推导出一系列将模型容量和数据规模与成员推断关联起来的缩放定律。
一句话总结
该工作形式化地将语言模型记忆分解为非预期记忆与泛化,估计 GPT 风格模型具有每个参数约 3.6 比特的容量,并推导出关联模型容量、数据规模与成员推断的缩放定律。
核心贡献
-
引入了一个形式化的记忆定义,将非预期记忆与泛化分离,并在不依赖训练算法的情况下衡量模型关于特定数据集存储的比特数。该定义通过模型似然进行操作化,并使用信息论和基于 Kolmogorov 复杂度的近似来得到样本级估计。
-
模型容量测量估计,GPT 风格 transformer 语言模型每个参数存储约 3.6 比特;根据架构和精度,报告范围约为 3.5 到 4 比特。在更大数据集上训练表明,此容量会先被特定样本存储填满,然后模型才会用非预期记忆替代泛化,并将该转变与 double descent 联系起来。
-
推导并验证了基于模型容量和数据集规模的成员推断缩放定律,使用了从 500K 到 1.5B 参数的数百个 transformer 模型。这些定律预测,更大的模型可以记忆更多样本,更大的数据集会使推断更困难,并且现代语言模型可能已经在足够多的数据上训练,从而对平均数据点进行可靠的成员推断不太可能。
引言
现代语言模型越来越多地在庞大数据集上训练,同时参数数量相对较小,引发模型是有意学习一般模式,还是无意中存储特定训练样本的问题。以往研究通常通过提取完整训练样本或推断数据集成员来衡量记忆,但这些方法可能混淆死记硬背与泛化,因为语言模型可以被提示生成几乎任何字符串。作者提出一种基于压缩的记忆衡量方式,使用模型似然估计模型关于特定数据点保留的比特数。作者将非预期记忆与泛化分离,表明 transformer 语言模型可以每个参数存储约 3.5 到 4 比特,并推导出缩放定律,显示数据集规模和模型容量如何影响成员推断可靠性。
方法
该方法将记忆视为信息论意义上的测量,衡量训练好的模型编码了其训练分布的哪些信息。作者使用参考模型 Θ 来捕捉数据分布 X 的预期统计规律,同时学习算法 L 将来自 X 的样本映射到训练好的模型 Θ^。存储在 Θ^ 中关于 X 的总信息通过互信息定义为
mem(X,Θ^)=I(X;Θ^)=H(X)−H(X∣Θ^).该量衡量从数据集转移到训练模型中的全部信息。随后,作者通过以参考模型为条件来区分有用泛化与非预期记忆。如果参考模型已经解释了许多数据,那么 Θ^ 提供的额外不确定性降低可归因于非预期记忆:
memU(X,Θ^,Θ)=I(X;Θ^∣Θ)=H(X∣Θ)−H(X∣(Θ,Θ^)).互补量,即预期记忆,是在移除参考模型贡献后,可由模型与数据之间总依赖关系解释的那部分存储信息:
memI(Θ^,X,Θ)=I(X;Θ^)−I(X;Θ^∣Θ).这种区分很重要,因为一些行为已经可以从底层数据分布预测,而另一些行为则要求训练模型编码参考模型无法解释的具体细节。对于测量数据集级非预期记忆,作者还使用超可加性性质。如果 X=(X1,…,Xn) 由独立样本组成,则每个样本非预期记忆之和给出数据集级量的下界:
i=1∑nmemU(Xi,Θ^,Θ)≤memU(X,Θ^,Θ).训练模型的熵 H(Θ^) 也构成上界,意味着非预期记忆随数据规模增长,但不会超过模型总表示容量。
由于对于单个训练模型和单个数据集实例而言,熵和条件熵难以直接估计,作者从基于 Shannon 的统计转向 Kolmogorov 复杂度公式。对于字符串 x,Kolmogorov 内容 HK(x) 是在固定计算模型 f 下满足 f(p)=x 的最短程序 p 的长度:
HK(x)=f(p)=xmin∣p∣.当参考字符串或模型 θ 可用时,条件版本为
HK(x∣θ)=f(p,θ)=xmin∣p∣.对应的互信息变为
IK(x,θ)=HK(x)−HK(x∣θ).利用这种表示,作者定义了 Kolmogorov 记忆及其预期和非预期变体。关键的实际洞见是,尽管精确的 Kolmogorov 复杂度不可计算,但其值可以通过压缩或预测似然进行近似。对于训练好的目标模型 θ^,项 HK(x∣θ^) 由似然 p(x∣θ^) 估计。当目标模型和参考模型都可用时,使用两个似然中较好的一个来估计条件描述:
max{p(x∣θ^),p(x∣θ)}.实际使用的参考模型比目标模型更大,但共享其架构,并在更广泛的数据分布上训练。这使该方法能够将参考模型视为可泛化结构的外部来源,并隔离目标模型在参考模型已解释内容之外存储的信息。
然后该方法使用此测量框架估计模型容量。作者将容量定义为学习算法在数据集之间能够存储的最大总记忆:
Capacity(L)=Xmaxmem(X,L(X)).在实践中,容量通过在不同规模递增的数据集上训练模型,直到训练损失饱和来测量。为避免依赖特定架构或特定超参数所决定的饱和过程,作者以固定步数训练配置,具体为 106 次迭代,对于测试模型而言足以达到饱和。这会为每个模型大小和超参数设置产生可测量的饱和点。
为了将纯记忆与泛化分离,作者还使用合成序列,其中 tokens 从固定词汇表中均匀且独立地采样。由于这些数据不包含模型可泛化的高级结构,预期记忆实际上为零。在这种情况下,总记忆等于非预期记忆:
memI(X,Θ^,Θ)=0,memU(X,Θ^,Θ)=mem(X,Θ^).作者通过在训练模型和参考模型下计算熵并将它们相减来近似所需的条件描述。这产生了合成数据集中有多少比特被存储在训练模型中的经验估计。
该框架通过将数据集规模和模型容量视为两个控制变量,从原始记忆扩展到成员推断。对于训练好的模型 θ 和数据集 D,作者使用 sigmoid 缩放律对成员推断 F1 分数建模:
MembershipF1(θ,D)=21(1+c1σ(c2∣D∣Capacity(θ)+c3)),其中
σ(z)=1+e−z1.该形式捕捉了观察到的行为:当高容量模型在小数据集上训练时,成员推断较强,但随着数据集相对于容量增长,推断变得更困难。作者复用实验文本数据来拟合常数 c1、c2 和 c3,得到 c1=1.34、c2=−0.034 和 c3=−33.14。拟合的 sigmoid 曲线与不同模型容量和数据集规模下观察到的成员推断分数高度一致,通常在一到两个百分点以内。如下图所示:
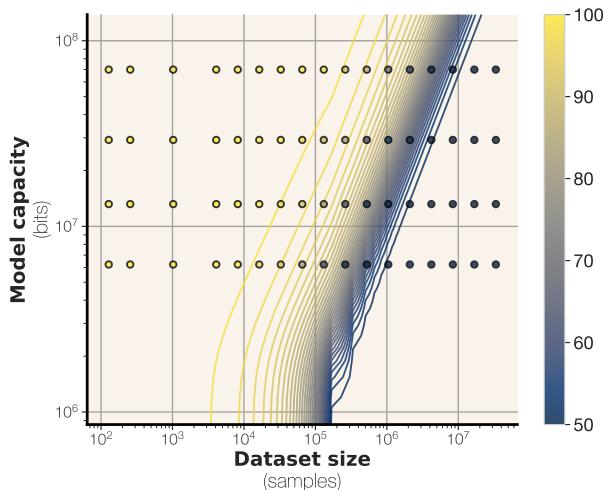
极限行为可直接由拟合律得出。当 ∣D∣→∞ 时,项 Capacity(θ)/∣D∣ 消失,预测的成员推断分数接近 0.5,对应随机水平表现。
实验
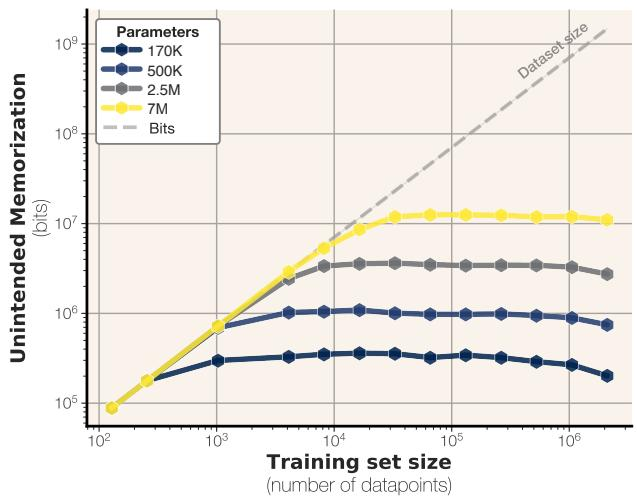
实验使用合成序列和仔细去重的文本,测量不同模型和数据集规模下的非预期记忆、提取和成员推断。合成数据显示出清晰的记忆容量,该容量大致随参数线性扩展,并在超过后趋于平缓,而精度只有适度影响。文本实验表明,超过容量会触发泛化并有助于解释 double descent,而提取和推断难度反映记忆与泛化之间的平衡,而不是单一失败模式。
有效模型容量估计显示,当以每个参数的比特数衡量时,全精度相比半精度只有适度提升。在报告的各种宽度、深度和精度下,容量并不随模型规模成比例增长。这些结果支持更广泛的发现:成员推断强烈取决于模型容量相对于数据集规模的情况,而不是单独取决于参数数量。半精度的每个参数容量估计接近全精度。单独增加宽度或深度不会在比特每参数方面产生大幅提升。当数据集规模相对于模型容量增加时,成员推断变得更困难。
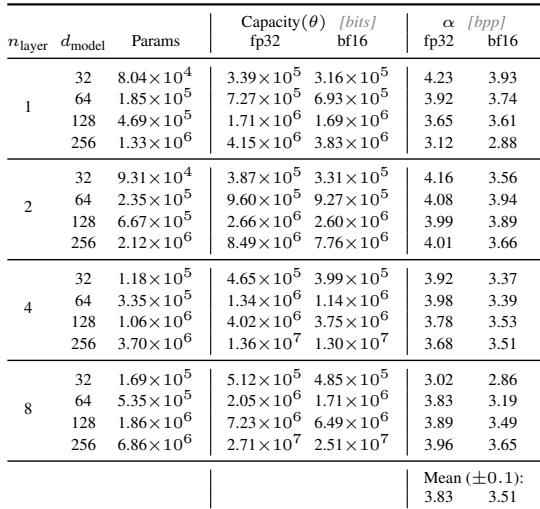
实验评估不同精度、宽度和深度下的有效模型容量,以每个参数的比特数测量容量,而不是仅依赖参数数量。结果显示,全精度相比半精度只有很小优势,增加模型规模不一定会在参数容量上带来成比例收益。总体而言,这些发现支持以下结论:成员推断更多地由模型容量与数据集规模之间的平衡驱动,而不是仅由原始参数数量驱动。