Command Palette
Search for a command to run...
To Grok Grokking: Provable Grokking in Ridge Regression
To Grok Grokking: Provable Grokking in Ridge Regression
Mingyue Xu Gal Vardi Itay Safran
摘要
We study grokking—the onset of generalization long after overfitting—in a classical ridge regression setting. We prove end-to-end grokking results for learning over-parameterized linear regression models using gradient descent with weight decay. Specifically, we prove that the following stages occur: (i) the model overfits the training data early during training; (ii) poor generalization persists long after overfitting has manifested; and (iii) the generalization error eventually becomes arbitrarily small. Moreover, we show, both theoretically and empirically, that grokking can be amplified or eliminated in a principled manner through proper hyperparameter tuning. To the best of our knowledge, these are the first rigorous quantitative bounds on the generalization delay (which we refer to as the "grokking time") in terms of training hyperparameters. Lastly, going beyond the linear setting, we empirically demonstrate that our quantitative bounds also capture the behavior of grokking on non-linear neural networks. Our results suggest that grokking is not an inherent failure mode of deep learning, but rather a consequence of specific training conditions, and thus does not require fundamental changes to the model architecture or learning algorithm to avoid.
一句话总结
该工作证明了在采用梯度下降和权重衰减训练的过参数化岭回归中 grokking 时间的第一个严格定量界,展示了 grokking 经由过拟合、长期泛化不佳以及最终收敛展开,其延迟可通过超参数调节而非架构改动来控制,并在非线性神经网络中得到实证验证。
核心贡献
-
该论文证明了在采用梯度下降和权重衰减训练的过参数化线性岭回归中端到端 grokking,包括早期过拟合、持续泛化不佳,以及最终达到任意小的泛化误差。
-
该论文建立了以训练超参数表示的泛化延迟的定量界,即 grokking 时间,并从理论和实证上表明,恰当的超参数调节可以放大或消除 grokking。
-
该论文实证显示,所推导的界也能捕捉非线性神经网络中的 grokking,且基于阈值的准确率指标可恢复回归中常见的测试误差平台。
引言
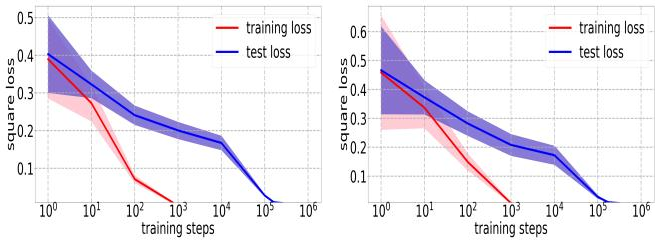
在深度学习及相关 ML 系统中,grokking 是一种反直觉的过拟合现象,训练准确率早期变得完美,而测试泛化仅在很久之后才改善。这一点很重要,因为它挑战了标准正则化直觉,并揭示了模型在优化过程中如何收敛的隐藏动态。以往理论常将 grokking 与训练中的状态转变联系起来,例如 lazy-to-rich 动态或权重衰减效应,但早期分析通常缺乏严格的端到端保证,未能证明过拟合后泛化不佳会长期持续,或研究过于狭窄的设定。作者利用过参数化线性岭回归框架提供了第一个可证明的端到端 grokking 结果,表明梯度下降可以快速拟合训练数据,在可量化的延迟内保持更差的泛化,并随后收敛到泛化良好的全局最优解,同时给出显式超参数界,并证明权重衰减可以控制 grokking 时间。
方法
作者利用教师学生回归流程来分离 grokking 背后的机制。每个输入 xi∈Rd 从边缘分布 Dx 中采样,其标签由固定教师函数 N∗(x) 精确给出。学生模型在特征表示中是线性的:
N(x;θ)=⟨θ,ϕ(x)⟩,其中 ϕ(x):Rd↦Rm 是固定特征映射,θ∈Rm 是可训练的。可实现假设意味着存在某个 θ∗ 使得 N∗(x)=⟨θ∗,ϕ(x)⟩。
训练通过岭回归完成,其将经验平方损失与 ℓ2 正则化项结合:
Ln(θ;λ)=2n1i=1∑n(⟨θ−θ∗,ϕ(xi)⟩)2+2λ∥θ∥22.参数使用朴素梯度下降优化:
θ(t+1)=θ(t)−nηi=1∑n⟨θ(t)−θ∗,ϕ(xi)⟩ϕ(xi)−ηλθ(t),其中 η 是学习率,λ 是权重衰减强度。该方法从随机初始化 θ(0)∼N(0,ν2Im) 开始研究训练,这使得早期动力学和未使用方向的最终衰减在解析上可处理。
grokking 背后的核心机制是学到的权重的子空间分解。设 V=span{ϕ(x1),…,ϕ(xn)} 表示训练样本张成的特征子空间。在过参数化情形 m≫n 下,可通过将 θ 分解为位于 V 内的分量 θ∥ 和位于互补子空间中的分量 θ⊥ 来理解优化。经验梯度主要更新 θ∥,使模型能够快速拟合训练数据。然而,θ⊥ 对经验损失不可见,主要通过权重衰减来减小。因此,当 λ 很小时,训练损失可以快速下降,而导致总体性能较差的分量衰减缓慢。
这会引出两个相关时间点。第一个是
t1=max({t∈N:Ln(θ(t))≥ϵ}),它标志着快速训练损失下降的结束。第二个是
t2=min({t∈N:L(θ(t))≤c}),它标志着总体损失变小的时点。作者表明,在充分样本量、大特征维度、足够小的权重衰减以及兼容的学习率下,t1 可以很小,而 t2 可以任意大。其界意味着
t1≤2ηλmin+(Φ⊤Φ)nln(ϵ6b2∥θ(0)∥22),和
t2≥4ηλln(2(m−n)ν2(λmin(Σ)c+∥θ∗∥2)−2),其中 Φ 是经验特征矩阵,Σ=E[ϕ(x)ϕ(x)⊤] 是特征协方差矩阵,b 界定了特征范数。这些表达式清楚说明了为什么小的 λ 可以延迟泛化,同时不阻止快速训练收敛。
为了将理论界与可观察的超参数行为联系起来,作者评估 λ、样本量 n、特征维度 m 以及初始化尺度 ν2 如何改变 t1 和 t2。如下方图所示:
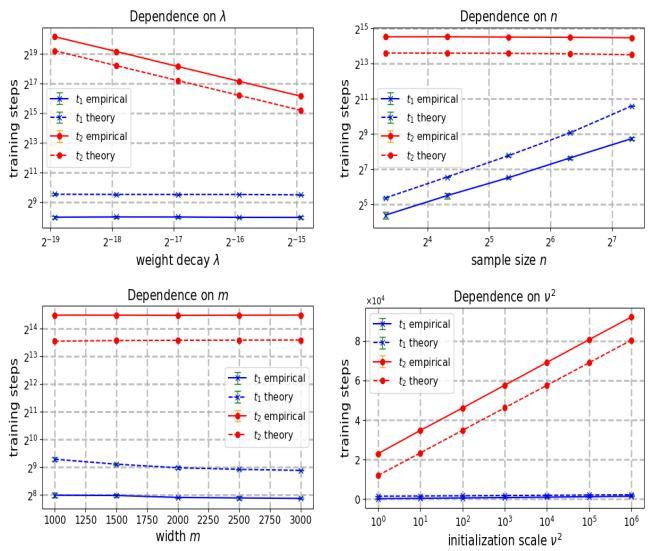
图表明,减小 λ 主要增大 t2,因为正交分量 θ⊥ 在弱权重衰减下衰减更慢。减小 n 可以通过使训练集更容易拟合来缩短 t1,从而扩大区间 t2−t1。在图示范围内,增大 m 的影响相对较小,而增大 ν2 以对数速率使 t1 和 t2 同时上移,且 t2 增长更快,这会放大 grokking 间隔。
实证岭回归流程在部分实验中使用恒等特征映射,因此学生预测 ⟨θ,x⟩。样本在关于特征的分布假设下生成,通常是独立同分布的球面高斯向量,以便估计协方差结构以及经验 Gram 矩阵的正特征值。学习率固定,模型通过带权重衰减的梯度下降训练,直到观察到训练行为和泛化行为。
作者还将训练协议扩展到两层 ReLU 网络。该网络接收输入 x∈Rd,应用第一层权重矩阵 W,将得到的隐藏单元通过 ReLU,并与第二层向量 a 组合。输出形式为
N(x;W,a)=j=1∑majReLU(⟨wj,x⟩).W 和 a 都通过梯度下降和权重衰减共同训练。将零教师作为简化目标,且初始化尺度 ν2 控制第一层权重的初始范数。这一非线性设置用于检验岭回归分析预测的相同超参数趋势是否出现在线性特征模型之外。
实验
实验使用带权重衰减的岭回归和梯度下降来实证检验理论 grokking 行为,在受控超参数下比较训练误差和泛化误差的时间线。结果证实,小权重衰减可以产生早期过拟合与后期泛化之间所预测的分离,并与理论界紧密匹配。向随机特征网络和完全训练的非线性 ReLU 网络的扩展呈现出定性上类似的 grokking 行为,这表明所观察到的现象并不局限于理想化线性设定。