HyperAIHyperAI

Command Palette

Search for a command to run...

缺失数据下的得分匹配

Josh Givens Song Liu Henry W J Reeve

摘要

得分匹配是学习数据分布的重要工具,在扩散过程、基于能量的建模以及图模型估计等众多领域有着广泛应用。然而,尽管应用场景丰富,针对不完整数据下得分匹配使用的研究仍然很少。为此,我们将得分匹配(及其主要扩展形式)推广到灵活的数据缺失场景中,即允许数据在任意坐标子集上部分缺失。我们提出了两种通用的得分匹配变体:一种基于重要性加权(IW)方法,另一种基于变分方法。对于重要性加权方法,我们给出了有限域设定下的有限样本界,并表明其在小样本、低维场景下具有尤为出色的表现。与之互补的是,我们证明变分方法在更复杂的高维场景中表现最为突出,并在真实和模拟数据的图模型估计任务上进行了验证。

一句话总结

作者提出将分数匹配推广到部分缺失数据的设置中,包含两种变体:一种具有有限样本界、适用于小样本低维场景的重要性加权方法;另一种表现最佳的高维场景变分方法。该方法在真实和模拟数据的图模型估计任务中得到验证。

核心贡献

  • 分数匹配以及主要分数匹配扩展被改造用于从部分观测样本估计完整数据分数,采用基于掩码的形式来处理任意缺失坐标集合,并覆盖完全随机缺失和非随机缺失场景。
  • 引入两个缺失数据目标,即重要性加权方法和变分方法,并将其扩展到截断、切片和去噪分数匹配,同时为有限域上的截断重要性加权估计给出有限样本界。
  • 方法在模拟和真实数据上用于参数估计以及高斯图模型边检测。结果表明,在低维小样本情形中重要性加权方法最强,而在更复杂的高维设置中变分方法最强。

引言

分数匹配是一种灵活的免密度方法,用于学习分布的分数函数,支持基于能量的建模、聚类和扩散过程等应用。针对缺失数据的先前工作通常聚焦于神经网络扩散模型,这些模型需要人工损坏数据,不适合显式参数化分数估计;相关的生成式模型和潜变量方法则受到模型类别、收敛不确定性或有偏估计的限制。作者利用缺失分数匹配,将分数匹配扩展到部分观测的多维数据,采用两种方法:具有有限样本保证的边际重要性加权方法,以及面向更高维设置的边际变分方法。该框架兼容显式参数化和神经网络,并将经典、截断、切片和去噪分数匹配适配到参数估计和图模型任务。

数据集
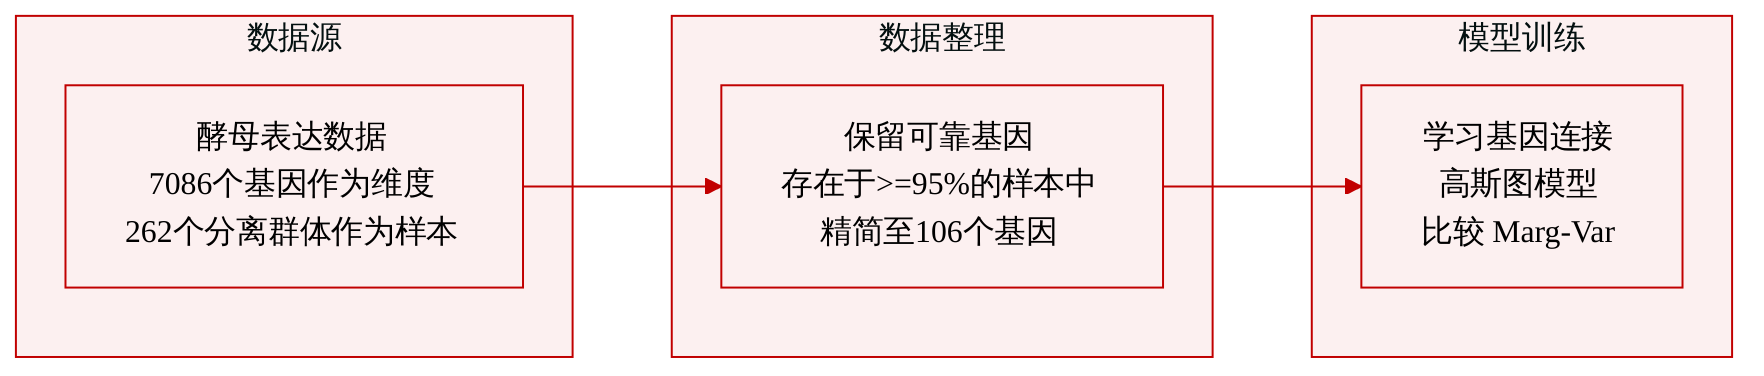
  1. 数据集组成与来源

    • 作者使用 Brem 和 Kruglyak 于 2005 年提出的酵母基因表达数据。
    • 原始数据集包含在 262 个酵母分离株上测量的 7086 个基因或 ORF 的表达读数。
    • 在分析中,基因被视为维度,分离株被视为样本。
  2. 关键子集与过滤规则

    • 完整数据集被缩减到 106 个基因。
    • 只有在至少 95% 的样本中出现的基因才会被保留。
    • 该过滤步骤选择在 262 个分离株中具有极高可用性的基因。
  3. 数据使用方式

    • 作者使用过滤后的基因表达矩阵学习基因之间的关系。
    • 数据用于高斯图模型估计实验。
    • 该数据集的结果显示在图 7 中,其中 Marg-Var 方法与其他方法进行了比较。
  4. 处理与元数据细节

    • 每个样本对应一个酵母分离株。
    • 每个特征或维度对应一个基因或 ORF。
    • 主要处理细节是基于存在性的子集规则,仅保留在至少 95% 的分离株中被观测到的基因。
    • 该数据集未描述额外的裁剪策略。

方法

所提出的方法将存在缺失观测时的密度估计重新表述为边际分数匹配问题。核心思想是学习一个未归一化模型密度 qθ:X→(0,∞)q_\theta:\mathcal X\to(0,\infty)qθ​:X→(0,∞),通过训练其分数

sθ(x)=∇xlog⁡qθ(x),\boldsymbol{s}_\theta(\boldsymbol{x})=\nabla_{\boldsymbol{x}}\log q_\theta(\boldsymbol{x}),sθ​(x)=∇x​logqθ​(x),

而不是最大化边际似然,因为后者需要对未观测坐标计算难以处理的积分。

数据由随机向量 X∈X⊆RdX\in\mathcal X\subseteq\mathbb R^dX∈X⊆Rd 表示。对于观测坐标子集 λ⊆[d]\lambda\subseteq[d]λ⊆[d],与 qqq 关联的边际分数定义为

sλ(xλ)=∇xλlog⁡∫q(x) dx−λ.\boldsymbol{s}_\lambda(\boldsymbol{x}_\lambda) = \nabla_{\boldsymbol{x}_\lambda} \log \int q(\boldsymbol{x})\,\mathrm d\boldsymbol{x}_{-\lambda}.sλ​(xλ​)=∇xλ​​log∫q(x)dx−λ​.

该定义确保一个有效未归一化密度的边际分数本身是真正的分数函数。对应的边际 Fisher 散度为

FM(θ)=E[∥sΛ(XΛ)−sΛ;θ(XΛ)∥2],F_{\mathrm M}(\theta) = \mathbb E\left[ \left\| \boldsymbol{s}_\Lambda(X_\Lambda) - \boldsymbol{s}_{\Lambda;\theta}(X_\Lambda) \right\|^2 \right],FM​(θ)=E[∥sΛ​(XΛ​)−sΛ;θ​(XΛ​)∥2],

其中 Λ\LambdaΛ 表示缺失诱导的随机观测模式。在正则性和可辨识性假设下,作者推导得到可观测的替代目标

LM(θ)=E[2∇XΛ⋅sΛ;θ(XΛ)+∥sΛ;θ(XΛ)∥2]=FM(θ)−C.L_{\mathrm M}(\theta) = \mathbb E\left[ 2\nabla_{X_\Lambda}\cdot\boldsymbol{s}_{\Lambda;\theta}(X_\Lambda) + \left\| \boldsymbol{s}_{\Lambda;\theta}(X_\Lambda) \right\|^2 \right] = F_{\mathrm M}(\theta)-C.LM​(θ)=E[2∇XΛ​​⋅sΛ;θ​(XΛ​)+∥sΛ;θ​(XΛ​)∥2]=FM​(θ)−C.

然后由不完整样本 {XΛi(i)}i=1n\{X_{\Lambda_i}^{(i)}\}_{i=1}^n{XΛi​(i)​}i=1n​ 得到蒙特卡洛估计:

θ^=arg⁡min⁡θ1n∑i=1n[∇XΛi(i)⋅sΛi,θ(XΛi(i))+∥sΛi;θ(XΛi(i))∥2].\hat\theta = \arg\min_\theta \frac{1}{n} \sum_{i=1}^n \left[ \nabla_{X_{\Lambda_i}^{(i)}}\cdot \boldsymbol{s}_{\Lambda_i,\theta}(X_{\Lambda_i}^{(i)}) + \left\| \boldsymbol{s}_{\Lambda_i;\theta}(X_{\Lambda_i}^{(i)}) \right\|^2 \right].θ^=argθmin​n1​i=1∑n​[∇XΛi​(i)​​⋅sΛi​,θ​(XΛi​(i)​)+​sΛi​;θ​(XΛi​(i)​)​2].

该公式将经典分数匹配推广到目标密度必须对未观测变量进行边际化的场景。它也自然扩展到紧致支持分布,通过截断边际目标实现。对于具有边界 ∂X\partial\mathcal X∂X 的紧致 X\mathcal XX,引入一个在边界附近变为零的逐坐标加权函数 gΛg_\LambdagΛ​。边际截断 Fisher 散度使用权重来抑制边界区域的影响:

FTM(θ)=E[∥gΛ(XΛ)1/2∘(sΛ(XΛ)−sΛ;θ(XΛ))∥2].F_{\mathrm{TM}}(\theta) = \mathbb E\left[ \left\| g_\Lambda(X_\Lambda)^{1/2} \circ \left( \boldsymbol{s}_\Lambda(X_\Lambda) - \boldsymbol{s}_{\Lambda;\theta}(X_\Lambda) \right) \right\|^2 \right].FTM​(θ)=E[​gΛ​(XΛ​)1/2∘(sΛ​(XΛ​)−sΛ;θ​(XΛ​))​2].

相应的训练目标包含分数曲率项和边界修正项:

LTM(θ)=E[∑j∈ΛgΛ(XΛ)j(sΛ;θ(XΛ)j2+2∂jsΛ;θ(XΛ)j)+∑j∈Λ2∂jgΛ(XΛ)jsΛ;θ(XΛ)j].L_{\mathrm{TM}}(\theta) = \mathbb E\left[ \sum_{j\in\Lambda} g_\Lambda(X_\Lambda)_j \left( s_{\Lambda;\theta}(X_\Lambda)_j^2 + 2\partial_j s_{\Lambda;\theta}(X_\Lambda)_j \right) + \sum_{j\in\Lambda} 2\partial_j g_\Lambda(X_\Lambda)_j s_{\Lambda;\theta}(X_\Lambda)_j \right].LTM​(θ)=E​j∈Λ∑​gΛ​(XΛ​)j​(sΛ;θ​(XΛ​)j2​+2∂j​sΛ;θ​(XΛ​)j​)+j∈Λ∑​2∂j​gΛ​(XΛ​)j​sΛ;θ​(XΛ​)j​​.

这一适配很重要,因为标准分数匹配通常要求密度在无穷远处趋近于零,而当支持集有界或紧致时需要截断变体。

主要计算挑战在于边际分数

sλ;θ(xλ)=∇xλlog⁡∫qθ(xλ,x−λ) dx−λ\boldsymbol{s}_{\lambda;\theta}(\boldsymbol{x}_\lambda) = \nabla_{\boldsymbol{x}_\lambda} \log \int q_\theta(\boldsymbol{x}_\lambda,\boldsymbol{x}_{-\lambda})\,\mathrm d\boldsymbol{x}_{-\lambda}sλ;θ​(xλ​)=∇xλ​​log∫qθ​(xλ​,x−λ​)dx−λ​

通常不可计算。该方法通过两种互补方式处理这一挑战:重要性加权,以及梯度优先的变分估计器。

第一种方法使用定义在未观测坐标上的辅助提议密度 p′p'p′ 估计边际积分:

∫qθ(xλ,x−λ) dx−λ=EX−λ′∼p′[qθ(xλ,X−λ′)p′(X−λ′)].\int q_\theta(\boldsymbol{x}_\lambda,\boldsymbol{x}_{-\lambda})\,\mathrm d\boldsymbol{x}_{-\lambda} = \mathbb E_{X'_{-\lambda}\sim p'} \left[ \frac{q_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda})}{p'(X'_{-\lambda})} \right].∫qθ​(xλ​,x−λ​)dx−λ​=EX−λ′​∼p′​[p′(X−λ′​)qθ​(xλ​,X−λ′​)​].

给定 rrr 个独立补全 X−λ′(1),…,X−λ′(r)∼p′X'^{(1)}_{-\lambda},\dots,X'^{(r)}_{-\lambda}\sim p'X−λ′(1)​,…,X−λ′(r)​∼p′,边际分数估计为

s^λ,r;θ(xλ)=∇xλlog⁡[1r∑k=1rqθ(xλ,X−λ′(k))p′(X−λ′(k))].\hat{\boldsymbol{s}}_{\lambda,r;\theta}(\boldsymbol{x}_\lambda) = \nabla_{\boldsymbol{x}_\lambda} \log \left[ \frac{1}{r} \sum_{k=1}^r \frac{q_\theta(\boldsymbol{x}_\lambda,X'^{(k)}_{-\lambda})} {p'(X'^{(k)}_{-\lambda})} \right].s^λ,r;θ​(xλ​)=∇xλ​​log[r1​k=1∑r​p′(X−λ′(k)​)qθ​(xλ​,X−λ′(k)​)​].

这些估计的边际分数被直接代入蒙特卡洛边际分数匹配目标。这为常规边际分数匹配和截断边际分数匹配提供了实用估计器。对于截断情形,可以针对边际目标推导有限样本误差界。该误差界大致随

plog⁡(dnrA/δ)min⁡{r,n},\sqrt{ \frac{p\log(dnrA/\delta)}{\min\{r,n\}} },min{r,n}plog(dnrA/δ)​​,

缩放,表明增加重要性加权样本数量 rrr 能改善分数误差。然而,与由 nnn 控制的统计收敛速率匹配需要 rrr 与 nnn 同阶,导致计算代价随数据规模二次增长。在实践中,较小的 rrr 通常足以稳定训练,但重要性加权估计器可能在高维中变得有偏或不稳定,因为积分估计位于非线性运算内部。

第二种方法在近似期望之前先推导参数梯度,从而解决这一问题。作者不再构造显式边际分数估计器再对其进行微分,而是先将边际分数匹配目标的梯度写成关于条件补全的期望和协方差的表达式。一个关键恒等式指出

sθ;λ(xλ)=E′[sθ(xλ,X−λ′)λ],\boldsymbol{s}_{\theta;\lambda}(\boldsymbol{x}_\lambda) = \mathbb E'\left[ \boldsymbol{s}_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda})_\lambda \right],sθ;λ​(xλ​)=E′[sθ​(xλ​,X−λ′​)λ​],

其中 E′\mathbb E'E′ 表示相对于模型条件补全分布

X−λ′∣Xλ=xλ∼pθ(⋅∣xλ).X'_{-\lambda}\mid X_\lambda=\boldsymbol{x}_\lambda \sim p_\theta(\cdot\mid \boldsymbol{x}_\lambda).X−λ′​∣Xλ​=xλ​∼pθ​(⋅∣xλ​).

的期望。更一般地,对于函数 hθh_\thetahθ​,期望的梯度可以分解为

∇E′[hθ(xλ,X−λ′)]=E′[∇hθ(xλ,X−λ′)]+Cov⁡′(∇θlog⁡qθ(xλ,X−λ′),hθ(xλ,X−λ′)).\nabla \mathbb E'\left[ h_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda}) \right] = \mathbb E'\left[ \nabla h_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda}) \right] + \operatorname{Cov}' \left( \nabla_\theta\log q_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda}), h_\theta(\boldsymbol{x}_\lambda,X'_{-\lambda}) \right).∇E′[hθ​(xλ​,X−λ′​)]=E′[∇hθ​(xλ​,X−λ′​)]+Cov′(∇θ​logqθ​(xλ​,X−λ′​),hθ​(xλ​,X−λ′​)).

这一变换是方法的核心,因为关于 pθ(⋅∣XΛ)p_\theta(\cdot\mid X_\Lambda)pθ​(⋅∣XΛ​) 的困难期望出现在微分算子之外。一旦梯度被重写为该形式,条件分布和协方差就可以使用任意生成式近似方案进行近似,而不必被绑定为对数内部的显式重要性权重。

所得的边际分数匹配梯度优先目标可以写为

∇θLM(θ)=EXΛ∼p[2∑j∈Λ(ΨΛ(sθ(.)j2+∂jsθ(.)j)−E′[sθ(XΛ,X−Λ′)j]ΨΛ(sθ(.)j))],\nabla_\theta L_{\mathrm M}(\theta) = \mathbb E_{X_\Lambda\sim p} \left[ 2 \sum_{j\in\Lambda} \left( \Psi_\Lambda \left( s_\theta(.)_j^2+\partial_j s_\theta(.)_j \right) - \mathbb E'\left[ s_\theta(X_\Lambda,X'_{-\Lambda})_j \right] \Psi_\Lambda \left( s_\theta(.)_j \right) \right) \right],∇θ​LM​(θ)=EXΛ​∼p​​2j∈Λ∑​(ΨΛ​(sθ​(.)j2​+∂j​sθ​(.)j​)−E′[sθ​(XΛ​,X−Λ′​)j​]ΨΛ​(sθ​(.)j​))​,

其中协方差增强期望算子为

ΨΛ(h)=E′[∇θh(XΛ,X−Λ′)]+Cov⁡′(∇θlog⁡qθ(XΛ,X−Λ′),h(XΛ,X−Λ′)).\Psi_\Lambda(h) = \mathbb E'\left[ \nabla_\theta h(X_\Lambda,X'_{-\Lambda}) \right] + \operatorname{Cov}' \left( \nabla_\theta\log q_\theta(X_\Lambda,X'_{-\Lambda}), h(X_\Lambda,X'_{-\Lambda}) \right).ΨΛ​(h)=E′[∇θ​h(XΛ​,X−Λ′​)]+Cov′(∇θ​logqθ​(XΛ​,X−Λ′​),h(XΛ​,X−Λ′​)).

通过在式中插入边界权重 gΛg_\LambdagΛ​ 及其导数,可以得到截断边际分数匹配的对应表达式:

∇θLTM(θ)=E[2∑j∈Λ{gΛ(XΛ)j[ΨΛ(sθ(.)j2+∂jsθ(.)j)−E′[sθ(XΛ,X−Λ′)j]ΨΛ(sθ(.)j)]+12∂jgΛ(XΛ)jΨΛ(sθ(.)j)}].\nabla_\theta L_{\mathrm{TM}}(\theta) = \mathbb E \left[ 2 \sum_{j\in\Lambda} \left\{ g_\Lambda(X_\Lambda)_j \left[ \Psi_\Lambda \left( s_\theta(.)_j^2+\partial_j s_\theta(.)_j \right) - \mathbb E'\left[ s_\theta(X_\Lambda,X'_{-\Lambda})_j \right] \Psi_\Lambda \left( s_\theta(.)_j \right) \right] + \frac{1}{2} \partial_j g_\Lambda(X_\Lambda)_j \Psi_\Lambda \left( s_\theta(.)_j \right) \right\} \right].∇θ​LTM​(θ)=E​2j∈Λ∑​{gΛ​(XΛ​)j​[ΨΛ​(sθ​(.)j2​+∂j​sθ​(.)j​)−E′[sθ​(XΛ​,X−Λ′​)j​]ΨΛ​(sθ​(.)j​)]+21​∂j​gΛ​(XΛ​)j​ΨΛ​(sθ​(.)j​)}​.

变分模块用可处理的生成式条件分布

pϕ′(x−λ∣xλ).p'_\phi(x_{-\lambda}\mid x_\lambda).pϕ′​(x−λ​∣xλ​).

来近似模型条件分布 pθ(x−λ∣xλ)p_\theta(x_{-\lambda}\mid x_\lambda)pθ​(x−λ​∣xλ​)。

由于目标条件分布依赖于当前模型参数 θ\thetaθ,变分参数 ϕ\phiϕ 必须随 θ\thetaθ 的变化而更新。变分模型通过最小化以下 KL 风格差异来训练

JKL(ϕ,θ)=E[log⁡(pϕ′(X−Λ′∣XΛ)qθ(XΛ,X−Λ′))],J_{\mathrm{KL}}(\phi,\theta) = \mathbb E \left[ \log \left( \frac{ p'_\phi(X'_{-\Lambda}\mid X_\Lambda) }{ q_\theta(X_\Lambda,X'_{-\Lambda}) } \right) \right],JKL​(ϕ,θ)=E[log(qθ​(XΛ​,X−Λ′​)pϕ′​(X−Λ′​∣XΛ​)​)],

或者最小化分数拟合的 Fisher 风格目标

JF(ϕ,θ)=E[∥∇X−Λ′log⁡(pϕ′(X−Λ′∣XΛ)qθ(XΛ,X−Λ′))∥2],J_{\mathrm{F}}(\phi,\theta) = \mathbb E \left[ \left\| \nabla_{X'_{-\Lambda}} \log \left( \frac{ p'_\phi(X'_{-\Lambda}\mid X_\Lambda) }{ q_\theta(X_\Lambda,X'_{-\Lambda}) } \right) \right\|^2 \right],JF​(ϕ,θ)=E[​∇X−Λ′​​log(qθ​(XΛ​,X−Λ′​)pϕ′​(X−Λ′​∣XΛ​)​)​2],

其中期望在从受损数据分布抽取的不完整观测 XΛX_\LambdaXΛ​ 以及从当前变分条件分布抽取的补全上计算:

(XΛ,X−Λ′)∼pϕ′(X−Λ′∣XΛ) p(XΛ).(X_\Lambda,X'_{-\Lambda}) \sim p'_\phi(X'_{-\Lambda}\mid X_\Lambda)\,p(X_\Lambda).(XΛ​,X−Λ′​)∼pϕ′​(X−Λ′​∣XΛ​)p(XΛ​).

分数形式目标的优点在于不需要变分近似中的归一化常数,因为对数密度的梯度对乘法归一化因子保持不变。

因此,完整训练过程是交替且嵌套的。首先,对于一批不完整观测,该方法从 pϕ′(⋅∣XΛ)p'_\phi(\cdot\mid X_\Lambda)pϕ′​(⋅∣XΛ​) 中采样若干缺失坐标补全。这些补全用于估计梯度优先目标中出现的期望和协方差。随后计算边际分数匹配损失的梯度,并用它更新分数模型参数 θ\thetaθ。由于改变 θ\thetaθ 会改变 pϕ′p'_\phipϕ′​ 需要匹配的模型条件补全,因此变分参数 ϕ\phiϕ 也会更新,通常是在每个外层 θ\thetaθ 步骤之后执行若干内层梯度步骤。这样可保持变分条件分布足够准确,以近似随着分数模型变化而变得越来越难计算的模型条件分布。

相同的梯度优先变分结构可以适配到其他分数匹配变体,包括切片分数匹配和去噪分数匹配,以及截断边际目标。其核心架构模式是三个组件的耦合:未归一化分数模型 qθq_\thetaqθ​、辅助或变分补全模型 pϕ′p'_\phipϕ′​,以及避免对难以计算的边际积分求导的蒙特卡洛梯度估计器。

实验

实验在截断高斯、非高斯以及高斯图模型任务上评估所提出的重要性加权方法和变分边际分数匹配方法,并与 EM 和朴素置零分数方法进行比较,实验数据包含模拟缺失数据和真实缺失数据。在这些设置中,所提出的方法总体可靠,其中变分方法在高维且强结构问题中优势最明显,而朴素置零策略随着变量间依赖性增强而表现不佳。这些结果支持如下结论:有原则的边际化能够在数据受损下实现更准确的分数估计和依赖关系恢复,尽管在低结构或截断高斯情形中更简单的近似仍具竞争力。


用 AI 构建 AI

从创意到上线——通过免费 AI 协同编码、开箱即用的环境和最优惠的 GPU 价格,加速您的 AI 开发。

AI 协同编码
开箱即用的 GPU
最优定价

HyperAI Newsletters

订阅我们的最新资讯
我们会在北京时间 每周一的上午九点 向您的邮箱投递本周内的最新更新
邮件发送服务由 MailChimp 提供