Command Palette
Search for a command to run...
掷骰三思:超越下一个词元预测的创造力极限
掷骰三思:超越下一个词元预测的创造力极限
Vaishnavh Nagarajan Chen Henry Wu Charles Ding Aditi Raghunathan
摘要
我们设计了一组极简算法任务,作为开放式现实世界任务的粗略抽象。这使得我们能够清晰且可控地量化当前语言模型的创造力极限。与现实世界中需要创造性、前瞻性思维跳跃的任务类似,我们的任务要求一个隐式的、开放式的随机规划步骤,该步骤要么 (a) 在抽象知识图谱中发现新的关联(如文字游戏、类比推理或科研),要么 (b) 构建新的模式(如设计数学问题或新型蛋白质)。在这些任务中,我们从实证和概念两个层面论证了下一个词元学习的短视性;多词元方法——即无教师训练和扩散模型——在生成多样且原创的输出方面表现更优。其次,为了在不损害连贯性的前提下引入随机性,我们发现注入噪声到输入层(称为种子条件化)的效果出人意料地好,与从输出层进行温度采样相当(在某些条件下甚至更优)。因此,我们的工作为分析开放式创造性技能提供了一个有原则的、极简的测试平台,并为超越下一个词元学习和温度采样提供了新的论据。部分代码已开源至 https://github.com/chenwu98/algorithmic-creativity
一句话总结
作者提出了一套最小算法任务,用于抽象开放式创造性技能,并表明与多 token 方法(如无教师训练和扩散模型)相比,下一 token 预测具有近视性;同时表明在输入层注入噪声(种子条件化)在激发多样且连贯输出方面可匹配或超过输出层温度采样。
核心贡献
-
为开放式创造力引入一个最小算法基准,抽象出在抽象知识图谱中发现新关联或构建新模式的各类任务,例如文字游戏、类比、研究、数学问题设计和蛋白质设计。该基准能够对原创性和多样性进行受控测量。
-
基准上的实验表明,在创造性规划中下一 token 学习具有近视性,而多 token 方法(包括无教师训练和扩散模型)能产生更多样、更具原创性的输出,并改善多样性与准确性之间的权衡。
-
种子条件化在输入层注入噪声以诱发随机性,并被报告为在保持连贯性方面与输出层温度采样相当,在某些条件下甚至更优,同时提升多样化且更具创造性的生成。
引言
作者借鉴认知科学,利用最小化、受控的算法任务来研究语言模型中的创造力,尤其是开放式生成,其中输出不仅需要正确,还必须连贯、多样且具原创性。这对科学构想、新型训练数据生成,以及依赖多样化探索的测试时扩展方法等应用很重要;但已有工作通常以主观方式评估现实世界创造力,并在模型记忆训练数据时难以验证原创性。作者还认为,标准下一 token 预测以及通过温度采样实现输出级随机性,并不契合需要潜在规划和创造性思维跃迁的任务。其主要贡献是一套隔离组合式创造力和探索式创造力的开放式任务,并配有一个客观的“算法创造力”指标;他们表明,多 token 方法(如无教师训练或扩散)优于下一 token 预测,而种子条件化能够诱导有用的多样性。
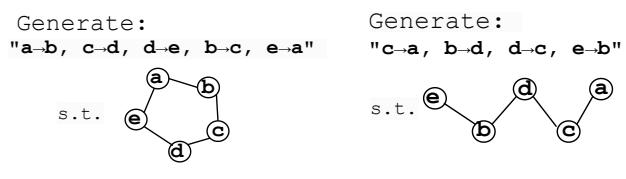
数据集
-
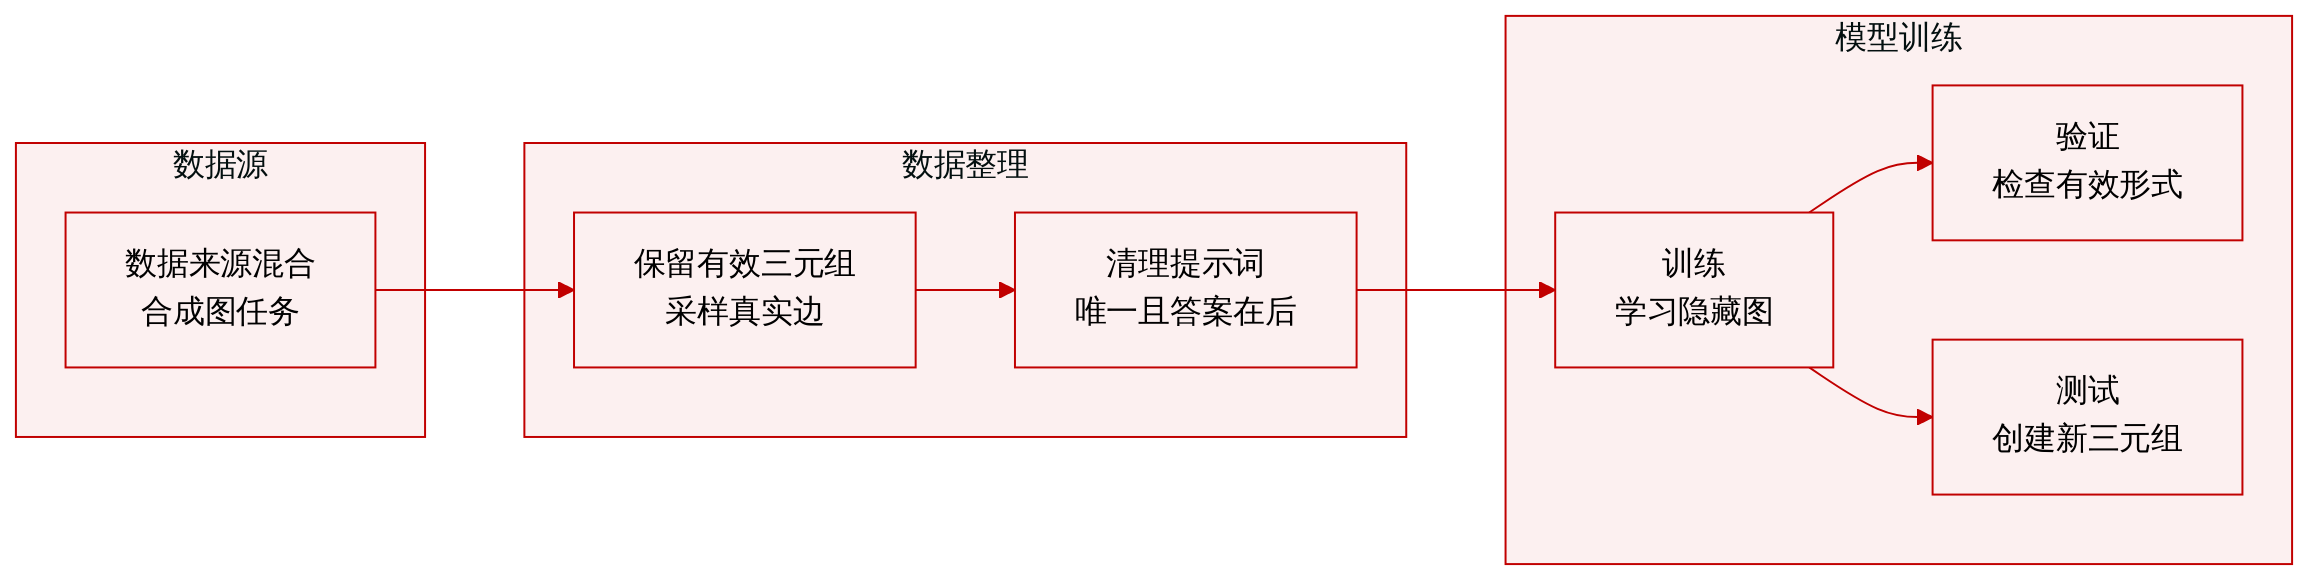
数据集是合成的、基于图的,为两项算法创造力任务创建:兄弟节点发现和三角形发现。它不来自外部语料库;作者构造图结构并从其中采样有效样本。
-
兄弟节点发现使用固定二部图,包含父顶点和子顶点。每个样本是一个三元组
(gamma, gamma', Gamma),其中gamma和gamma'是共享父节点Gamma的兄弟。作者通过要求两个兄弟均连接到同一父节点来定义连贯性,然后从所有有效兄弟-父节点三元组上的均匀分布采样。 -
在兄弟节点发现中,模型接收独立同分布的有效三元组样本。上下文本身不提供图,因此模型必须推断并将图邻接关系存储在权重中。三元组的格式把父节点放在最后,这会增加标准下一 token 预测任务的难度,因为父节点或关键答案是在两个兄弟之后生成的。
-
三角形发现使用知识图谱
G = (V, E)。每个样本是形成三角形的三元组(v1, v2, v3),即顶点之间三个成对边都必须存在于图中。这是兄弟节点发现的更高阶版本,因为模型必须协调三条被记住的边,而不是单条父子关系。 -
对于三角形发现,作者将同一三角形的不同排列视为一个唯一样本。这种过滤或唯一性规则防止重复三角形被分别计数。确切的字符串格式细节延后到论文附录。
-
该数据被用作程序性任务分布,而不是真实世界标注数据集。模型在训练期间观察有效样本,并通过从记忆中的图结构生成新的有效三元组来评估。兄弟节点发现关注单跳父节点回忆,而三角形发现测试多边缘规划。
-
处理细节包括连贯性过滤、三角形排列唯一性过滤,以及刻意隐藏模型图结构的提示格式。提供文本未说明确切数据集规模、词表、训练测试划分比例或两项任务之间的混合权重。
方法
方法与训练设计
作者构建了一个开放式算法框架,用于评估创造性泛化,方法是强制模型发现训练上下文中不可直接看到的潜在关系结构。核心思想是将创造过程编码为隐藏的组合规则。在组合式创造力中,模型必须回忆实体,并在关系约束下排列它们,从而发现存储在权重中、而非暴露在上下文里的类图结构。在探索式创造力中,模型必须在已知规则空间内生成新的有效结构,例如边可被重新排列成连贯回路或路径的图。
一个代表性任务是圆环构造。模型输出一个邻接表
s=(vi1,vi2),(vi3,vi4),…并且只有当存在一个化解排列 π 满足如下关系时,该字符串才被视为连贯:
π(s)=(vj1,vj2),(vj2,vj3),…,(vjn,vj1)其中 j1,…,jn 是互异索引。排列 π 表示将看似无序的边列表转化为有效循环路径的潜在创造性结构。为了正确度量新颖性,由同一化解排列生成但使用不同顶点标签的样本会被视为重复。这可以防止表层变体,例如仅更换字符或符号而保留相同情节动态,被计入创造性进步。一个更简单的直线路径构造变体使用相同逻辑,但化解排列形成的是通向死胡同的路径,而不是返回第一个顶点。
训练流程的设计使模型只观察 token 序列,并必须推断底层隐藏结构。这些任务具有排列不变性,意味着没有哪个 token 顺序享有特权,潜在创造规则必须从整个序列中的分散证据里恢复。这使得学习问题不同于那些推理路径在 token 层面几乎可见的算法任务。
对于使用下一 token 预测训练的模型,作者采用标准有监督 teacher forcing 目标。给定提示 p 和目标序列 s,模型使用提示和先前目标 token 预测每个 token si:
LNTP(θ)=−i∑logpθ(si∣p,s<i).然而,预期推理过程更自然地可由潜在计划 z 以及给定计划下的连贯输出条件分布描述:
p(s)=z∑p(z)p(s∣z).在这种形式化下,模型可以先选择一个潜在结构,然后在该结构条件下生成表层序列。例如,如果父节点必须在两个兄弟节点之后生成,有效生成规则是先规划父节点,再输出子节点,大致只需要为每条有效父子边提供一个训练样本。相比之下,下一 token 学习器可能利用可见前缀作为输入,并从可见兄弟对中推断父节点。这种捷径有时被称为“聪明的汉斯”式解决方案,可能主导早期学习,并减少潜在计划所获得的有用梯度信号。随后,模型可能通过更复杂的成对下一 token 条件来学习第二个兄弟,这可能需要远多于潜在计划方法所需的训练样本。
为了研究这种困难是否是自回归因子化所特有,作者还使用无教师训练训练多 token Transformer 变体。在这种设定下,模型从提示和被遮罩占位位置同时预测所有目标 token。精确遮罩时间表并不是方法的核心,但该目标鼓励模型在依赖已揭示真实前缀的情况下仍生成完整结构化完成。在实践中,训练过程将这种同时预测目标与标准下一 token 预测目标结合,使模型既能学习局部序列规律,又能学习更整体的序列补全行为。
作者使用离散扩散模型作为额外的非自回归对照。该模型在目标序列的遮罩或损坏版本上训练,并学习从不同程度的损坏中恢复原始连贯输出。这产生了一种在完全遮罩重建与部分损坏补全之间插值的训练机制。在推理时,模型从完全遮罩或损坏的 token 序列开始,迭代修改 token 子集,直到出现完整且连贯的输出。这种迭代修正过程不同于标准 Transformer 生成,后者逐 token 进行。
对于 Transformer 模型,推理通过自回归解码提取独立样本来进行。这同时适用于使用下一 token 预测训练的模型,以及使用组合目标训练的多 token Transformer 模型。根据目标是最大化连贯输出还是获得更高样本多样性,生成可以使用贪心解码或核采样完成。
为了更明确地控制多样性,作者引入种子条件化。每个训练样本都与一个任意随机前缀配对,该前缀称为种子,并且不携带直接语义。模型学习在该种子条件下生成输出。测试时使用新的随机种子来诱发不同补全。该设计为模型提供了一个独立控制变量,可能鼓励一个种子对应一个潜在计划,而不是要求高温 softmax 同时表示许多相互竞争的创造性选择。从概念上,种子条件化也可视为一种受控方式来模拟提示措辞变化,不同种子诱发不同内部轨迹,同时保持底层任务固定。
实验
实验使用多 token、下一 token、无教师、扩散和种子条件化 Transformer 配置评估算法创造力和摘要能力,包括较大的 Gemma 模型,以及较小的 Transformer 和扩散基线。多 token 预测显著提升创造力,尤其对于较大模型,并减少与记忆相关的失败;无教师目标对小 Transformer 的直接创造力提升较小,但改善多样性和摘要质量。种子条件化是 Transformer 的另一重要多样性机制,不依赖温度即可增加创造性输出,并作为训练目标效果的补充而非替代。