Command Palette
Search for a command to run...
COLLABLLM:从被动响应者到主动协作者
COLLABLLM:从被动响应者到主动协作者
Shirley Wu Michel Galley Baolin Peng Hao Cheng Gavin Li Yao Dou Weixin Cai James Zou Jure Leskovec Jianfeng Gao
摘要
大型语言模型通常以下一轮奖励进行训练,这限制了其优化长期交互的能力。因此,它们往往对模糊或开放式的用户请求做出被动响应,无法帮助用户达成最终意图,导致对话效率低下。为解决这些局限,我们提出了 COLLABLLM,一种新颖且通用的训练框架,用于增强多轮人机交互协作。其关键创新在于一种协作模拟方法,利用多轮感知奖励来估计响应的长期贡献。通过强化微调这些奖励,COLLABLLM 不仅能回应用户请求,还能主动揭示用户意图并提供有见地的建议——这是迈向更人性化 AI 的关键一步。我们还设计了一个多轮交互基准,包含文档创建等三项具有挑战性的任务。COLLABLLM 显著优于基线,任务性能平均提升 18.5%,LLM 评判的交互性平均提升 46.3%。最后,我们进行了涉及 201 名评判员的大规模用户研究,其中 COLLABLLM 将用户满意度提高了 17.6%,并将用户花费时间减少了 10.4%。
一句话总结
微软研究院和斯坦福大学提出了 COLLABLLM,一种训练框架,利用带有跨轮次感知奖励的协作模拟来优化长期的人机交互,实现主动发现用户意图并提供建议。它在任务性能上比基线高出 18.5%,交互性高出 46.3%,用户满意度提升 17.6%,同时用户耗时减少 10.4%。
核心贡献
-
论文提出 COLLABLLM,一种训练框架,通过协作模拟和跨轮次感知奖励估计每个响应的长期贡献,然后基于这些奖励进行强化微调。这使得模型能够主动挖掘用户意图并提供建议,通过前向采样显式建模响应在任务成功上的因果影响。
-
设计了包含三个具有挑战性任务的跨轮次交互基准,包括文档创作,用于评估长期的人机协作。它覆盖了用户输入高度多样且用户审阅冗长输出的能力有限的开放场景。
-
COLLABLLM 在任务性能上比基线高出 18.5%,在由大语言模型评判的交互性上提升 46.3%。一项包含 201 名评估者的用户研究报告显示,用户满意度提升 17.6%,时间投入减少 10.4%。
引言
现代大语言模型能生成高质量的单轮响应,但真实用户往往从模糊或不完整的意图出发,通过迭代修正来完善需求。这种动态过程增加了挫败感,降低了对话效率,并使完成复杂、开放式任务更加困难。因此,一个开放问题是如何训练模型主动引导用户澄清和完善意图,而不是被动地逐轮回答。
现有的微调技术(如基于人类反馈的强化学习 RLHF)的一个重要局限是,它们奖励的是即时、单轮的响应。这让模型几乎没有动力去寻求澄清或帮助用户精炼偏好,因此部署后的 LLM 倾向于直接回答,即使在追问能够改善任务结果和满意度时也不愿意追问。
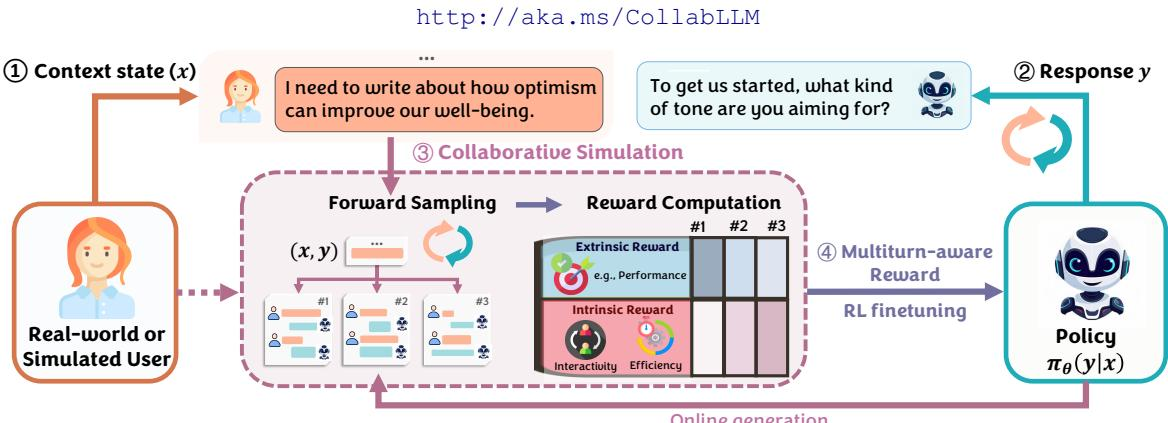
作者提出了 COLLABLLM,一个通用的训练框架,用于提升多轮场景下的 LLM 协作能力。其核心创新是通过协作模拟模块促进前瞻性行为,该模块采样未来对话以估计每个响应的长期影响,并量化为跨轮次感知奖励(MR)。MR 将外部指标(如任务特定成功)与内部指标(如效率)相结合。通过在 MR 上进行强化学习微调,COLLABLLM 学习到能在后续对话阶段带来更好任务完成度和效率的响应。作者还发布了三个具有挑战性的多轮基准:MediumDocEdit-Chat、BigCodeBench-Chat 和 MATH-Chat,覆盖文档创作、代码生成和多轮问答。在这些测试中,COLLABLLM 在强基线上平均将任务准确性提升 18.5%,交互性提升 46.3%,并能泛化到未见过的数据领域。在包含 201 名 Amazon Mechanical Turk 参与者的大规模用户研究中,它使用户满意度提升 17.6%,平均节省用户时间 10.4%。
数据集
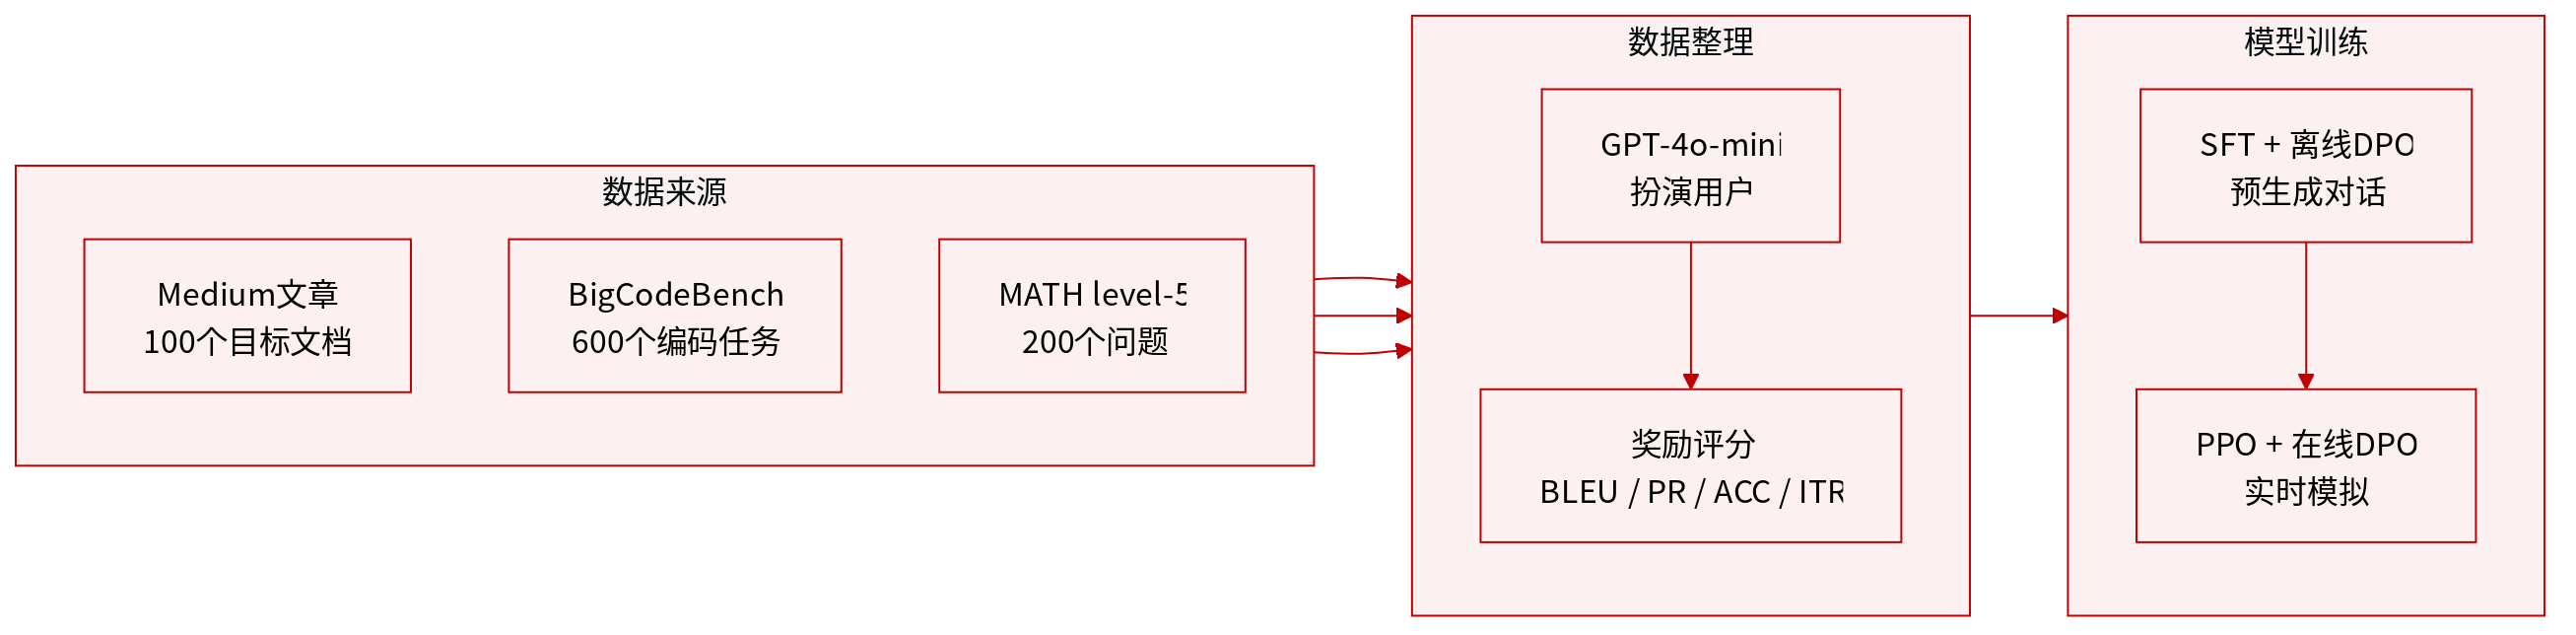
作者构建了三个多轮数据集用于微调和评估,使用大语言模型模拟逼真的用户行为。所有数据集都设计用于动态、目标导向的交互,而非单一的提示-响应交换。
- 多轮环境: 为创建该环境,作者使用 GPT-4o-mini 作为用户模拟器 LLM。模拟器根据目标问题和对话历史模拟逼真的用户行为,使交互能够紧密模拟真实场景。
- 子集构成:
- MediumDocEdit-Chat: 包含 100 篇从 Medium 采样的文章作为目标文档。这些文章被总结成目标问题以指导用户模拟器。任务性能通过 BLEU 分数衡量,比较提取出的文档与原始文章。
- BigCodeBench-Chat: 包含从 BigCodeBench 采样的 600 个编程问题,直接作为目标问题提供。任务成功通过交互结束时代码的平均通过率(PR)衡量。
- MATH-Chat: 包含 MATH 数据集中 200 个难度为 5 的数学问题,用于提示用户模拟器。最终解答的准确性(ACC)由 LLM 评判,决定任务是否成功。
- 通用评估指标: 除任务特定指标外,所有数据集使用两个与任务无关的分数。平均 token 计数量化每次对话生成的 token 数量,以反映效率。交互性(ITR)衡量用户参与度,由 LLM 评判者评分,并重新缩放为最大值为 1。
- 微调中的用途: 作者基于 Llama-3.1-8B 使用 LoRA 微调 LLM,训练了四个模型变体:
- 离线模型: 通过在预生成的对话数据集上进行 SFT 和 Offline DPO 训练,这些数据集由跨轮次感知奖励(MR)引导。
- 在线模型: 从 SFT 和 Offline DPO 模型出发,通过 PPO 和 Online DPO 训练。在此阶段,模型参与模拟以计算 MR,从而动态调整其偏好。
- 基线: 作者将模型与预训练的 Llama-3.1-8B 基础模型以及“主动基础”变体进行比较,后者通过提示工程鼓励追问和澄清问题。
方法
作者引入了一个统一的协作式 LLM 训练框架,旨在优化长期对话目标,而非即时单轮奖励。参考框架示意图。
该方法的核心是跨轮次感知奖励(MR),它通过估计响应对整个对话轨迹的影响来评估响应。形式上,在轮次 j 的表征 mj 的 MR,给定对话历史 tjh 和目标 g,定义为:
MR(mj∣tjh,g)=Etjf∼P(tj+1:K∣tjh∪{mj})R∗(tjh∪{mj}∪tjf∣g)其中,tjf 表示当前轮次之后的未来轮次轨迹,R∗ 是对话级奖励函数。为了计算这个期望值,框架使用协作模拟模块来前向采样可能的未来对话。该采样由用户模拟器 U 促进,它基于对话历史生成概率性的用户响应,有效模拟逼真的用户行为和不断变化的需求。为保持计算效率,模拟受限于窗口大小 w,限制所考虑的前向轮次数。
对话级奖励函数 R∗ 近似为外部和内部指标的组合:
R∗(t∣g)≃Rext(t,g)+Rint(t)外部奖励 Rext(t,g) 通过将对话中的最终解决方案与参考解决方案 yg 进行比较来衡量任务成功。内部奖励 Rint(t) 优先考虑用户体验,定义为:
Rint(t)=−min[λ⋅TokenCount(t),1]+RLLM(t)该公式惩罚过多的 token 使用以鼓励效率,同时基于 LLM 的评判者评估参与度和交互性。
通过优化更高的 MR 分数,模型学习生成能提升整体有效性和效率的响应。该框架支持 PPO 和 DPO 等强化学习方法用于在线微调。此外,MR 指标有助于生成高质量合成数据集。对于监督微调,系统迭代选择排名靠前的响应以构建真实的对话历史。对于直接偏好优化,它通过按轮次对响应进行排名来构建成对比较,根据 MR 分数区分选中的和拒绝的对。
实验
实验评估了从 Llama-3.1-8B 使用跨轮次感知奖励微调的 COLLABLLM,在文档编辑、编程和数学任务的模拟多轮环境,以及包含人类参与者的真实世界用户研究。结果显示,仅靠提示工程改进有限,而 COLLABLLM 通过澄清意图并动态适应用户需求,提升了任务性能、交互效率和用户参与度。消融实验证实,奖励中的前向采样比即时奖励更能捕捉长期对话影响;泛化测试表明协作行为能迁移到新的问答领域。真实用户评分始终倾向 COLLABLLM 在文档质量、持续参与和减少任务耗时上的表现,但用户也指出在个性化和创造力方面仍有改进空间。
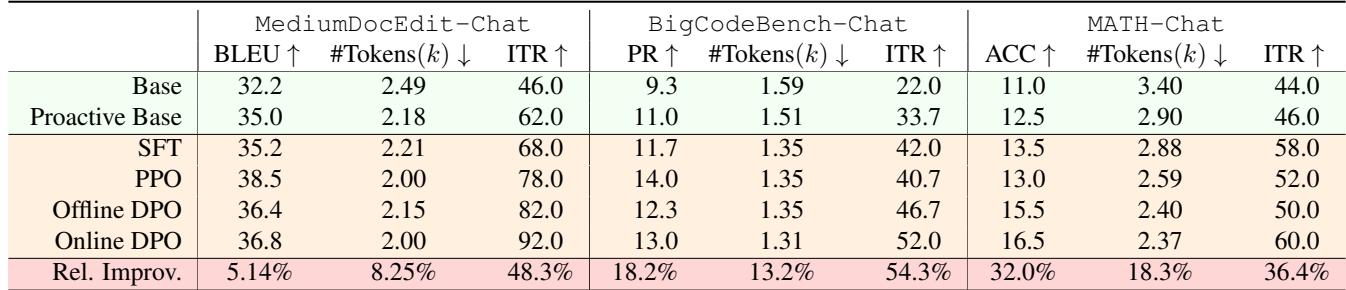
评估显示,提示工程带来有限改进,而 COLLABLLM 变体,尤其是 Online DPO,在所有多轮数据集上显著提升了任务性能、效率和交互性。与基础模型相比,Online DPO 持续减少 token 使用并提升交互评分,尽管 PPO 和 Offline DPO 在特定指标上也有改进。Proactive Base 在所有数据集上优于 Base,但与训练过的 COLLABLLM 变体相比提升有限。Online DPO 在三个数据集上获得最高的交互评分,在 MediumDocEdit-Chat 和 MATH-Chat 上 ITR 显著提升。COLLABLLM 变体相对 Base 减少了对话 token,Online DPO 在 token 计数上降幅最大。SFT 和 PPO 在大多数指标上也优于 Proactive Base,但 Online DPO 往往在任务准确性和参与度之间提供最佳平衡。提示工程仍然僵化,可能导致不必要的澄清问题,而训练模型能更动态地适应。
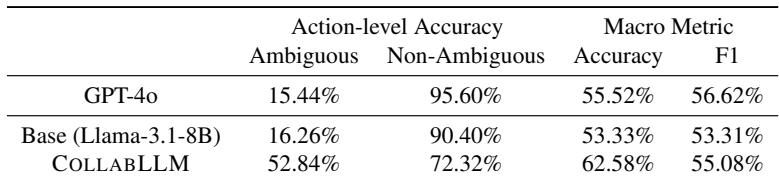
使用在线 DPO 在编程辅助任务上训练的 COLLABLLM,在对话式问答上表现出强大的零样本泛化能力:它对大约一半的模糊输入提出澄清问题,同时仍能准确回答非模糊输入。它在两种输入类型上取得最高的宏平均准确率,并相对基础模型提升了宏 F1,但 F1 仍落后于 GPT-4o。COLLABLLM 对模糊输入提出澄清问题的比例远高于 GPT-4o 或基础模型,后者很少这样做。COLLABLLM 在非模糊输入上保持高准确率,虽略低于基线,但整体宏平均准确率最优。其宏 F1 优于基础模型,但仍略低于 GPT-4o,表明仍有进一步优化空间。
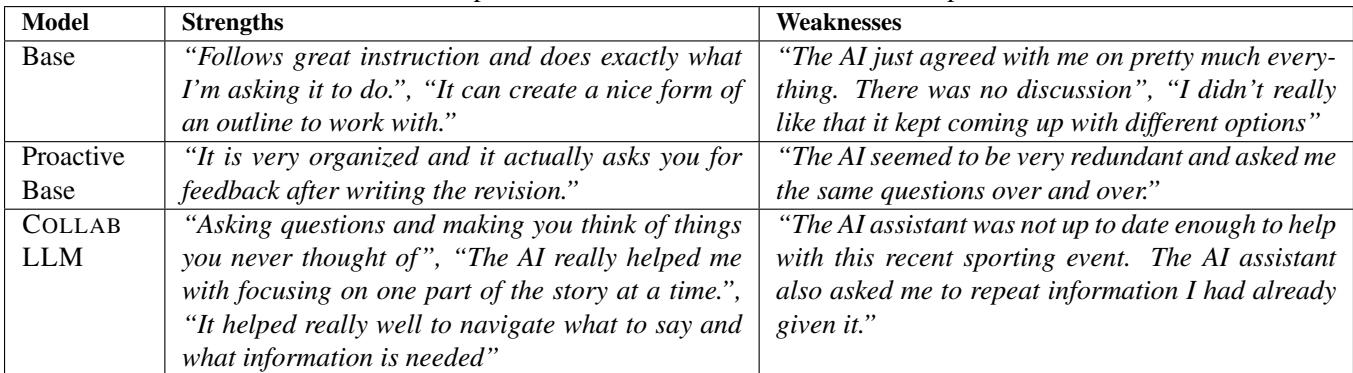
在包含 201 名参与者的真实用户研究中,COLLABLLM 在文档质量、用户参与度和任务效率方面持续优于基线模型。定性反馈突出 COLLABLLM 引导用户进行交互式改进的能力,而基线模型常出现过度同意或重复提问等问题。COLLABLLM 获得更高的文档质量评分,且“非常好”评分的占比大于 Base 模型。用户对 Base 模型的参与度在较长的对话中下降,而 COLLABLLM 能在各轮次中维持并提升参与度。与 Baseline 和倾向于问冗余问题的 Proactive Base 相比,COLLABLLM 减少了任务完成时间。参与者称赞 COLLABLLM 能促使他们深入思考并帮助集中注意力,但也指出了信息过时、重复请求已提供细节等局限。
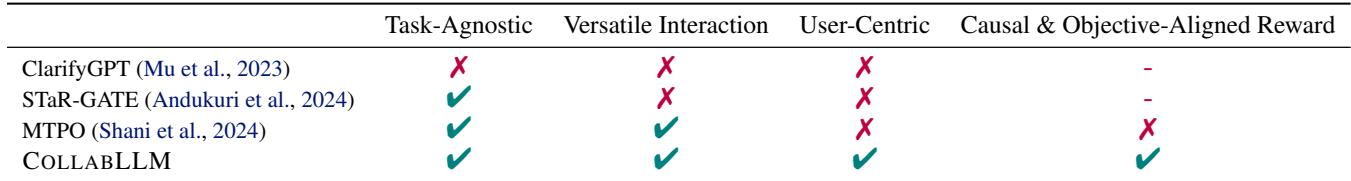
COLLABLLM 独特地满足了所有四个评估维度,包括因果且目标对齐的奖励估计,而其他方法至少缺少一个。在用户研究中,COLLABLLM 在文档质量、参与度和效率上持续优于基线,且在较长对话中保持用户满意度上升,而基线则下降。COLLABLLM 是唯一一个与任务无关、交互方式多样、以用户为中心、并使用因果且目标对齐奖励的方法。COLLABLLM 在文档质量和参与度评分上高于基础基线和主动基线。COLLABLLM 在各交互轮次中维持或提升用户评分,而基础模型在较长会话中评分下降。COLLABLLM 相对基础模型减少超过 10% 的交互时间,相较于会问不必要问题的主动基线,节省的时间更多。
评估涵盖多轮交互数据集、零样本对话式问答任务以及包含 201 名参与者的用户研究。结果表明,提示工程带来有限改进,而 COLLABLLM 变体,尤其是 Online DPO,显著提升了任务性能、效率和交互性,减少 token 使用并提升交互评分。COLLABLLM 还展现出强大的零样本泛化能力,能对模糊输入提出澄清问题,同时在非模糊输入上保持高准确率。在用户研究中,COLLABLLM 在文档质量、参与度和效率上持续优于基线,在较长对话中保持用户满意度并减少任务完成时间。