Command Palette
Search for a command to run...
ToMA:面向扩散模型的注意力令牌合并方法
ToMA:面向扩散模型的注意力令牌合并方法
Wenbo Lu Shaoyi Zheng Yuxuan Xia Shengjie Wang
摘要
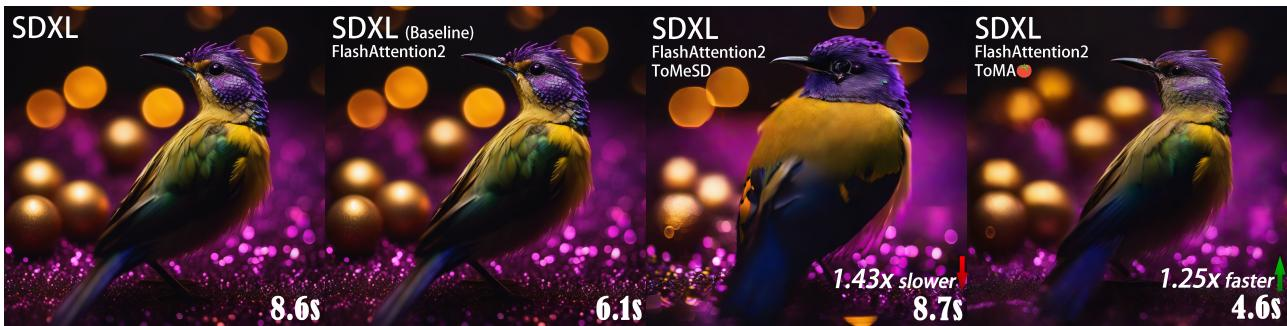
扩散模型在高保真图像生成方面表现出色,但由于Transformer的二次方注意力复杂度,其可扩展性受到限制。即插即用的令牌减少方法(如ToMeSD和ToFu)通过合并生成图像中的冗余令牌来减少FLOPs,但依赖GPU低效操作(如排序、分散写入),这些操作引入了额外开销,在与优化注意力实现(如FlashAttention)搭配时抵消了理论加速。为弥合这一差距,我们提出ToMA(Token Merge with Attention),一种即插即用方法,重新设计令牌减少以实现GPU对齐效率,包含三个关键贡献:1)将令牌合并重新表述为子模优化问题以选择多样化令牌;2)通过GPU友好的矩阵运算,将合并/拆分视为类似注意力的线性变换;3)利用潜在局部性和序列冗余(模式重用)以最小化开销。ToMA将SDXL/Flux生成延迟降低24%/23%(DINO Δ < 0.07),优于先前方法。本研究弥合了扩散模型中Transformer的理论与实际效率之间的差距。
一句话总结
来自多个机构的研究者提出了 ToMA,一种即用的扩散模型 token 缩减方法。该方法将 token 合并重新表述为子模优化问题,通过 GPU 友好的类注意力矩阵运算实现合并与恢复,并利用潜空间局部性和模式复用,在 SDXL 和 Flux 上分别实现 24% 和 23% 的延迟降低(DINO Δ<0.07),优于 ToMeSD 和 ToFu 等既有方法。
核心贡献
-
ToMA 作为一种免训练的 token 缩减方法被提出,将 token 合并重构为子模优化问题,为选择多样且具代表性的 token 以保持生成质量提供了可证明的保证。
-
该方法将合并与恢复操作重新设计为类注意力的线性变换,通过 GPU 友好的矩阵运算实现,规避了既有方法中的排序和散射写入开销,并能与 FlashAttention 等优化注意力实现无缝集成。
-
ToMA 利用潜空间局部性和跨去噪步骤的时间模式复用来最小化运行时开销。实验表明,它在 DINO Δ 低于 0.07 的情况下分别将 SDXL 和 Flux 的生成延迟降低 24% 和 23%,在不同模型和 GPU 架构上与 FlashAttention2 搭配时实现至少 1.24 倍的实际加速。
引言
扩散模型能够生成高保真图像,但其基于 Transformer 的主干网络(如 U-ViT 和 DiT)因自注意力的二次复杂度而面临可扩展性瓶颈。先前的 token 缩减技术(ToMeSD、ToFu)将合并方法适配到生成任务中,但它们依赖排序和散射写入等 GPU 低效原语。当与快速注意力实现搭配时,这些操作成为主要开销,仅能带来微小的加速。为解决这一问题,作者提出了 Token Merge with Attention (ToMA),一个免训练框架,将 token 合并重新思考为子模优化问题。ToMA 使用 GPU 优化的设施选址算法来选择代表性的目标 token,通过类注意力的线性变换执行合并与恢复,并利用潜空间局部性和序列冗余来分摊开销,从而在实际端到端加速(1.24 倍或更多)的同时实现可忽略的质量损失。
方法
作者提出 ToMA,一个旨在通过优化 token 合并过程来加速扩散模型的轻量级框架。标准 token 合并通过聚合相似 token 来降低计算负载,而 ToMA 在三个关键阶段改进这一流程:目标 token 选择、合并操作本身以及随后的恢复步骤。
为选择最具代表性的 token 作为合并目标,作者采用子模优化方法。具体来说,他们使用设施选址(FL)函数来量化目标 token 子集对整个 token 集的代表性。目标是最大化每个 token 与所选目标之间最大相似度之和。这通过贪心算法求解,该算法迭代选择提供最大边际增益的 token。为确保 GPU 上的高效性,边际增益计算使用缓存向量进行优化,从而可以通过矩阵运算并行执行。
选定目标 token 后,合并操作被表述为由注意力分数引导的线性投影。作者将目标 token 视为查询,将所有输入 token 视为键和值,采用缩放点积注意力(SDPA)机制。通过按列应用 softmax 并按行归一化所得注意力矩阵,得到合并权重矩阵 A~。合并后的 token 表示计算为 Xmerged=A~X。
在合并后的 token 通过核心 Transformer 模块(如 Attention 或 MLP 层)之后,需要将其恢复到原始分辨率。作者使用权重矩阵的转置 A~⊤ 来近似合并投影的逆。由于低注意力温度和目标准备集合的互不重叠特性使 A~ 的各个行近似正交归一,Moore-Penrose 伪逆可以简化为简单的转置操作。
为进一步提升效率,该框架利用潜空间固有的空间局部性。 如下图所示,U-ViT 模型中的隐藏状态表现出强局部一致性,小空间窗口内的 token 共享相似特征。
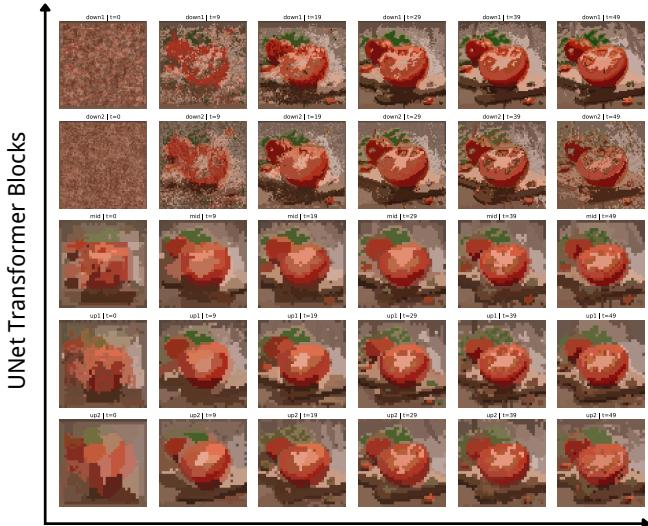
由于自然图像具有局部一致性,在受限空间区域内合并 token 与全局合并效果相当,同时显著降低计算开销。作者实现了两种分区策略来利用这一特性:块状区域保留二维邻近性以获得更高保真度,条状区域按行分组 token 以保持内存连续性并最大化速度。
最后,该方法通过跨时间和层复用计算来减少开销。 下面的分析表明,在一个去噪步骤中选择的目标 token 对后续步骤仍然高度相关。
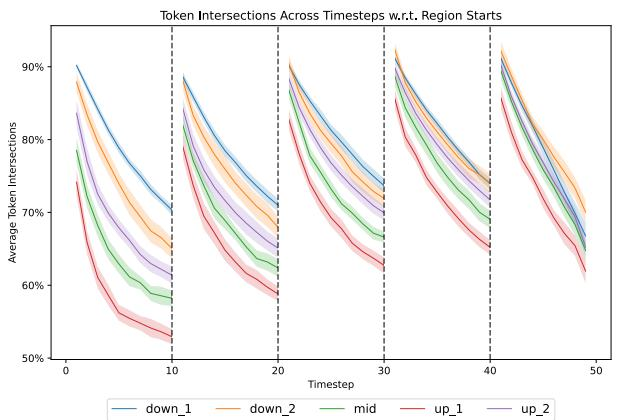
由于扩散模型的隐藏状态变化缓慢,连续时间步之间的目标集合和相应合并权重具有高度重叠。ToMA 利用这一冗余性,在连续多个步骤中复用同一目标集合,并在各 Transformer 层之间共享合并与恢复矩阵。这一策略大幅降低了昂贵的相似度计算频率,且不损害图像质量。
实验
ToMA 在基于 UNet 的 SDXL 和基于 DiT 的 Flux.1-dev 上进行了评估,图像尺寸为 1024x1024,将其 tile、stripe 和 once 变体与启发式基线(ToMe、ToDo、ToFu)进行比较,使用 CLIP-T、DINO 和 FID 指标。该方法在保持感知质量的同时持续实现高达 28.5% 的加速,其中 tile 变体提供最佳保真度但运行时较慢,once 变体最快但质量最差。基线方法存在高延迟、输出不稳定或分布偏移问题,而定性结果表明即使在 75% token 合并率下,ToMA 的输出与原始输出几乎无法区分。消融实验确认了诸如基于 tile 的合并和转置恢复等设计选择能够实现最优的速度与质量权衡。
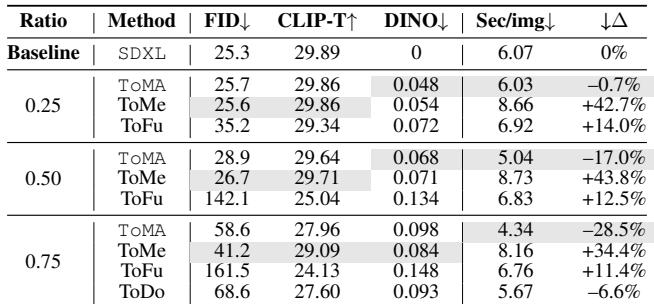
ToMA 变体在保持竞争力图像质量的同时实现比 SDXL 基线更快的生成。在各变体中,ToMA 提供了速度与质量的最佳平衡,而基于 tile 的合并提供更高保真度但因内存开销导致运行较慢。基于 stripe 的合并更快但在保持视觉质量方面稍逊。基于 tile 的合并实现最强的感知对齐,但因内存复制开销使其变慢。基于 stripe 的合并受益于更快的内存访问模式,但图像质量略有下降。ToMA 在不同 GPU 架构上提供高达 24% 的加速,同时保持一致的性能。与其他 token 缩减方法相比,ToMA 在保持竞争力感知质量的同时速度最快。
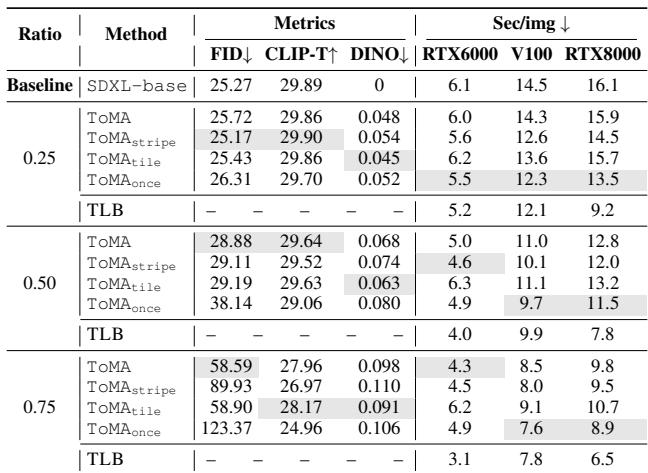
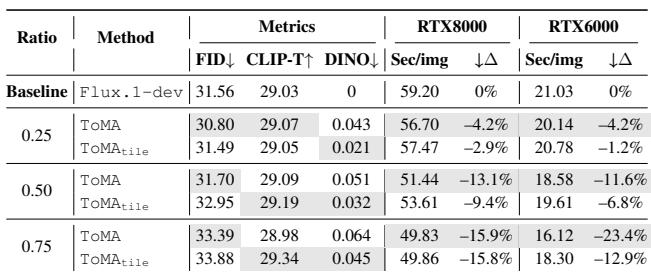
ToMA 变体加速 Flux.1-dev 图像生成,同时保持或提升质量。默认 ToMA 实现显著加速,尤其在更高的 token 缩减比例下,而基于 tile 的变体提供更好的感知保真度但因内存复制开销运行较慢。这种权衡支持 ToMA 作为默认选择。ToMA 在 RTX6000 上以 75% token 合并率实现约 23% 的推理加速,质量影响极小。ToMA tile 持续取得更强的 CLIP-T 和 DINO 分数但较慢,尤其是在较低合并比率下。在 25% token 合并时,两种变体加速约 4% 或更少,ToMA 显示轻微的 FID 改善。
ToMA 在 SDXL 上实现了所有对比 token 缩减方法中最快的生成时间,速度提升高达 28.5%,同时保持竞争力感知质量。ToMe 提供略好的图像质量但因 GPU 低效操作遭受严重延迟,而 ToFu 在更高缩减比率下表现出不稳定的视觉质量和高 FID。总体而言,ToMA 在效率与质量之间取得最佳平衡,是推荐的默认方法。ToMA 实现最大加速(最高 28.5%),同时保持 FID 和 CLIP-T 分数接近基线和 ToMe。ToMe 的 CLIP-T 和 DINO 分数略优,但因基于排序的 token 选择导致超过 40% 的减速。ToFu 在更高缩减比率下表现出不稳定的视觉质量,FID 急剧上升(例如 50% 比率时为 142.1)。在 25% 和 50% token 缩减下,ToMA 在所有指标上持续优于 ToFu,并且比基线更快。ToMA 的速度优势随缩减比率提高而增长,在 50% 合并时实现 -17.0% 的时间,同时保持竞争力质量。
ToMA 在 SDXL 和 Flux.1-dev 上持续实现 token 缩减方法中最快的推理,在更高合并比率下加速高达 28.5%,同时保持竞争力感知质量。其基于 tile 的变体提升保真度但因内存复制开销使其变慢,而 stripe 合并更快但略微降低图像质量。与因排序操作而较慢的 ToMe 以及在高速缩减下质量不稳定的 ToFu 相比,ToMA 作为默认选择提供了最佳的速度与质量权衡。