Command Palette
Search for a command to run...
基于扭曲序贯蒙特卡洛的语言模型概率推断
基于扭曲序贯蒙特卡洛的语言模型概率推断
Stephen Zhao Rob Brekelmans Alireza Makhzani Roger Grosse
摘要
大语言模型(LLM)的众多能力与安全相关技术,包括基于人类反馈的强化学习(RLHF)、自动化红队测试、提示工程和文本填充等,均可建模为从由给定奖励函数或势函数(定义在完整序列上)所确定的未归一化目标分布中进行采样的问题。本工作利用序贯蒙特卡洛(SMC)方法的丰富工具箱来应对这些概率推断问题。具体而言,我们使用学习得到的扭曲函数来估计每个时间步的势函数期望未来值,从而将推理时的计算资源集中于有前景的部分序列。我们提出了一种新颖的对比方法来学习扭曲函数,并建立了其与软强化学习丰富文献之间的联系。作为扭曲 SMC 框架的一种补充应用,我们提出了利用对数配分函数的新型双向 SMC 界来评估语言模型推断技术准确性的方法。这些界可用于估计推断分布与目标分布之间双向的 KL 散度。我们将推断评估技术应用于实际场景,结果表明扭曲 SMC 在以下任务中均表现有效:从预训练模型中采样不良输出(这是无害性训练和自动化红队测试的有用组成部分)、生成具有不同情感倾向的评论,以及执行文本填充任务。
一句话总结
Vector Institute 提出用于 LLM 概率推断的 Twisted Sequential Monte Carlo(扭曲序贯蒙特卡洛),采用一种新颖的对比方法学习扭曲函数,使推断时计算聚焦于有前景的部分序列,并提出双向 SMC 界来评估推断准确性,在自动化红队、情感可控生成与 infilling 任务上展示了有效性。
核心贡献
- 该论文将 RLHF、自动化红队、提示工程和 infilling 等能力与安全方法表述为从未归一化目标分布采样,并引入带有已学习扭曲函数的扭曲序贯蒙特卡洛,以把推断时计算聚焦到有前景的部分序列。
- 该论文提出一种学习扭曲函数的对比方法,建立其与软强化学习的联系,并将该方法定位为 best-of-K 解码及相关基于值采样方案的原则性概率扩展。
- 该论文引入关于对数配分函数的双向序贯蒙特卡洛界,用于估计推断分布与目标分布之间的 KL 散度,并展示扭曲 SMC 在采样不理想预训练输出、生成不同情感评论以及 infilling 任务上的应用。
引言
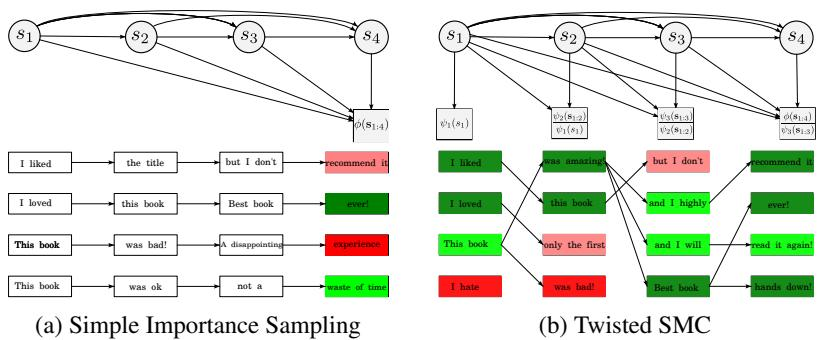
许多语言模型任务(包括 RLHF、红队和推理)都可视为通过给完整序列打分,将生成文本推向指定属性。作者将其表述为概率推断:从一个被势函数调制的基础语言模型中采样,并估计在所有可能响应上不可解的配分函数。以往采样方法存在局限,因为期望的完整序列分布是非因果的,所以逐 token 生成需要未知的未来感知边际分布,而早期 SMC 工作大多使用固定或短范围引导,而不是已学习的扭曲函数。作者利用扭曲序贯蒙特卡洛并学习中间扭曲函数,包括一种对比扭曲学习方法,以引导生成走向有前景的部分序列,并提供配分函数界用于评估推断质量。
方法
作者利用扭曲序贯蒙特卡洛框架,从由预训练基础语言模型和终端评分函数定义的语言分布中采样。设基础自回归模型为序列分配概率 p0(s1:T),设期望的目标分布由终端势函数 ϕ(s1:T) 定义:
σ(s1:T)=Zσ1p0(s1:T)ϕ(s1:T).这里 σ 是推断目标,ϕ 编码最终目标,例如奖励、似然、分类概率或其他终端评分信号,Zσ 是配分函数。核心困难在于,直接从 σ 采样不可解,因为 ϕ 是终端项,而生成逐 token 进行。因此作者引入中间目标分布,利用最终终端目标的信息来引导早期的 token 决策。
该方法使用扭曲函数 ψt(s1:t) 表示中间目标,这些函数调制基础模型,以近似目标分布在时间 t 的真实边际分布。对于 t<T,扭曲中间目标定义为
πt(s1:t)=Ztψ1p0(s1:t)ψt(s1:t),而最终目标保持为
πT(s1:T)=Zσ1p0(s1:T)ϕ(s1:T).扭曲的作用是概括未来势函数如何被纳入当前采样决策。如果扭曲函数是理想的,中间目标将与真实的目标边际分布一致:
πt∗(s1:t)=σ(s1:t).最优扭曲函数满足一个后向边际化条件:
ψt∗(s1:t)∝st+1:T∑p0(st+1:T∣s1:t)ϕ(s1:T),并具有相应的递归
ψt∗(s1:t)∝st+1∑p0(st+1∣s1:t)ψt∗(s1:t+1).该条件表明,最优扭曲函数评估在基础模型生成的未来延续下终端势函数的期望。换言之,ψt(s1:t) 估计一个部分序列最终获得高终端势函数的前景程度。
在每个生成步骤,作者使用 K 个部分生成序列运行序贯蒙特卡洛过程。给定提议分布 q(st∣s1:t−1) 和扭曲中间目标,步骤 t 的增量重要性权重为
wt(s1:t)=q(st∣s1:t−1)p0(st∣s1:t−1)ψt−1(s1:t−1)ψt(s1:t).这些权重修正基础模型、提议分布与扭曲中间目标之间的失配。作者强调两种自然的提议选择。第一种是直接把基础模型用作提议分布:
q=p0.这简单且可处理,但可能需要大量粒子 K 才能很好地近似终端目标,尤其当终端势函数较尖锐或选择性很高时。
第二种选择是扭曲诱导的提议分布。对于给定的一组扭曲中间目标,一步方差最小化的提议分布具有如下形式
qtπ(st∣s1:t−1)∝p0(st∣s1:t−1)ψt(s1:t).等价地,
qtπ(st∣s1:t−1)=Ztπ(s1:t−1)1p0(st∣s1:t−1)ψt(s1:t),其中
Ztπ(s1:t−1)=st∈V∑p0(st∣s1:t−1)ψt(s1:t).对于 t<T,该提议分布在 transformer 架构中可处理,因为归一化对后续 tokens 的离散词表 V 求和。完整序列上的扭曲提议分布为
qπ(s1:T)=(t=1∏T−1qtπ(st∣s1:t−1))qT(sT∣s1:T−1).在最后一步,真实终端势函数 ϕ(s1:T) 可能需要单独的网络,例如奖励模型、分类器或似然评估器。因此作者在提议分布内部使用近似的最终扭曲函数 ψT(s1:T)≈ϕ(s1:T):
qT(sT∣s1:T−1)∝p0(sT∣s1:T−1)ψT(s1:T).使用该提议分布后,t<T 的增量权重变为
wt(s1:t)=ψt−1(s1:t−1)∑stp0(st∣s1:t−1)ψt(s1:t),而在最后一步,
wT(s1:T)=ψT−1(s1:T−1)∑sTp0(sT∣s1:T−1)ψT(s1:T)ψT(s1:T)ϕ(s1:T).关键的实际优势在于,被提议的后续 tokens 已经偏向扭曲函数认为会获得高终端势函数的延续。最终权重随后修正近似扭曲函数与真实势函数之间的剩余差距。
作者还将该表述与条件推断联系起来。如果目标是通过以观测变量 oT 为条件得到的后验,则目标为
σ(s1:T∣oT)=Zσ(oT)1p0(s1:T)σ(oT∣s1:T).在这种情况下,最优扭曲函数具有直接的概率含义:
ψt∗(s1:t,oT)=σ(oT∣s1:t).因此,在条件生成任务中,扭曲函数学习一个部分序列仍可能导向观测目标结果的概率。通过将二值观测视为势函数,可以恢复无条件的终端势函数设定。该视角还通过从联合分布进行祖先采样并以模拟观测为条件,支持在模拟设定中的精确后验采样。
作者还从强化学习角度解释扭曲函数。当终端势函数写成指数化奖励时,
ϕ(s1:T)=eβr(s1:T),扭曲函数对应一个指数化软价值函数:
ψt(s1:t)≈eβQ(s1:t).从这个视角看,扭曲函数像评估部分序列价值的评论家,而提议分布像生成 token 延续的演员。最优扭曲递归对应类软贝尔曼方程,即使奖励仅出现在终端步骤。
扭曲函数的主要训练方法是对比扭曲学习。作者通过最小化期望目标边际与扭曲中间边际之间的平均 KL 散度,训练参数化扭曲函数族 ψtθ:
LCTL(θ)=t=1∑TDKL(σ(s1:t)πtθ(s1:t)).该目标的梯度具有对比结构:
∇θLCTL(θ)∝Eπtθ(s1:t)[∇θlogψtθ(s1:t)]−Eσ(s1:t)[∇θlogψtθ(s1:t)].梯度的负部鼓励扭曲函数在当前扭曲分布 πtθ 下提高得分。梯度的正部鼓励扭曲函数在更能代表真实目标边际 σ(s1:t) 的部分序列上提高得分。这类似对比学习或基于能量的模型训练,其中正样本把能量压低,负样本把模型分布推向真实但较少与目标对齐的示例。
对于负样本采样,作者使用序贯重要性采样或序贯蒙特卡洛近似 πtθ 下的期望。可以从基础模型 p0 或扭曲诱导提议分布 qπ 等提议分布中采样,然后使用未归一化中间目标权重对生成的部分序列重新加权。在完整 SMC 流程中,在 K 个粒子上重采样能提供负样本的较低方差近似。
对于正样本采样,该方法依赖从真实目标边际中抽取的或经加权近似真实目标边际的部分序列。当已有精确目标样本时,例如从可处理联合观测模型进行祖先采样得到,可直接使用精确后验样本。作者描述将完整精确序列截断为长度 t 的前缀,因为该前缀对应从边际 σ(s1:t) 抽取的样本。这为步骤 t 的扭曲梯度提供一个干净的为正样本。
当无法获得精确样本时,作者使用近似正样本采样。作者使用 K 个粒子运行 SMC 或 SIS,但关键在于使用真实终端势函数 ϕ(s1:T) 对这些粒子加权,而不仅使用已学习的扭曲函数。得到的权重近似序列上的目标边际分布。随后,同一组粒子和权重可用于估计不同时间步的正梯度贡献。当已知提议分布与目标分布似然比的某个上界时,拒绝采样也可提供精确正样本。
训练流程可概括为围绕生成步骤的循环。作者抽取或近似能反映真实目标边际的正部分序列。作者还从当前提议分布抽取负部分序列,并在当前扭曲中间目标下对其进行重新加权。扭曲网络被更新,以给正部分序列分配更高分,给负部分序列分配更低分。随着时间推移,中间扭曲目标逐步接近最终目标分布的真实边际。
作者还提供评估该推断过程质量的工具。一个核心量是对数配分函数 logZσ,因为它出现在 KL 散度估计和基于似然的诊断中。作者利用 SMC 的扩展状态视图推导 logZσ 的双向随机界。设 S 表示粒子、tokens、权重和重采样索引的完整扩展状态。下界为
EqSMC(S)[logt=1∏T(K1i=1∑Kwt(s1:ti))],上界为
EσSMC(S)[logt=1∏T(K1i=1∑Kwt(s1:ti))].这些界满足
EqSMC(S)[logt=1∏TK1i=1∑Kwt(s1:ti)]≤logZσ≤EσSMC(S)[logt=1∏TK1i=1∑Kwt(s1:ti)].下界对应于从提议分布采样扩展 SMC 系统。上界需要在扩展状态空间中从相应目标采样。当至少有一个精确目标样本可用时,这可以做到。在扩展 SMC 过程中,精确目标样本受到保护,使其部分序列留在粒子集中。其余粒子遵循通常的提议与重采样动态。随着 K 增大,这些界变得精确,从而允许作者将 logZσ 夹住,并评估 SMC 过程接近真实目标分布的程度。
实验
实验通过比较上界与下界对数配分界,以及提议样本与目标分布之间的 KL 散度,评估该框架在有害故事生成、情感评论生成和 infilling 中的表现。结果显示,与标准重要性采样相比,扭曲 SMC 可显著提升稀有事件的采样效率和估计质量,同时也可作为评估其他推断方法的工具。结果表明,提议质量取决于训练目标和样本可得性;在近似正样本采样下 CTL 表现最好,而在有精确目标样本时 DPG 表现最好。
在条件 infilling 设定中,DPG 在两个 KL 方向上都取得最佳期望散度分数,这得益于其可访问精确目标样本。对比学习表现有竞争力,但不如 DPG 稳定,且接近 SIXO,而 FUDGE 和 RL 在所评估的散度上较不有利。PPO 在目标到提议方向较弱,因为它仅从提议样本进行训练。在 infilling 中,DPG 在提议到目标和目标到提议 KL 散度上均最强。当衡量提议分布对后验的覆盖程度时,PPO 表现相对较差。
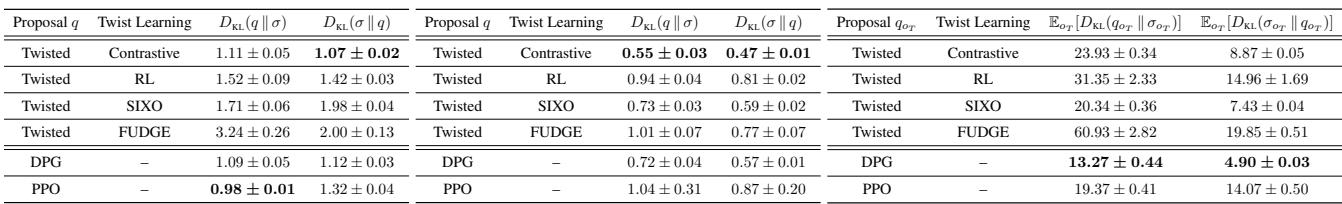
在条件 infilling 设定中,沿两个 KL 方向评估散度分数,以衡量每种方法将提议分布与目标样本和后验样本对齐的程度。DPG 借助精确目标样本的可访问性,在两个方向上均取得最强表现,而对比学习仍有竞争力,但不如 DPG 稳定。FUDGE 和 RL 整体较不有利,PPO 较弱,尤其当评估强调后验覆盖时。