Command Palette
Search for a command to run...
Genie:生成式交互环境
Genie:生成式交互环境
摘要
我们提出了 Genie,这是首个以无监督方式从未标注的网络视频中训练得到的生成式交互环境。该模型能够根据文本、合成图像、照片乃至草图的提示,生成动作可控、变化无穷的虚拟世界。Genie 拥有 11B 参数,可被视为一个基础世界模型。它由时空视频分词器、自回归动力学模型以及一个简洁且可扩展的潜在动作模型组成。尽管训练过程中未使用任何真实动作标签,也未涉及世界模型文献中常见的领域特定要求,Genie 仍使用户能够以逐帧的方式在生成的环境中进行交互操作。此外,所学习到的潜在动作空间有助于训练智能体从未见过的视频中模仿行为,为未来训练通用智能体开辟了道路。
一句话总结
该论文提出 Genie,它是一个 11B 参数的基础世界模型,包含时空视频 tokenizer、自回归动态模型和潜在动作模型,能够从互联网的无标注视频生成动作可控的交互环境,实现逐帧交互,并在没有真实动作标签的情况下从未见过的视频进行模仿学习。
核心贡献
- Genie 是一个 11B 参数的生成式交互环境,利用时空视频 tokenizer、自回归动态模型和可扩展的潜在动作模型,从未标注互联网视频训练,并从文本、合成图像、照片或草图生成动作可控的虚拟世界。
- 潜在动作学习机制能够在没有真实动作标签的情况下逐帧控制生成环境,扩展了依赖标注数据或特定领域假设的先前视频模型和可玩视频生成方法。
- 学习到的潜在动作空间支持从未见过的视频模仿行为,并支持仅视频的环境生成,为无需昂贵动作标注来训练通用 agent 提供了一条路径。
引言
生成式 AI 在语言和图像生成方面快速发展,视频模型也在改进,但许多系统仍产生被动媒体而非交互体验。这一差距很重要,因为交互环境可支持创作工具、游戏、仿真、机器人和大规模 agent 训练。先前方法受到限制:世界模型通常需要受控环境中收集的动作标签或文本标注,视频生成模型通常缺乏显式动作控制,可玩视频生成或程序化内容方法往往局限于狭窄领域、静态场景或领域特定知识。论文提出 Genie,这是一个作为基础世界模型构建的生成式交互环境。其利用超过 200,000 小时没有动作或文本标注的互联网游戏视频,从视频学习潜在动作空间,并使用带有视频 tokenizer、因果动作模型和 MaskGIT 动态模型的时空 transformer。该模型扩展到 11B 参数,并能从文本或图像提示生成可玩世界,并在玩法、机器人视频和强化学习推理方面进行演示。
数据集
-
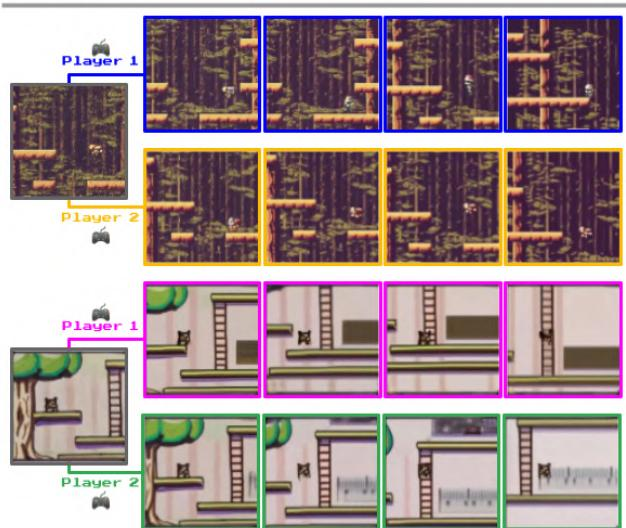
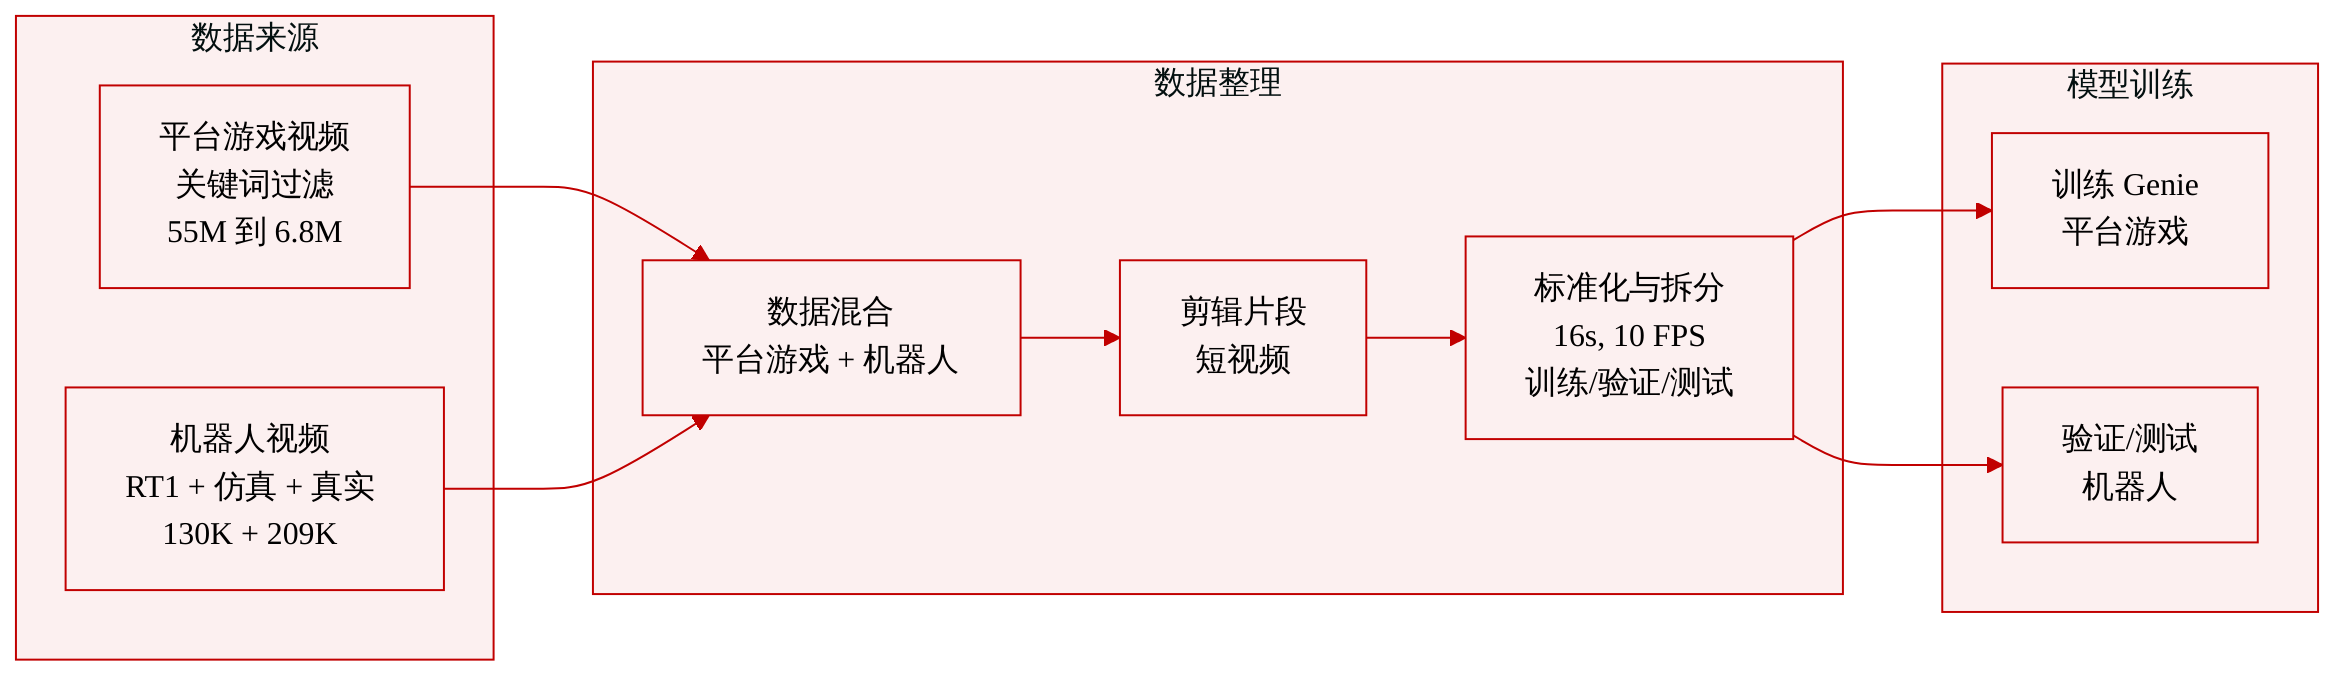
论文主要基于 “Platformers” 数据集训练 Genie,该数据集构建自公开可用的 2D 平台游戏互联网视频。
-
Platformers 构造:
- 来源:公开互联网视频。
- 过滤规则:使用与平台游戏相关的关键词选择视频。
- 初始过滤集合:55M 个 16 秒片段,帧率 10 FPS,分辨率 160 x 90。
- 最终 Platformers 集合:6.8M 个 16 秒片段,总计约 30,000 小时。
- 规模:与其他大规模互联网视频数据集处于同一数量级。
- 默认使用:除非另有说明,报告结果使用在该 Platformers 集合上训练的 11B 参数模型。
-
为了测试通用性,还在 “Robotics” 数据集上评估:
- 来源:用于训练 RT1 的机器人数据集、一个单独的仿真数据集,以及先前工作提供的 209K 个真实机器人 episode。
- 组成:约 130K 个 RT1 机器人示范,加上额外的仿真和真实机器人数据。
- 过滤与使用规则:不使用机器人动作;所有序列都纯粹作为视频处理。
- 提供的文本未描述具体分辨率、片段长度或混合比例。
-
数据集处理与使用细节:
- 片段统一标准化为 10 FPS。
- 建模使用 16 帧序列。
- 视频 tokenizer 训练为将帧重构为离散潜在 tokens,但提供的文本未描述特殊裁剪策略。
- 除关键词过滤和转换为短视频片段外,未描述显式元数据模式或额外标注。
- Platformers 数据集用于主要训练和评估结果,而 Robotics 数据集用于跨领域验证。
方法
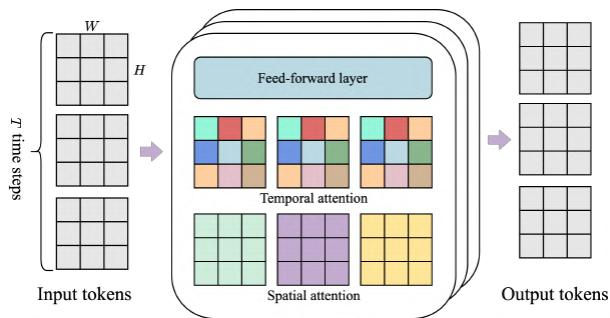
Genie 是一种仅从视频训练而不使用显式动作标签的生成式交互环境。其架构在所有主要组件中均使用内存高效的 ST-transformer 主干,从而能够在控制计算成本的同时处理长视频序列。不同于每个 token 都关注所有其他 token 的标准 transformer,ST-transformer 在每个时空块内交错空间注意力和时间注意力。空间注意力在单帧的 H×W 视觉 tokens 上运行,而时间注意力则在 T 帧的相同空间位置运行,并应用因果掩码。论文还省略空间注意力之后的前馈层,只在时间组件之后保留一个前馈层,从而改善模型容量与扩展之间的权衡。参阅下方架构图。
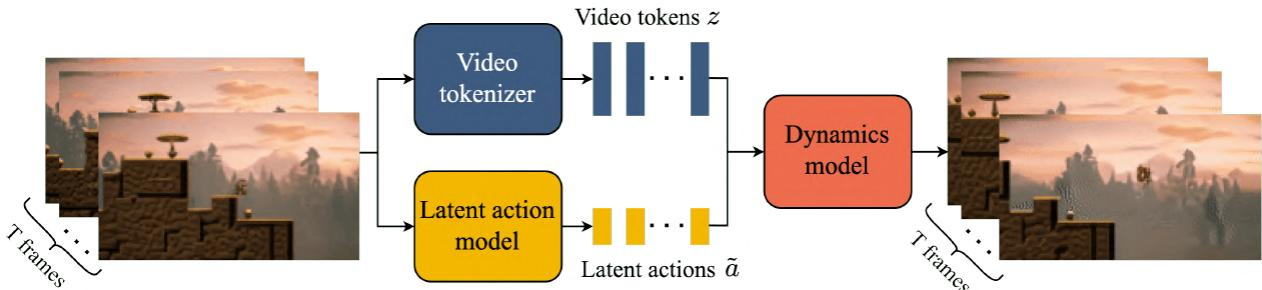
完整模型围绕三个模块构建:潜在动作模型、视频 tokenizer 和动态模型。在训练期间,T 个输入帧首先由视频 tokenizer 编码为 tokens,潜在动作模型推断用于解释帧过渡的潜在动作。随后,动态模型消费这些 tokens 和潜在动作,以迭代方式预测未来帧内容。系统采用两阶段训练策略:先训练视频 tokenizer,随后共同训练潜在动作模型和动态模型。潜在动作模型直接从像素训练,而动态模型在 tokenizer 生成的离散视频 tokens 上运行。如下方框架图所示:
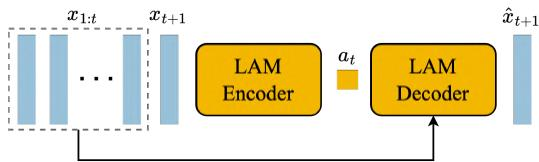
潜在动作模型以完全无监督的方式学习可控信号。其编码器接收所有先前帧和下一帧,然后为每次过渡输出一个连续潜在动作。一个轻量级解码器接收过去帧和推断出的潜在动作,并尝试预测下一帧。训练目标基于 VQ-VAE 公式,将连续潜在动作量化到一个较小码本。这个有界动作词表很重要,因为它支持人类可玩性和可控性;在实验中,码本大小为 ∣A∣=8。由于解码器只能利用历史和潜在动作重构未来帧,每个 a~t 被鼓励捕捉过去与未来之间最有意义的变化。ST-transformer 的因果时间结构也使模型能够处理完整序列 x1:T,并为所有帧对生成潜在动作。在推理时,潜在动作模型的大部分被丢弃,而码本仍然用于映射用户选择的离散动作。下方图展示了潜在动作模型的无监督训练机制:
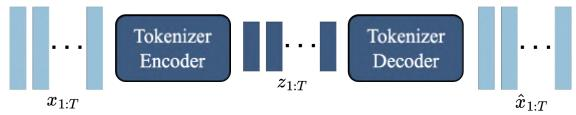
视频 tokenizer 将原始视频压缩为离散 tokens,以降低维度并使视频生成更易处理。其实现为 VQ-VAE,在编码器和解码器中均包含 ST-transformer 组件。给定帧 x1:T=(x1,…,xT),tokenizer 生成离散表示 z1:T=(z1,…,zT),其中每一帧由离散潜在空间中的 tokens 表示。tokenizer 使用视频序列上的标准 VQ-VAE 重构目标进行训练。使用 ST-transformer 是有意设计:它将时间上下文注入潜在代码,因此每个 zt 都反映来自已观测视频前缀的信息。同时,该架构避免完整时空注意力的高成本,因为主要注意力操作随帧数扩展比完整时空 transformer 更高效。下方图展示了 tokenizer 结构:
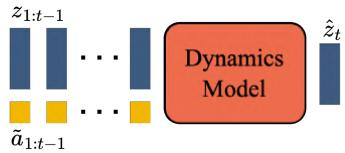
动态模型是仅解码器 MaskGIT transformer。在每个时间步 t,它接收先前 token 序列 z1:t−1 和 stop-gradient 潜在动作 a~1:t−1,然后预测下一帧 tokens z^t。在训练中,模型从 z1:T−1 和 a~1:T−1 预测 z^2:T,并使用预测 tokens 与真实 tokens z2:T 之间的交叉熵损失进行优化。为支持 MaskGIT 风格训练,输入 tokens z2:T−1 按 Bernoulli 分布随机掩码,其掩码率从区间 [0.5,1] 均匀采样。研究发现,将潜在动作作为加性 embedding,而不是与帧 tokens 拼接,能提升可控性。下方图展示了动态模型输入和预测路径:
在推理时,Genie 表现为可控视频环境。玩家从提示图像 x1 开始,该图像经过 tokenizer 编码器生成初始 tokens z1。玩家随后选择一个离散潜在动作 a1∈[0,∣A∣)。该离散索引通过 VQ 码本映射为动作 embedding,动态模型预测下一组 tokens z^2。随着更多动作被提供,该过程自回归地重复,产生 z^2:T。生成的 tokens 由 tokenizer 解码器解码为视频帧 x^2:T。由于学习到的潜在动作语义在不同输入之间保持一致,用户可以探索模型,如同学习控制器上的按钮:同一动作在不同语境中往往引发相似转换。同一机制也允许通过向模型输入初始帧和推断动作来重新生成真实视频,或通过改变动作序列生成新轨迹。
实验
实验在大规模互联网平台游戏视频和机器人视频数据上评估 Genie,并使用视频保真度和潜在动作可控性评估无监督潜在动作是否支持高质量、交互式生成。规模扩展研究表明,随着模型大小和批量大小增加,性能持续提升;定性结果表明,在分布外提示以及视差和物体操控等涌现行为上具有稳健可控性。关于基于潜在动作的模仿和消融实验表明,原始像素和所选时空 tokenizer 比替代方案更好地保留运动信息,表明 Genie 具有作为用于 agent 训练的基础世界模型的潜力。
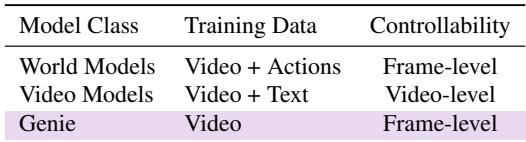
Genie 被描述为仅使用视频数据训练的生成式视频和世界模型,不使用显式动作或文本标注。与先前模型类别相比,其使用学习到的潜在动作空间实现帧级可控性;视频模型通常只提供视频级控制,世界模型则依赖动作标注数据。Genie 训练只需要视频数据。Genie 通过学习到的潜在动作支持帧级控制。先前世界模型需要视频加动作,而视频模型需要视频加文本,并提供视频级控制。
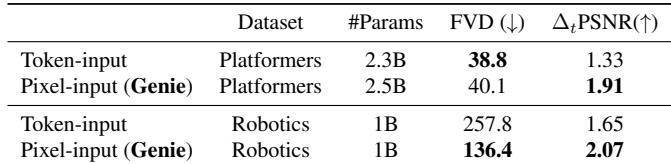
比较潜在动作模型输入时,token 输入变体在 Platformers 上获得略微更好的视频质量,但在 Robotics 上视频质量明显更差。像素输入 Genie 在两种环境中都提供更高可控性,表明原始视频输入总体上更有益。token 输入仅在 Platformers 上有轻微 FVD 优势。像素输入 Genie 在两个数据集上都提升可控性。
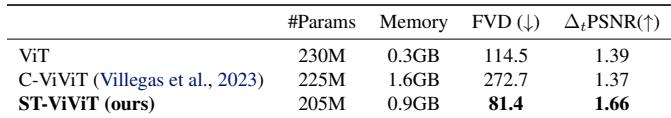
在参数量相似的仅空间 ViT、C-ViViT 和 ST-ViViT tokenizer 之间,ST-ViViT 在视频生成和可控性指标上表现最佳。它还比 C-ViViT 使用更少内存,并避免 C-ViViT 的较差生成质量,这表明 ST-ViViT 中的时空注意力有效,且没有完整时空注意力的成本。ST-ViViT 在比较 tokenizer 中给出最低 FVD 和最高 delta_t PSNR。C-ViViT 使用远高于 ST-ViViT 的内存,同时生成结果明显更差。ST-ViViT 在保真度、可控性和内存之间提供实用平衡。
实验将 Genie 与先前的视频模型和世界模型进行比较,并在 Platformers 和 Robotics 设置下评估其可控性和生成质量。结果表明,学习到的潜在动作支持帧级控制,无需显式动作或文本标注,且像素输入变体通常比 token 输入变体产生更好的可控性。tokenizer 比较进一步表明,在评估架构中,时空 ViViT 在视频保真度、可控性和内存使用之间达到最佳实用平衡。