Command Palette
Search for a command to run...
窃取生产级语言模型的一部分
窃取生产级语言模型的一部分
摘要
我们提出了首个从黑盒生产级语言模型(如 OpenAI 的 ChatGPT 或 Google 的 PaLM-2)中提取精确、非平凡信息的模型窃取攻击。具体而言,我们的攻击在典型的 API 访问条件下,能够恢复 Transformer 模型的嵌入投影层(在对称性意义下)。花费不到 20 美元,我们的攻击即可提取 OpenAI 的 ada 和 babbage 语言模型的完整投影矩阵。由此,我们首次证实这些黑盒模型的隐藏维度分别为 1024 和 2048。我们还恢复了 gpt-3.5-turbo 模型的精确隐藏维度大小,并估计恢复其完整投影矩阵所需的查询成本不到 2,000 美元。最后,我们讨论了潜在的防御与缓解措施,并探讨了可能扩展本攻击的未来工作的影响。
一句话总结
DeepMind、ETH Zurich、University of Maryland 及合作者提出了首个模型窃取攻击,该攻击能够从黑盒生产级语言模型中,通过标准 API 访问恢复 transformer 模型的嵌入投影层(在对称性意义下),并以低至 $20 的成本确认了 OpenAI 的 ada、babbage 和 gpt-3.5-turbo 的隐藏维度。
核心贡献
- 本文提出了一种模型窃取攻击,能够从典型 API 输出中恢复 transformer 黑盒生产级语言模型的嵌入投影层,并利用 logit 偏置和对数概率等特性。
- 该攻击提取了 OpenAI ada 和 babbage 的完整嵌入投影矩阵,成本低于 20USD,确认了隐藏维度分别为1024和2048;它还恢复了gpt−3.5−turbo的确切隐藏维度,并估计完整矩阵恢复的查询成本低于2,000。
- 该方法能够从有限的 API 响应信息中重建 logits,在现实 API 约束下有效工作,并讨论了生产级语言模型服务中 API 设计选择所带来的防御、缓解措施及安全影响。
引言
大型语言模型通常通过封闭 API 提供,其架构、训练细节和权重仍然隐藏。这形成了一个重要的应用背景:如果模型权重和内部参数无法直接检查,攻击者可能尝试通过重复 API 查询推断它们,这正是模型窃取研究领域所研究的问题。
先前的高保真模型窃取工作依赖一些不适用于生产级语言模型的假设,例如 ReLU 激活、适合有限差分的连续输入、小规模网络以及对高精度 logits 的访问。这些假设对现代 LLM 失效,因为它们使用 token 化文本、transformer 组件、非 ReLU 激活、极大规模以及受限的输出接口。
作者提出了一种黑盒自顶向下攻击,直接针对 transformer 语言模型的最终嵌入投影层。通过利用最终 logit 投影的低秩结构,并通过暴露对数概率或 logit 偏置的 API 发起定向查询,该攻击可以恢复最后一个权重矩阵,或推断隐藏嵌入维度。这一贡献具有重要意义,因为它表明可以从生产级 LLM 中提取部分但精确的模型信息,从而削弱其黑盒安全态势,并促使 API 采用更强的防御机制。
方法
作者将提取问题形式化为对生产级语言模型暴露的 oracle 发起的一组查询序列。在最强威胁模型中,攻击者可以在 softmax 之前观察任意前缀 p 的原始 logit 向量:
O(p)←Wgθ(p),其中 gθ(p) 是最终隐藏表示,W 是输出嵌入投影矩阵。该 oracle 揭示一个 l 维 logit 向量,其中 l 是词汇表大小,即使隐藏表示只有 h 维。整个提取流程围绕这一维度差距展开。
第一阶段是隐藏维度恢复。作者使用许多不同前缀查询模型,并将响应堆叠成一个矩阵
Q(p1,…,pn)=O(p1)⋯O(pn).由于每一列都满足 O(pi)=Wgθ(pi),响应矩阵可分解为
Q=WH,其中 H 的隐藏维度为 h。因此,在关于 W 和隐藏状态矩阵的一般满秩假设下,Q 的秩等于 h。在实际中,由于生产级 logits 可能是低精度的,作者不使用精确秩,而是通过排序奇异值
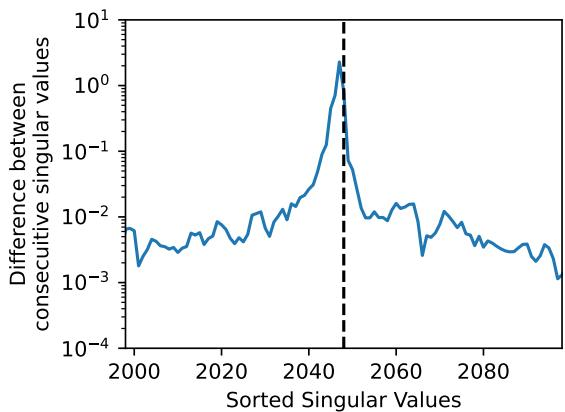
λ1≥λ2≥⋯≥λn并选择使比值 λi/λi+1 最大的索引来估计数值秩。该索引标识了从较大的有意义奇异值到较小的数值噪声奇异值的过渡。如下方图示所示,恢复出的隐藏维度对应于奇异值谱中的一个尖锐间隙。
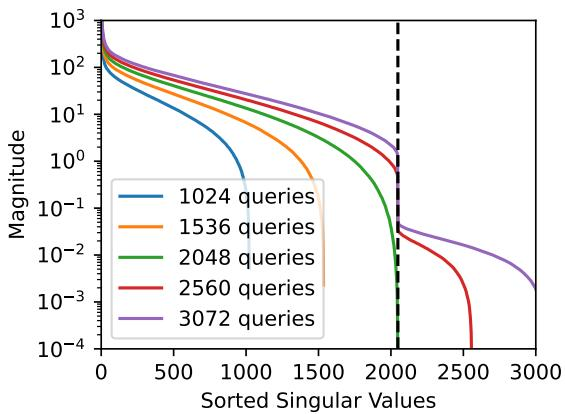
也可以通过增加查询数量并追踪出现多少个数值显著的奇异值来观察同一现象。当查询数量低于隐藏维度时,响应矩阵似乎会继续添加独立方向;但一旦查询数量超过 h,较大奇异值的数量便停止增长。如下方图示所示,这种饱和使得有效隐藏维度可被识别。
一旦已知隐藏维度 h,作者便进入完整输出层提取阶段。他们对响应矩阵应用奇异值分解:
Q=UΣV⊤.在相同秩假设下,主导奇异结构直接编码了最终投影矩阵,至多相差一个可逆隐藏空间变换。具体而言,矩阵
W=UΣ满足
W=WG其中 G 是某个 h×h 矩阵。这提供了最终层的高保真重建,但仅存在于隐藏空间对称性的意义下。作者证明,在额外的类似 transformer 的残差假设下,W 的精确恢复是不可能的,因为仅凭 logits 无法唯一确定变换 G。为了评估提取质量,他们求解一个最小二乘问题
WG≈W然后将变换后的重建结果与真实输出矩阵进行比较。
随后,作者放宽了完整 logit oracle 假设,并处理生产模型所暴露的 API。许多此类 API 仅返回添加用户可控 logit 偏置之后的 top K 对数概率:
O(p,b)←TopK(logsoftmax(Wgθ(p)+b)).由于 softmax 对 logits 的可加平移保持不变,目标变为相对于某个参考 token 恢复 logits,而不是恢复绝对 logits。对于 top-K API,作者选择一个天然高概率的参考 token,然后在单次查询中将若干目标 token 偏置到 top K 中。如果使用 token R 作为参考,并用大偏置 B 提升 token i,那么观察到的 top token 对数概率会揭示相对 logit 差异:
yRB−yiB−B=zR−zi.通过循环遍历 token 块,攻击者可以恢复完整的相对 logit 向量。基线成本大约为每个恢复出的 logit 需要 1/(K−1) 次查询,因为返回的 K 个 token 中有一个充当参考。作者还描述了一种扩展方法,其中每个返回的对数概率都被视为对原始 logits 的线性约束,从而将查询成本降低至接近 1/K。
对于会生成多个 token 或对 prompt token 暴露对数概率的 API,作者利用重复的 token 生成。他们通过给予某个重复 token x 很大的 logit 偏置来迫使模型输出该 token,同时给予仍然留在 top 输出中的其他 token 稍小的偏置。这使攻击者能够检查每个生成位置的 top-K 对数概率,并从单次查询中恢复许多位置的 logit 信息。由此产生的查询成本取决于扩展长度 m,而 token 成本则随扩展和 API 开销共同增加。
作者进一步考虑更严格的 API,这些 API 仅暴露 top log probability,并将每个 logit 偏置限制为二值,例如 0 或 −1。即便在这种设置下,他们也表明可以通过比较目标 token 在无偏置和带有小负偏置条件下 top token 的对数概率来提取信息。两次观测之间的差异取决于目标 token 的原始对数概率,因此重复查询可以一次恢复一个 token 的 logit 信息。该方法不如 top-K 偏置 logit 攻击数值稳定,但它证明了即使极度受限的 API 仍可能泄露结构性模型信息。
当完全无法获得对数概率时,作者描述了一种无 logprob 方法,该方法基于对 logit 偏置的二分搜索。对于每个 token,攻击者增加或减少其偏置,直到模型的 argmax 输出发生变化。发生这种转变时的偏置值提供了该 token logit 的相对估计。虽然直观的逐 token 二分搜索成本很高,但作者指出可以同时修改多个 token 的偏置,而观察到的 argmax token 会提供关于哪个 token 具有最大带偏置 logit 的部分信息。这种并行化提高了查询效率,尽管其成本仍高于能够观察对数概率的攻击。
该方法还自然地引出防御考虑。整个提取流程依赖于暴露能够揭示最终隐藏维度几何结构的信息。作者讨论了完全移除 logit 偏置、用屏蔽列表替代它、禁止同时使用 logit 偏置和对数概率、向输出 logits 添加噪声、对给定 prompt 的偏置查询进行速率限制,或修改最终层架构,使得可观察隐藏维度不直接揭示原始 h。一种架构方法通过带非线性的中间扩展拆分最终投影;另一种方法在输出矩阵中加入额外低幅值正交方向,并向隐藏向量注入噪声,使观测到的 logit 几何结构看起来比真实隐藏维度更宽。
实验
实验评估模型权重和完整 logit 向量是否能够通过 API 查询恢复,并使用成本指标区分 token 花费、查询延迟以及重建参数与真实参数之间的数值一致性。实验表明,在适当假设下,理论提取攻击能够准确重建模型组件,尽管一些更强的变体因数值不稳定而不切实际,而更稳健的攻击仍然高效。在真实生产模型中,攻击成功恢复隐藏维度和完整层,得到的参数与原始权重几乎相同,并在允许的情况下确认了准确的模型规模。
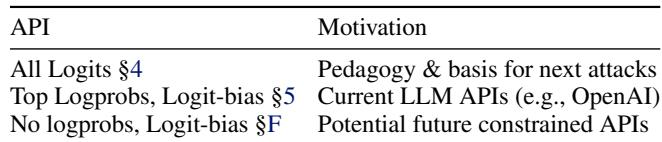
表格总结了模型提取的不同 API 访问设置,从完整 logit 访问到带有 logit 偏置的受限接口。这些设置对应不同动机,涵盖教学、实际部署以及更严格的 API 设计。完整 logit 访问被描述为后续攻击的基础。带 logit 偏置的 top logprob 访问与当前 LLM API 相关。带 logit 偏置的 no-logprob 接口则被描述为一种可能的未来受限 API。
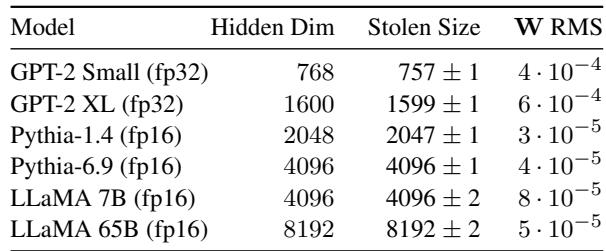
实验显示,该攻击能够在不同大小和精度的开源模型上准确恢复隐藏维度。在仿射对齐后,它还能以非常低的误差重建输出投影矩阵,表明窃取到的表示接近真实权重。重建误差远小于随机初始化矩阵的误差。窃取到的规模估计与模型已知隐藏维度非常接近。恢复出的投影矩阵具有很低的 RMS 误差,且远优于随机初始化。
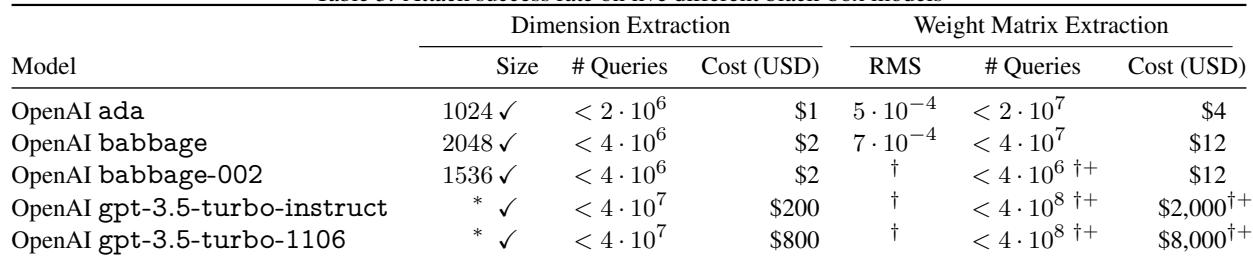
该攻击成功恢复了全部五个受测生产模型的隐藏维度,即使相关规模被隐藏,报告的大小也被确认正确。对于完成了完整层恢复的模型,权重提取高度准确,但较大 GPT-3.5 变体的工作量和成本显著增长。隐藏维度提取对全部五个模型都有效,并与其真实规模一致。提取出的权重矩阵与实际权重高度对齐,这一点由低 RMS 误差所证明。大规模 GPT-3.5 提取尝试需要明显更高的查询次数和成本,且出于安全原因未运行部分权重提取。
结果表明,拥有更强 logprob 访问能力的攻击通常能恢复真实 logit 向量更多的比特。four logprob top-5 方法以每个 logit 最少的查询次数提供最佳精度,而其他方法只有在更高查询成本下才接近相似精度。在无 logprob 攻击中,one of n 方法高效地实现了强精度,而二分搜索需要多得多的查询却得到低得多的精度。four logprob top-5 攻击是最精确且查询效率最高的方法。five logprob top-5 攻击在实际中表现更差,尽管每次查询能学习更多 logprob,这说明数值不稳定性可能降低保真度和效率。最强的无 logprob 攻击以相对较少的查询恢复了 logit 向量的大部分内容,是在 logprob 不可用时的最佳替代方案。
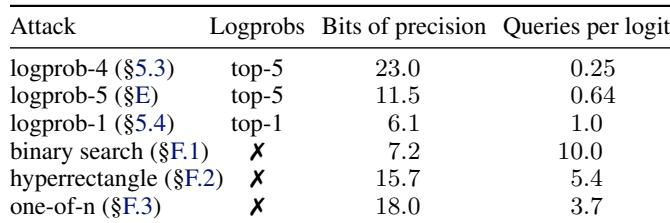
实验在多种 API 访问设置下评估模型提取,从完整 logit 访问到带有 logit 偏置的受限 no-logprob 接口。作者首先在开源模型上验证该攻击,准确估计隐藏维度并重建投影矩阵,然后将评估扩展到生产模型;在生产模型中,隐藏大小始终被恢复,即使更大系统成本更高,提取出的权重仍接近真实参数。对不同提取策略的比较表明,访问更多 logprob 信息通常提高保真度,其中 top-5 方法提供最佳查询效率,而高效替代方案在 logprob 不可用时仍然可行。