Command Palette
Search for a command to run...
VideoPoet:一种用于零样本视频生成的超大语言模型
VideoPoet:一种用于零样本视频生成的超大语言模型
摘要
我们提出了 VideoPoet,一种能够从多种多样的条件信号中合成高质量视频的模型。VideoPoet 采用仅解码器 Transformer 架构,能够处理多模态输入,包括图像、视频、文本和音频。其训练流程遵循大语言模型(LLM)的范式,包含预训练和任务特定适配两个阶段。在预训练阶段,VideoPoet 在自回归 Transformer 框架中融合了多种多模态生成目标。预训练得到的 LLM 作为基础模型,可被适配到多种视频生成任务中。实验结果展示了该模型在零样本视频生成方面的领先能力,尤其凸显了其在生成高保真运动方面的优势。
一句话总结
VideoPoet 是一个 decoder-only 自回归 Transformer,通过两阶段 LLM 风格协议进行训练,即预训练和任务特定适配,利用图像、视频、文本和音频等多模态条件信号,实现了最先进的零样本视频生成和高保真运动合成。
核心贡献
-
VideoPoet 是一个 decoder-only Transformer,按照大型语言模型的方式进行训练,可基于图像、视频、文本和音频,通过自回归多模态预训练和任务特定适配合成高质量视频。
-
该方法使用经 token 化的文本配对视频与非配对视频数据进行训练,并混合多种多模态生成目标。对于 latent token 空间中的视频超分辨率,它使用带有高效窗口化局部注意力的双向 Transformer。
-
评估与演示表明,其零样本视频生成性能具有竞争力并达到最先进水平,尤其在跨多种视频生成与编辑任务的高保真、大尺度、复杂运动方面表现突出。
引言
视频生成已成为基础模型中快速增长的应用方向,大多数系统依赖扩散方法,这些方法从强大的图像生成模型出发,再引入时序建模以支持视频生成。这很重要,因为高质量视频生成对于创意、媒体和多模态 AI 系统都至关重要,而语言模型提供了一条可能路径,可以构建统一架构,复用成熟的 LLM 训练与推理基础设施。不过,相关研究指出,此前基于语言模型的视频生成器在视觉质量上仍未达到扩散模型的水平,而扩散方法往往需要额外的 adapter、架构改动或推理技巧,才能支持多种任务和模态。
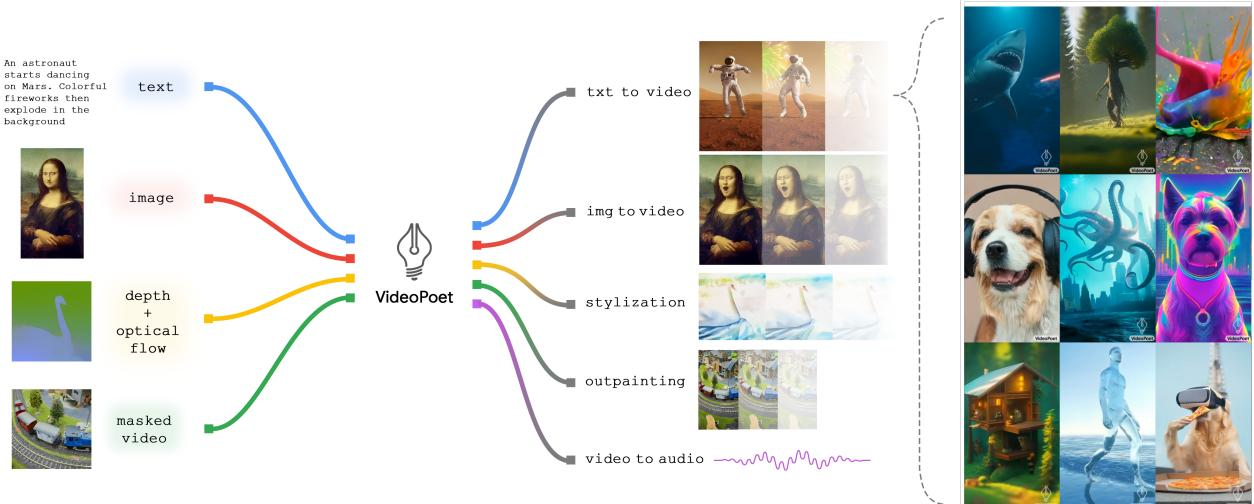
相关研究提出 VideoPoet,一个面向视频生成的 decoder-only 大型语言模型,它将图像、视频和音频表示为离散 token。该模型在多种多模态目标混合上进行预训练,随后在单一架构内适配到文生视频、图生视频、视频编辑和视频风格迁移等任务。其贡献是一种概念验证,证明 LLM 可以被训练为通用视频生成器,其中包括多任务预训练方法、向更长视频的自回归扩展,以及在 latent token 空间中运行的视频超分辨率方法。
数据集
-
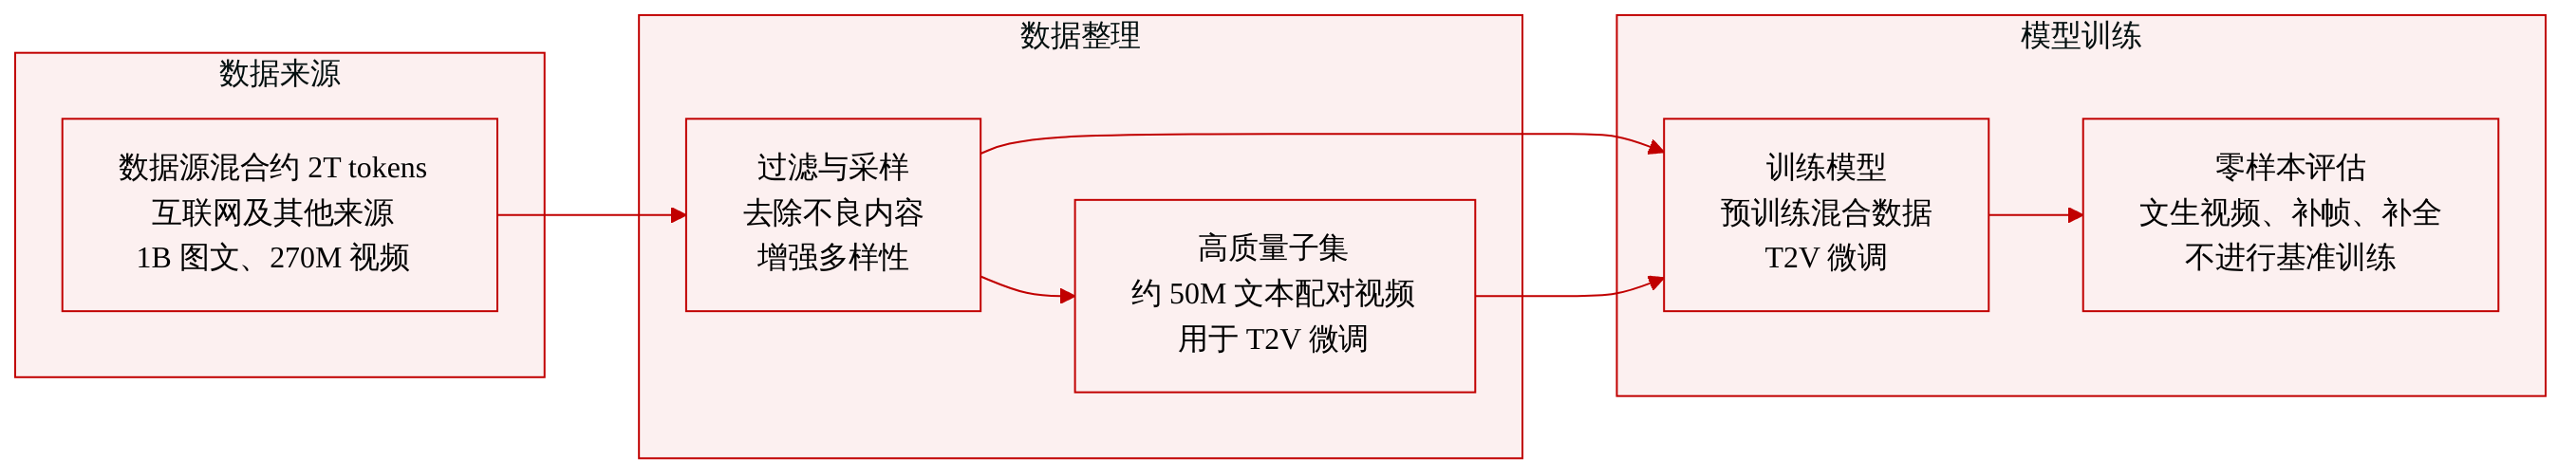
使用一个跨模态总量约 2 万亿 tokens 的大规模多模态数据集,数据来自公开互联网内容和其他来源。
-
核心训练数据包括:
- 10 亿图文对。
- 约 2.7 亿段视频,其中:
- 约 1 亿段视频具有配对文本。
- 约 5000 万段具有配对文本的视频用于高质量微调。
- 约 1.7 亿段视频具有配对音频。
-
在训练前,会对数据集进行过滤,移除严重不当内容,并通过采样提升上下文和人群多样性。
-
模型使用这一大规模多模态语料库,在多种预训练任务混合上进行训练。
-
对于文生视频评估,还会基于高质量训练子集进行微调。除另有说明外,不在任务特定评估数据上进行微调。
-
评估协议为零样本,意味着模型未在目标基准的训练部分上训练。
-
评估数据包括:
- MSR-VTT 和 UCF-101,用于文生视频。
- Kinetics 600,用于帧预测,其中前 5 帧作为条件来预测后续 11 帧。
- Something-Something V2,用于补全和外延任务。
方法
相关研究利用一种基于 token 的多模态生成框架,将视觉和音频信号转换为离散序列,并使用大型语言模型主干在统一 latent 空间中完成视频生成、音频生成及相关任务。该方法包含三个主要阶段。第一,模态专用 tokenizer 将像素、视频帧和音频波形映射为离散 token。第二,前缀语言模型主干将这些 token 与文本 embeddings 一起输入,并自回归预测目标视觉和音频 token。第三,专门的超分辨率模块提高视频分辨率并细化视觉细节,同时保持在 token 空间内。
关于输入输出序列布局,请参见框架图。
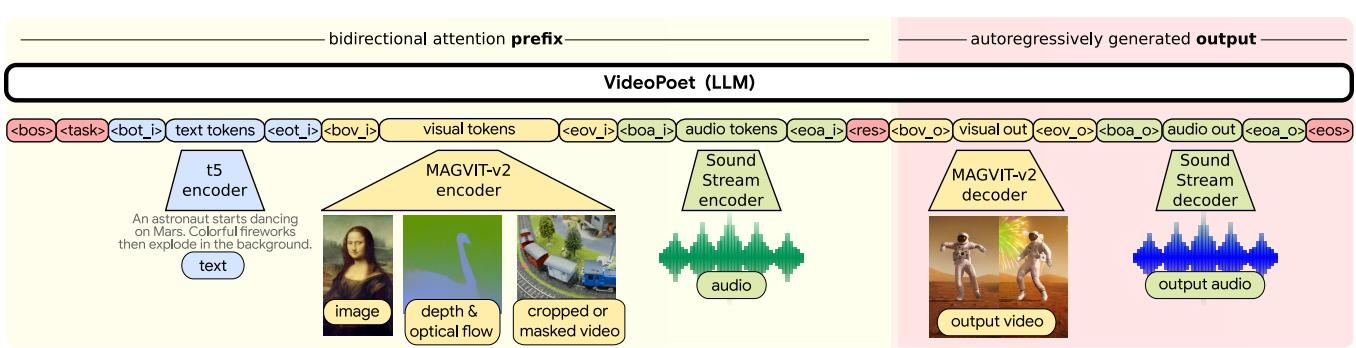
该布局将双向前缀输入与自回归生成的输出分开。前缀可包含 text embeddings、视觉条件 token、音频条件 token,以及标记模态边界和任务类型的特殊 token。语言模型随后以因果方式生成输出部分,产生视觉 token 和 audio tokens,这些 token 后续由模态专用解码器解码。这种设计允许通过改变前缀模式和目标输出类型,让同一个自回归主干支持许多任务组合。
对于视觉输入,模型使用 MAGVIT-v2 对图像和视频进行 token 化。视频片段被编码并量化为整数序列。在 128×128 分辨率、每秒 8 帧下,17 帧片段会产生 (5,16,16) 的 latent shape,并展平为 1280 个 token,词表大小为 218。竖屏视频在 128×224 分辨率下产生 (5,28,16) 的 latent shape,对应 2240 个 token。该 tokenizer 强制因果时序依赖,从而支持生成更长的视频。图像被视为单帧情形,具有固定 token shape (1,16,16)。对于补全和外延,使用 COMMIT 编码方案。
对于音频,一个预训练 SoundStream tokenizer 将音频片段映射为离散 token。2.125 秒片段通过四级残差向量量化器嵌入为 106 个 latent frames。模型从较低到较高残差量化级别逐级预测 audio tokens。每一级都有互不重叠、各含 1024 个 code 的词表,合并后的音频词表共包含 4096 个 code。文本不会离散化到同一个 token 词表中,而是使用预训练 T5 XL embeddings 表示文本引导。这些 embeddings 在作为条件信号使用前,会通过一个线性层投影到 Transformer embedding 空间中。
核心生成器是一个采用 decoder-only 架构的前缀语言模型。模型将 text embeddings、视觉 token、audio tokens 和特殊 token 组织为前缀,形成任务特定序列,然后在输出区域预测视觉 token 和 audio tokens。训练损失仅应用于生成的输出部分。任务特定 token 表示期望的输出模态或任务类型。不需要某一模态的任务会直接省略对应输入或输出 token,从而缩短序列。当期望输出相同的时候,同一个任务 token 可以复用于不同输入变体,使模型能够基于可用条件信号进行适配。
任务提示设计支持多种生成设置,包括无条件视频生成、文生视频、视频未来帧预测、图生视频、视频补全与外延、视频风格化、音频到视频、视频到音频,以及音视频续写。视频 token 在两种空间分辨率 128×128 和 128×224,以及两种时间长度 17 帧和 41 帧下生成,二者均按每秒 8 帧编码。条件 token 表明所需分辨率和时长。图像被视作单帧视频的特例,分辨率为 128×128。对于文生图预训练,模型可以省略序列结束 token 和视觉输出结束 token,允许连续生成 token,从而使图像生成与更长视频生成更加一致。对于风格化,模型可以基于文本、光流和深度进行条件化,其中文本控制外观,而光流和深度提供结构引导。
训练策略旨在处理不同任务之间高度可变的序列长度。相关研究使用交替梯度下降,根据序列长度将任务分组,并在每次训练迭代中轮流采样一个组。相比直接打包,这可以减少填充开销。预训练计划也将图像数据与视频数据分开。在训练前半段,图像数据以更高频率采样,以改善物体级理解。在训练后期,采样分布转向视频数据,使模型更关注运动和时序一致性。预训练后的模型随后会在更高质量数据上针对特定任务微调。该微调阶段有助于减少重复性 token 预测,提升输出多样性,并支持更强的 classifier-free guidance。
直接通过自回归语言建模生成高分辨率视频并不实际,因为 token 数量会快速增长。例如,一个 17×896×512 视频可能产生约 35,840 个视觉 token,使自回归采样计算成本很高。为解决这一问题,相关研究训练了一个在 token 空间中运行的非自回归视频超分辨率 Transformer。该模块不会在整个高分辨率序列上执行全局自注意力,而是使用窗口化局部注意力。每个 Transformer block 包含三个注意力层,分别在时间、空间水平或空间垂直维度对齐的局部窗口上进行注意力计算。交叉注意力层关注低分辨率 token 序列,并同样限制在局部窗口内。该模块还会关注 T5 XL text embeddings。
关于超分辨率模块所用自定义 Transformer 设计,请参见下方架构图。
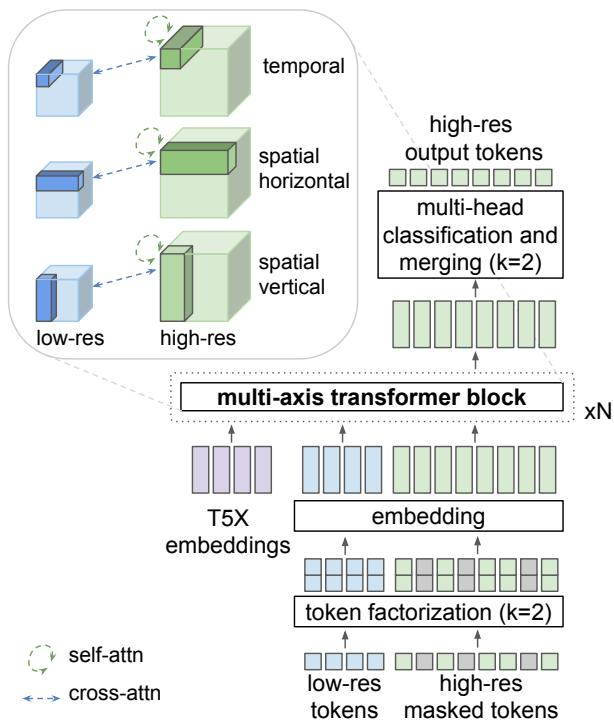
为了管理大型离散词表,超分辨率 Transformer 使用 k=2 个因子的 token factorization,将 262,144-way 分类问题转化为两个 512-way 分类问题。低分辨率条件序列通过对双三次下采样的 ground-truth 视频进行 token 化来构造。在离散 latent 空间中加入噪声增强,有助于缩小真实低分辨率视频与生成低分辨率视频之间的差异。训练时,会对低分辨率 token 值的一个随机子集重采样,并对一部分训练样本分别独立丢弃低分辨率条件和 text embedding。推理时,该模块采用非自回归采样,并分别对低分辨率条件和文本条件施加 classifier-free guidance。系统堆叠两个 2× 超分辨率阶段,将语言模型主干输出的基础 224×128 结果放大到 896×512 分辨率。
实验
评估在文生视频、帧预测、补全或外延基准上进行零样本生成,并单独进行微调文生视频和人类偏好比较。消融实验表明,将文本配对视频和图像任务与自监督任务结合,可获得最均衡的整体性能,而规模扩展可提升能力。与近期扩散模型和基于 token 的模型相比,其性能具有竞争力或更优,特别是在运动趣味性和真实感方面。模型还展现出图生视频、长视频生成、编辑、风格化和相机运动控制等统一能力,不过 token 重建会限制细节和视觉保真度。
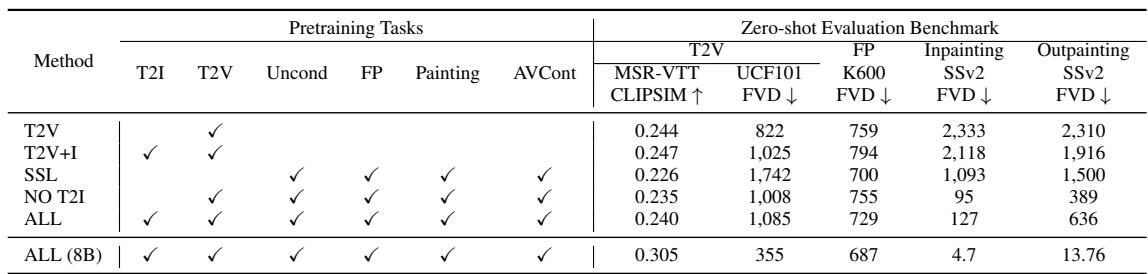
可比较的 300M 模型表明,文本配对数据对零样本文生视频很重要,而仅自监督训练在文本条件质量上仍较弱。加入图文预训练可改善文视频对齐,并可能使重绘相关指标优于单独文生视频。完整多任务设置在不同评估中平均平衡最佳,尽管某些较窄任务子集可在单项指标上更强。缺少图文预训练时,文生视频在文视频对齐上会变弱。仅自监督模型可改善部分无条件和帧预测指标,但无法提供较强的零样本文生视频评估。缺少图文预训练能带来最强的重绘结果,而完整多任务模型提供更均衡的整体表现。
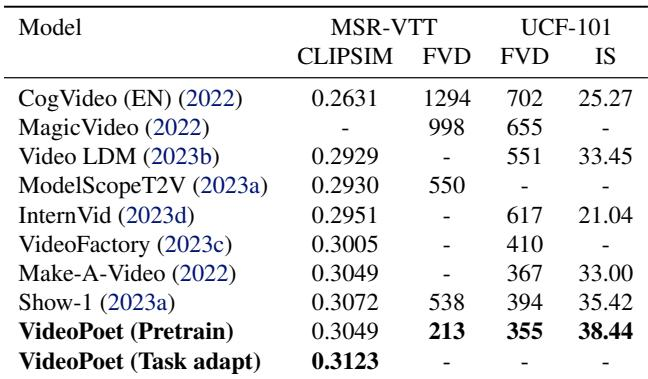
该表使用 CLIP similarity 和 FVD 分数,比较 MSR-VTT 与 UCF-101 上的零样本文生视频结果。被评估模型相对先前基线表现良好,尤其在 CLIP similarity 和 FVD 上。预训练基础模型在各指标上具有竞争力,在高质量文本视频子集上微调后,进一步提升了 MSR-VTT 上的 CLIP similarity。模型在 MSR-VTT 和 UCF-101 上展现出良好的零样本文生视频性能。在高质量文本视频对上微调可进一步提升 MSR-VTT 上的 CLIP similarity。
比较训练数据策略的实验表明,文本配对数据对零样本文生视频不可或缺,而仅自监督训练在文本条件质量上仍较弱。图文预训练可改善文视频对齐,并可能强化重绘相关结果,而完整多任务设置在多样评估中提供最均衡的整体性能。MSR-VTT 与 UCF-101 上的额外比较表明其零样本文生视频结果具有竞争力,在高质量文本视频数据上微调可进一步提升文视频相似度。