Command Palette
Search for a command to run...
面向高分辨率图像合成的 Rectified Flow Transformer 扩展研究
面向高分辨率图像合成的 Rectified Flow Transformer 扩展研究
摘要
扩散模型通过逆向数据到噪声的前向路径从噪声中生成数据,已成为图像、视频等高维感知数据的一种强大生成建模技术。Rectified Flow 是一种较新的生成模型公式化方法,它以直线路径连接数据与噪声。尽管其具有更优的理论性质和概念上的简洁性,但尚未被确立为标准实践。在本工作中,我们改进了现有的噪声采样技术,使其偏向感知相关的尺度,从而优化 Rectified Flow 模型的训练。通过大规模实验研究,我们证明了该方法在高分辨率文本到图像合成任务上优于现有的扩散模型公式化方法。此外,我们提出了一种新颖的基于 Transformer 的文本到图像生成架构,该架构为两种模态使用独立权重,并实现了图像 token 与文本 token 之间的双向信息流动,从而提升了文本理解、文字渲染效果以及人类偏好评分。我们证明该架构遵循可预测的扩展趋势,且较低的验证损失与更好的文本到图像合成效果(通过多种指标和人类评估衡量)之间存在正相关。我们最大的模型超越了当前最先进的方法。Stability AI 正在考虑公开实验数据、代码和模型权重。
一句话总结
Stability AI 通过引入感知偏置的噪声采样,以及一种具有分离图像与文本 token 权重、并支持双向跨模态注意力的新型 transformer 架构,扩展了 rectified flow transformers,以实现高分辨率文本到图像合成;其工作展示了可预测的扩展趋势,并在自动化指标和人工评估中取得了领先性能。
核心贡献
- 提出一种用于训练 rectified flow 模型的重新加权时间步采样方法,该方法将时间步选择偏向感知上更相关的尺度;一项大规模研究表明,相比已有 diffusion 公式,该方法在保留少步采样优势的同时,改善了高分辨率文本到图像合成。
- 提出一种面向文本到图像生成的 transformer 多模态架构,使用分离的图像和文本 token 流、模态特定权重和双向信息流;相比 UViT 和 DiT 主干,该架构提升了文本理解、文字排版能力和人类偏好评分。
- 开展了参数规模最高达 80 亿、训练计算量达 5 x 10^22 FLOPs 的扩展研究,展示了可预测的扩展趋势,并表明更低的验证损失与 T2I-CompBench、GenEval 和人工评估上的更强结果相关。最大模型超越了 SDXL、SDXL-Turbo、Pixart-α 和 DALL-E 3。
引言
Diffusion 模型通过逆转噪声来生成图像和视频,已成为高分辨率文本到图像合成的主流方法。这一问题之所以重要,是因为这些模型能够生成多样化的高质量媒体内容,但其迭代采样可能缓慢且昂贵,因此更高效的公式化方法具有重要意义。
已有工作主要面临两类局限。第一,从数据到噪声的前向路径选择会同时影响生成质量和采样效率;直线型 rectified flow 具有吸引人的性质,但此前尚未在大规模文本到图像设定中得到广泛验证。第二,常见架构通常通过 cross-attention 等单向机制,将固定的文本表示输入图像模型,这可能限制生成过程中文本与图像信息的交互方式。
针对这些不足,该研究引入了改进的噪声加权和 rectified flow 模型采样器,并提出了一种具有分离图像与文本 token 流的多模态 transformer 架构,从而实现双向信息流。随后,该方案被扩展至 80 亿参数模型,训练计算量达到 5 x 10^22 FLOPs。结果表明,更低的验证损失与更好的基准测试和人工评估结果高度相关,并且该方法优于此前的开放和闭源系统。
数据集
-
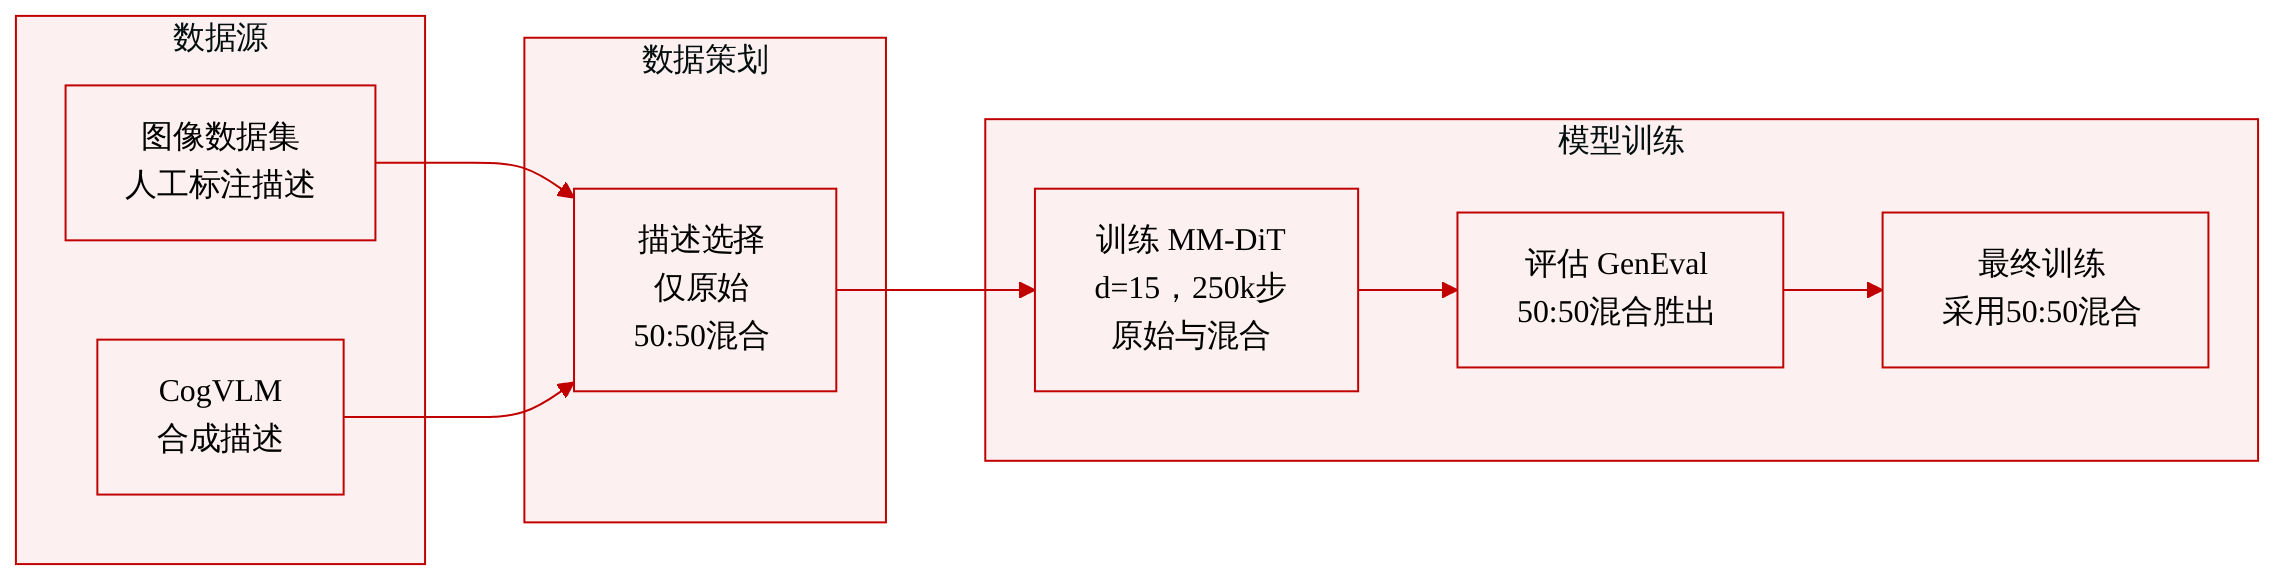
研究者使用一个大规模图像数据集,并以其中已有的人工撰写标题作为基础数据源。
-
为提升标题质量,研究者使用现成的视觉语言模型 CogVLM 生成合成标题。
-
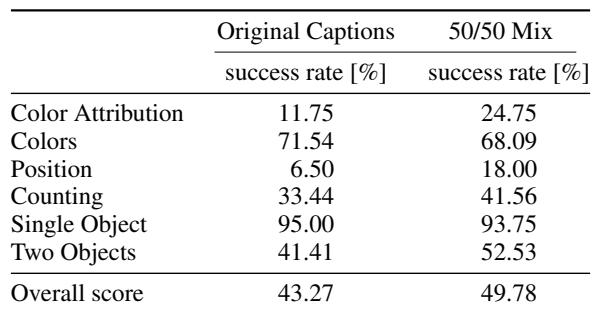
研究者以 50:50 的比例混合原始标题和合成标题,以保留纯合成标题中可能缺失的概念。
-
研究者比较了仅使用原始标题和 50:50 混合标题的效果:训练两个 d=15 的 MM-DiT 模型 250k 步,并在 GenEval 上进行评估。
-
实验表明,50:50 原始与合成标题混合的效果更好,因此后续模型训练均使用这种混合标题格式。
方法
该研究采用一种无需仿真的 flow-matching 公式来训练条件生成模型,训练过程中不需要可微 ODE 求解。模型通过一个时间相关速度场 vΘ(yt,t) 定义,该速度场参数化一个 ODE
dyt=vΘ(yt,t)dt.研究者不通过积分该 ODE 来获得训练目标,而是在数据分布 p0 和高斯噪声分布 p1=N(0,1) 之间构造一条前向概率路径。对于干净样本 x0 和高斯噪声 ϵ,插值得到的潜变量状态为
zt=atx0+btϵ,ϵ∼N(0,I),其中边界选择为 a0=1、b0=0、a1=0、b1=1,使得 z0 服从 p0,z1 服从 p1。条件传输映射为
ψt(x0∣ϵ)=atx0+btϵ,其诱导的条件向量场为
ut(z∣ϵ)=ψt′(ψt−1(z∣ϵ)∣ϵ).生成边际概率路径 pt(zt) 的边际向量场需要对 ϵ 求期望,而该期望通常不可处理。因此该方法使用条件目标来优化 Conditional Flow Matching 目标:
LCFM=Et,pt(z∣ϵ),p(ϵ)∥vΘ(z,t)−ut(z∣ϵ)∥22.该目标与不可处理的边际目标具有相同的最小值点,但由于 ut(z∣ϵ) 可以显式计算,因此仍然可处理。对于上述线性插值类别,条件目标可重写为
ut(zt∣ϵ)=atat′zt−ϵbt(atat′−btbt′).引入 log signal-to-noise ratio
λt=logbt2at2,λt′=2(atat′−btbt′),目标变为
ut(zt∣ϵ)=atat′zt−2btλt′ϵ.这一重新参数化允许将 flow objective 表达为加权噪声预测损失。通过定义
ϵΘ(z,t)=λt′bt−2(vΘ(z,t)−atat′z),训练目标可写为统一加权形式
Lw(x0)=−21Et∼U(0,1),ϵ∼N(0,I)[wtλt′∥ϵΘ(zt,t)−ϵ∥2].原始 Conditional Flow Matching 损失对应于以下加权
wt=−21λt′bt2.轨迹 zt 的选择决定了加权 wt 以及训练期间使用的网络预测类型。该方法考虑了多种概率路径。Rectified Flow 定义了直线插值
zt=(1−t)x0+tϵ,得到加权
wtRF=1−tt并直接参数化速度。EDM 使用 variance-exploding 风格路径
zt=x0+btϵ,其由选定尺度调度诱导的对数正态噪声分布,以及一个与 F-prediction 相关的预测目标构成。Cosine 调度定义
zt=cos(2πt)x0+sin(2πt)ϵ,可与 ϵ-prediction 或 v-prediction 配对,从而得到不同的时间相关加权。Latent diffusion 变体也使用 variance-preserving 调度,其中 bt=1−at2,且 at 由离散 diffusion 系数序列 βt 构造,βt 可采用不同的线性化或缩放调度。
除了选择轨迹之外,研究者还定制了训练时间步的采样分布。对于 Rectified Flow,均匀时间步采样等价于在所有时间上均匀训练速度。然而,预测目标 ϵ−x0 通常在轨迹中段最难,因为条件均值在中等噪声水平附近变化迅速。从非均匀密度 π(t) 中采样 t 等价于使用以下加权损失
wtπ=1−ttπ(t).一种提出的密度是对数正态分布
πln(t;m,s)=s2π1t(1−t)1exp(−2s2(logit(t)−m)2),其中
logit(t)=log1−tt.在实践中,通过抽取 u∼N(m,s),并使用 logistic 函数进行映射来生成样本。位置参数 m 将训练偏向类似数据或类似噪声的区域,而尺度参数 s 控制围绕所选时间步区域的集中程度。
由于对数正态密度在端点处趋于零,研究者还使用了一种具有重尾的 mode-sampling 分布。对于尺度参数 s,定义
fmode(u;s)=1−u−s(cos2(2πu)−1+u).对于有效的单调 s 范围,这定义了一个可逆映射,并诱导得到时间步密度
πmode(t;s)=dtdfmode−1(t).正的 s 值强调轨迹中段,负值强调端点,s=0 恢复均匀采样。另一种变体 CosMap 从均匀变量 u 构造时间映射,使 log-SNR 与 cosine 调度匹配。它使用
t=f(u)=1−tan(2πu)+11,u∼U(0,1),密度为
πCosMap(t)=π−2πt+2πt22.对于文本条件生成,模型在预训练 autoencoder 的潜空间中运行。输入 RGB 图像 X∈RH×W×3 由 encoder E 映射为较低维的潜表示
x=E(X)∈Rh×w×d.该 autoencoder 的重建质量限制了可生成的最高图像质量,因此该架构选择潜变量宽度 d=16 作为设计点,以平衡重建保真度与 diffusion 模型学习能力。文本条件由冻结的预训练文本 encoder 生成。该方法将粗粒度池化文本信息与细粒度 token 序列结合。池化文本向量 cvec 用于全局调制,而序列表示 cctxt 被提供给 transformer 主干,使生成期间能够访问短语和单词级别的详细信息。参见架构概览:
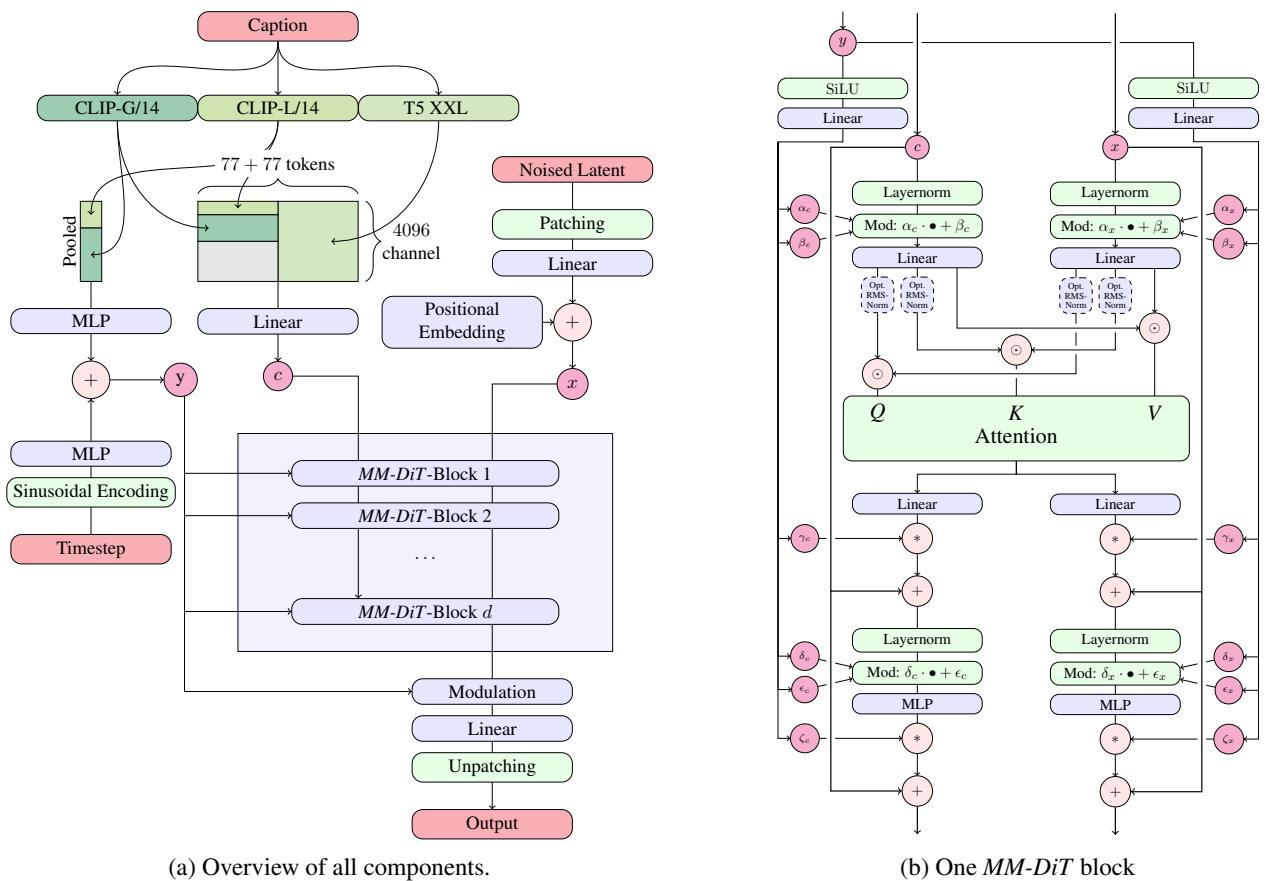
Diffusion 主干是一个多模态 transformer,在潜图像 patch 序列和文本 token 序列上运行。加噪潜变量首先通过展平 2×2 patch 被 patchify,生成长度为
21h⋅21w.的 patch 序列。该 patch 序列和文本 token 序列被嵌入到共同维度并拼接。每个 block 包含调制注意力和 MLP 操作。对于每种模态,layer normalization 后跟随一条由全局条件向量驱动的调制路径。概念上,对于模态 m∈{c,x},注意力前状态可写为
zm=αm⊙LN(zm)+βm,其中 αm 和 βm 由条件向量预测得到。随后文本流和图像流产生模态特定的 query、key 和 value 投影。这些投影被拼接,因此注意力在联合 token 序列上计算。这允许图像 token 和文本 token 交互,同时为每种模态保留独立的学习变换。可选地对 query 和 key 使用 RMS normalization 以稳定训练。注意力之后,残差分支应用一个预测缩放因子
zmatt=zm+γm⊙Attn(zc,zx).MLP 子层使用相同模式,并为 feed-forward 变换加入额外调制和缩放参数。网络使用两组可训练参数,一组用于文本流,一组用于图像流,同时共享注意力计算。这等价于两条模态特定的 transformer 路径,通过联合注意力交换信息,而不是从一个固定 token 序列向另一个 token 序列使用 cross-attention。模型以深度 d 参数化,hidden size 为 64d,MLP 宽度为 4⋅64d,注意力头数等于 d。
训练时,干净潜变量样本及其文本条件被编码,从选定密度中采样时间步,按所选前向过程添加噪声,网络根据参数化预测速度、噪声或等价目标。损失是文本与图像 token 拼接序列上的加权预测误差。推理时,从 p1 中采样噪声,沿时间正向积分学到的 ODE 以生成潜变量样本,再由 autoencoder decoder 将潜变量映射回图像空间。
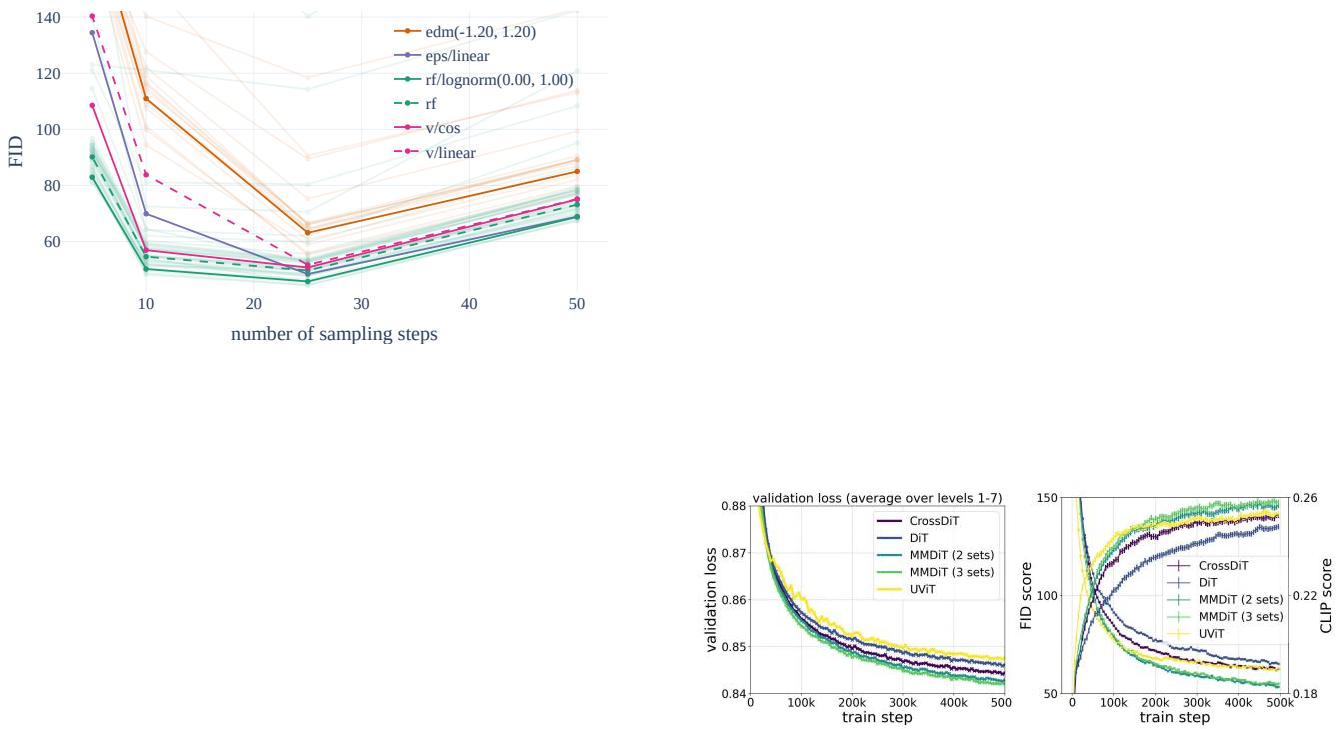
在相同训练设置下与 transformer diffusion 主干比较时,双权重多模态主干表现出比共享权重、cross-attention 或卷积混合设计等基线架构更有利的优化行为。比较还表明,超过两组独立参数后,每增加一组参数集所带来的增益很小,却会增加参数和内存成本。如下图所示:
实验
实验在 ImageNet 和 CC12M 上的受控比较中评估 rectified flow 的训练公式,并评估文本到图像合成的模型组件。训练比较验证了非均匀时间步采样,尤其是强调中间时间步的对数正态调度,能在不同指标和采样器设置下提升稳健性,同时修改后的 rectified-flow 公式可超越已有 diffusion 损失。组件研究进一步表明,更高容量的潜变量 autoencoder、混合合成标题与原始标题,以及提出的 MM-DiT 主干,都能提升生成质量和提示保真度。最后,将模型扩展到大型图像和视频模型时,验证损失随模型规模和计算量稳定下降,更大模型在更少的采样步数下取得更强的基准测试和人类偏好结果。
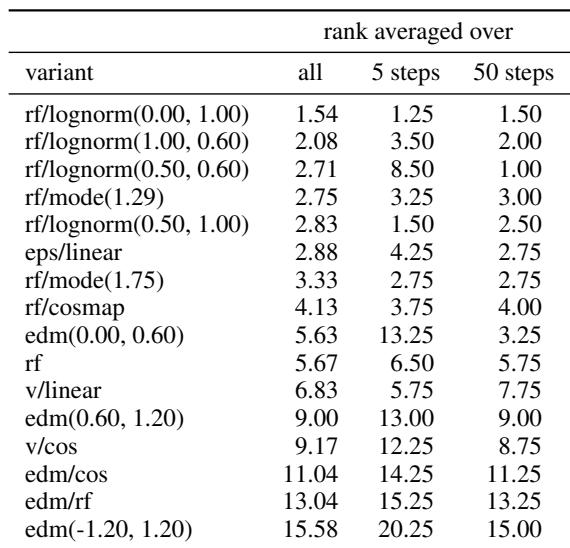
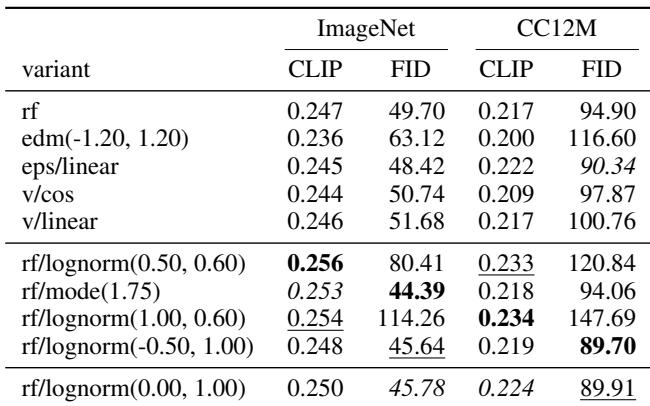
在已测试的公式中,当性能按权重类型、数据集和采样设置平均时,采用对数正态时间步加权的 rectified-flow 变体处于或接近全局排名顶部。这些变体总体具有竞争力,而不同设置在少步和多步评估中表现出各自优势。带线性调度的传统 epsilon 预测也很强,但总体落后于领先的 lognormal 变体。Lognormal RF 加权始终位于最强的整体变体之中。某些 lognormal 设置在 5 步时排名很高,但在 50 步时表现不同。基于 mode 的 RF 变体具有竞争力,但略逊于最佳 lognormal 变体。带线性调度的 epsilon 预测仍是强基线。
在 25 个采样步数下比较各变体时,rf/lognorm(0.50, 0.60) 设置在每个数据集上都给出最强的 CLIP 分数,而 edm(-1.20, 1.20) 给出最佳 FID 分数。这表明文本对齐与图像保真度之间存在权衡。其他变体位于这两个极端之间,其中 v/cos 在 v-prediction 变体中 FID 表现特别好。rf/lognorm(0.50, 0.60) 达到最高 CLIP 分数,表明与文本提示的对齐更强。edm(-1.20, 1.20) 获得最低 FID 分数,并在 CLIP 上仍具竞争力,表明其在保真度和对齐之间具有较强平衡。
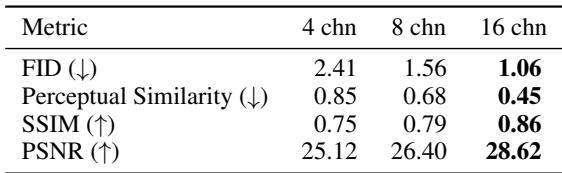
在将下采样因子固定为 8 的同时,将潜变量通道数从 4 增加到 16,能一致地提升 autoencoder 重建效果。更高通道配置显示更低的 FID 和感知相似度,以及更高的 SSIM 和 PSNR。这表明更宽的潜空间为 latent diffusion 模型提供了更强的重建上限。更多潜变量通道在所有报告指标上都改善了重建质量。16 通道配置在整体保真度和相似度上表现最佳。
在 GenEval 上,合成标题与原始标题各占 50% 的混合训练相比仅使用原始标题训练,能提升文本到图像性能。提升在需要空间定位、计数、属性分配和双物体场景的组分类任务中最明显,而简单物体和颜色评估仍普遍较高。将合成标题与原始标题共同训练,可提升整体文本到图像提示符合度。混合标题设置在更难的组分类和空间提示类别上获益最大。原始标题在简单物体和颜色任务上仍表现强劲。
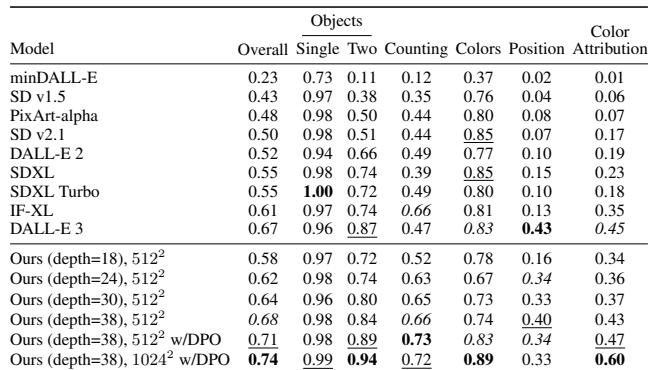
在 GenEval 上,最大训练模型被报告取得最强整体提示理解性能,超过当前开放模型和 DALLE-3。比较显示,单物体生成在各模型中相对较强,而计数、空间定位和属性绑定仍更具挑战性,通常得分较低。随着方法改进和训练分辨率提升,最大模型取得最佳整体结果,并在多数类别中表现强劲。最大模型被报告在整体 GenEval 性能上超过当前开放模型和 DALLE-3。单物体生成通常是比较模型中最强的类别。计数、位置和颜色属性绑定对许多模型仍然具有挑战性。
实验评估了不同时间步加权预测公式、潜变量容量、标题混合以及基于 diffusion 的图像生成模型扩展。Lognormal rectified-flow 变体总体最强,而线性 epsilon 调度仍具竞争力。在固定采样步数下的比较揭示了文本对齐与图像保真度之间的权衡。更宽的潜空间一致地改善重建质量,将合成标题与原始标题混合可增强提示符合度,尤其在组分类和空间任务上。将模型扩展到最大训练规模并提高分辨率,可获得最佳整体提示理解,但计数、空间定位和属性绑定仍具有挑战性。