Command Palette
Search for a command to run...
基于数据分布比值估计的离散扩散建模
基于数据分布比值估计的离散扩散建模
Aaron Lou Chenlin Meng Stefano Ermon
摘要
扩散模型在诸多生成式建模任务中取得了突破性的性能,但在自然语言等离散数据领域仍表现欠佳。关键问题在于,标准扩散模型依赖于成熟的得分匹配理论,而将该理论推广至离散结构的工作未能带来同等的性能提升。本文通过提出得分熵这一新颖损失函数来弥合这一差距,该损失将得分匹配自然地扩展至离散空间,能够无缝集成以构建离散扩散模型,并显著提升性能。实验上,我们在标准语言建模任务上测试了得分熵离散扩散模型(SEDD)。在可比模型规模下,SEDD 优于现有语言扩散范式(困惑度降低 25-75%),且与自回归模型具有竞争力,特别是性能超越了 GPT-2。此外,与自回归模型相比,SEDD 无需温度缩放等分布退火技术即可生成忠实文本(生成困惑度比未经退火的 GPT-2 好约 6-8 倍),能够在计算量与质量之间进行权衡(网络评估次数减少 32 倍即可达到相近质量),并支持可控填充(质量与核采样相当,同时支持除从左到右提示之外的其他生成策略)。
一句话总结
论文提出 score entropy,这是一种将 score matching 扩展到离散空间的损失,并构建 Score Entropy Discrete Diffusion (SEDD),相较此前 diffusion 方法将 perplexity 降低 25-75%,在语言建模上超过 GPT-2,并在不依赖分布退火的情况下生成忠实文本。
核心贡献
- Score Entropy Discrete Diffusion (SEDD) 被引入作为一种面向语言的 discrete diffusion 模型,由 concrete score 参数化,并使用一种新颖的 score entropy 损失训练,该损失将 score matching 扩展到离散 token 空间。
- 该方法用有原则的 denoising score entropy 目标替代高方差的隐式 score entropy 和先前的启发式训练目标,实现更高效、可扩展的训练。
- 在标准语言建模任务上,SEDD 相较现有语言 diffusion 模型将 perplexity 降低 25% 到 75%,超过 GPT-2,实现比 GPT-2 大约好 6 到 8 倍的未退火生成 perplexity,并且可在网络评估次数减少 32 倍的情况下匹配质量,同时支持可控 infilling。
引言
深度生成模型现已支持强大的文本生成和问答,但尽管存在逐 token 采样慢、可控性有限,以及依赖 nucleus sampling 等采样技巧等问题,自回归 transformer 仍是主要的竞争方法。早期的基于 diffusion 的语言模型,尤其是 discrete diffusion 方法,由于训练目标常常不稳定或不适合离散数据,并且在不依赖大量经验修复的情况下通常在 likelihood 和样本质量上落后于自回归模型。作者引入 Score Entropy Discrete Diffusion 模型,通过概率比并使用新的 score entropy 损失学习反向 diffusion 过程,从而得到一种有原则且可扩展的方法,改进语言建模,实现高质量未退火采样,并支持灵活的生成和 infilling。
方法
作者利用 score entropy 参数化训练 discrete diffusion 模型,学习正的、基于比率的 score,而不是直接建模归一化的转移概率。核心对象是 score 网络 sθ(x,t),其坐标 sθ(x,t)y 旨在近似 concrete score 比率
sθ(x,t)y≈pt(x)pt(y),y=x.这意味着模型学习在含噪边际 pt 下,备选状态 y 相对于当前状态 x 更可能或更不太可能的程度。由于这些比率严格为正,训练目标被设计为 score entropy 损失,自然地结合正性和凸性。对于分布 p 和非负权重 wxy,score entropy 的形式为
LSE=Ex∼py=x∑wxy(sθ(x)y−p(x)p(y)logsθ(x)y+K(p(x)p(y))),其中
K(a)=a(loga−1)作为确保非负性的归一化常数。该损失由带有负对数生成器的 Bregman 散度构建,从而获得非负性和凸性等理想性质。在完整支撑和正权重下,最小化解能恢复真实 score 比率,意味着学习到的 score 满足
sθ∗(x)y=p(x)p(y).该方法通过使用 score entropy 的 denoising 版本,将这一目标扩展到可扩展的 discrete diffusion。当中间分布 p 通过转移核 p(⋅∣x0) 扰动干净数据分布 p0 生成时,score entropy 可以等价地通过以下方式训练
LDSE=Ex0∼p0x∼p(⋅∣x0)y=x∑wxy(sθ(x)y−p(x∣x0)p(y∣x0)logsθ(x)y).该表述具有实用性,因为一次 Monte Carlo 步骤会采样一个干净点 x0,扰动它得到 x,然后在 x 处评估 score 网络一次。输出 sθ(x) 包含许多可能扰动 y 的 score 估计,因此训练步骤不需要为每个候选状态重复评估。
在 diffusion 建模中,边际 pt 本身是通过随时间变化的前向转移对基础分布 p0 的扰动。因此,该方法在损失内部使用可处理的 conditional transition pt∣0,将 p(x∣x0) 和 p(y∣x0) 替换为 pt∣0(xt∣x0) 和 pt∣0(y∣xt)。这产生一个 diffusion 加权的训练目标,沿着前向 diffusion 轨迹直接优化模型。
同一 score 基础的构造也支持基于 likelihood 的训练和评估。学习到的 score 网络通过将真实 score 比率替换为学习到的比率,定义一个带参数的反向转移矩阵。对于非对角元素,反向速率为
Qtθ(y,x)=sθ(x,t)yQt(x,y),x=y,其对角元素被选择为使每一行的和为零。由此得到的反向时间密度满足如下形式的微分方程
dtdpT−tθ=QT−tθpT−tθ,pTθ=pbase.这给出了数据点负 log likelihood 的上界:
−logp0θ(x0)≤LDWDSE(x0)+DKL(pT∣0(⋅∣x0)∥pbase),其中 LDWDSE 是一个 diffusion 加权的 denoising score entropy。这对语言建模特别有用,因为 likelihood 和 perplexity 仍然是核心评估指标。
对于序列数据,状态被分解为 d 个 token,每个 token 取 n 个值之一。完整的转移矩阵会呈指数级增长,因此该方法使用稀疏、结构化的转移核,独立扰动 token。非零转移一次只改变一个 token:
Qt(x1…xi…xd,x1…xi…xd)=Qttok(xi,xi).由于这种稀疏性,只需要 Hamming 距离为 1 的序列之间的 score 比率。因此,score 网络实现为一个序列到序列映射
sθ(x,t)∈Rd×n,其中元素
sθ(x,t)i,xi≈pt(x1…xi…xd)pt(x1…xi…xd)将当前序列与将 token i 替换为 xi 后形成的序列进行比较。
因为 token 被独立扰动,整个序列的前向转移可以分解:
pt∣0seq(x∣x)=i=1∏dpt∣0tok(xi∣xi).对于 token 转移,该方法设置为
Qttok=σ(t)Qtok,其中 σ(t) 是噪声调度。定义累积噪声
σ(t)=∫0tσ(s)ds,token 转移概率可以从矩阵指数计算,而不需要数值积分:
pt∣0tok(⋅∣x)=the x-th column of exp(σ(t)Qtok).对于大型词表,显式存储并对完整 token 转移矩阵求矩阵指数不可行。因此该方法使用结构化 token 转移核。均匀转移核以对称方式耦合所有 token 值,并且元素与全 1 的非对角项成比例。吸收转移核引入一个 mask token,允许每个非 mask token 转移到 mask 状态,而 mask 状态保持吸收状态。这些结构使转移概率和 score 加权损失计算成本很低,从而使训练能以与标准自回归序列建模相当的速度和内存占用进行。
训练完成后,学习到的 score 被用于模拟反向 diffusion 过程。简单的 Euler 式反向步骤每一步只更新一个 token,对长序列效率很低。该方法转而使用 τ-leaping 策略,同时更新所有 token 位置。每一步中,token i 按照受学习到的 score 影响的局部概率进行更新:
δxti(xt−Δti)+ΔtQttok(xti,xt−Δti)sθ(xt,t)i,xt−Δti.这使得每个位置可独立采样,同时完整序列条件仍保留在 score 估计中。
该方法通过使用 Tweedie 定理的离散类比进一步改进这一采样方案。由于学习到的 score 近似当前边际的比率,它们提供关于最优反向时间去噪分布的信息。所得的 Tweedie τ-leaping 更新将基本局部转移概率替换为
(exp(−σtΔtQtok)sθ(xt,t)i)xt−Δtiexp(σtΔtQtok)(xti,xt−Δti),其中
σtΔt=σ(t)−σ(t−Δt).该更新保留 τ-leaping 的独立逐 token 结构,同时纳入 score 模型提供的最优去噪解释。当学习到的 score 完美时,在最小化与真实反向转移之间的散度方面,该采样规则在 τ-leaping 策略中是最优的。
同一 score 表述也支持任意 prompting 和 infilling,而无需重新训练条件模型。对于已填充索引集合 Ω 和未填充索引集合 Ω,条件分布
pt(xΩ∣xΩ=y)可以通过 Bayes 法则处理。条件 score 比率可归约为在完成后的序列上、使用固定上下文评估的无条件 score 比率:
pt(xΩ=z∣xΩ=y)pt(xΩ=z′∣xΩ=y)=pt(x=z⊕Ωy)pt(x=z′⊕Ωy).这里,⊕Ω 表示未填充模式和固定上下文的拼接。采样时,已填充位置被冻结,只更新未填充位置,从而使同一个学习到的无条件 score 网络可以执行灵活的条件生成。
实验
实验在语言建模和生成上评估 SEDD,使用在匹配的数据、tokenizer 和模型规模下训练的 transformer 基 diffusion 变体。在字符级和词级语料上的 likelihood 结果显示出很强的竞争力,其中 SEDD Absorb 超过此前的 diffusion baseline,并在若干 zero-shot 任务上接近或超过 GPT-2 的 perplexity。生成评估进一步验证了高质量无条件采样、快速步数预算权衡,以及无需显式自回归归纳的强 infilling 和条件 prompting。总体而言,结果表明 SEDD 在建模质量和生成灵活性上都优于现有 discrete diffusion 方法。
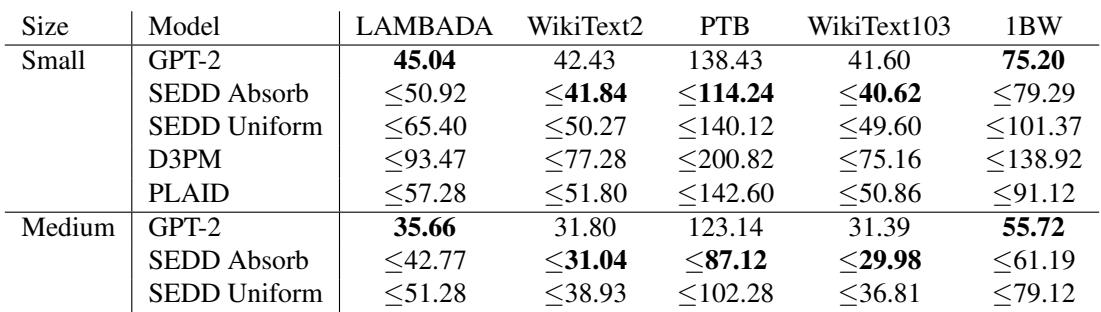
在 zero-shot 无条件语言建模中,带有吸收转移的 SEDD 模型在被比较的 diffusion baseline 中提供最强 perplexity。它在大多数标准数据集上匹敌或超过 GPT-2,支持这样的论断:非自回归 diffusion 模型可以达到与现代自回归模型相当的 perplexity 质量。比较还显示相对此前语言 diffusion 方法的明显优势。吸收型 SEDD 比均匀型 SEDD 和更早的语言 diffusion baseline 给出更好的 perplexity。吸收型 SEDD 在多数 zero-shot 任务上优于 GPT-2,同时在其他任务上保持竞争力。
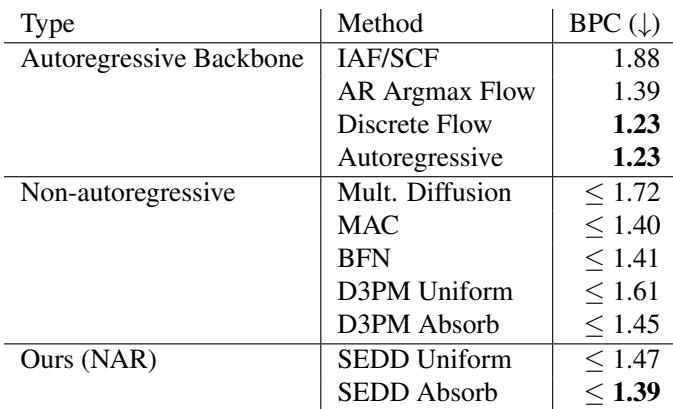
在 text8 的每字符比特数语言建模中,SEDD 给出最强的非自回归结果,同时接近领先的基于自回归的方法。它相比此前的 discrete diffusion 模型(例如 D3PM)有显著提升,并优于其他非自回归 baseline。SEDD 在 text8 上取得最佳非自回归性能。SEDD 仅略落后于自回归以及基于自回归的 flow 方法。尽管共享 discrete diffusion 原则,SEDD 相对 D3PM 有显著提升。
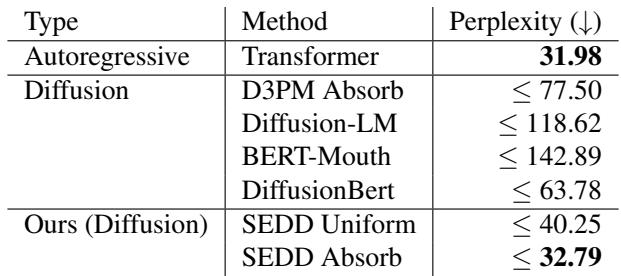
SEDD 在 One Billion Words 数据集上取得最强的 diffusion 模型 perplexity,并接近自回归 transformer 基准。由于 diffusion 结果是上界,这表明 SEDD 可以有效匹敌自回归模型的 likelihood 质量,同时显著超过此前 diffusion baseline。SEDD 产生的 perplexity 低于所有比较的 diffusion baseline,并相对 D3PM 等方法有大幅优势。SEDD 与自回归 transformer 的 perplexity 差距非常小,表明其基于 likelihood 的性能具有竞争力。该结果被作为证据,说明非自回归语言模型可以在 perplexity 上匹敌一个知名自回归模型。
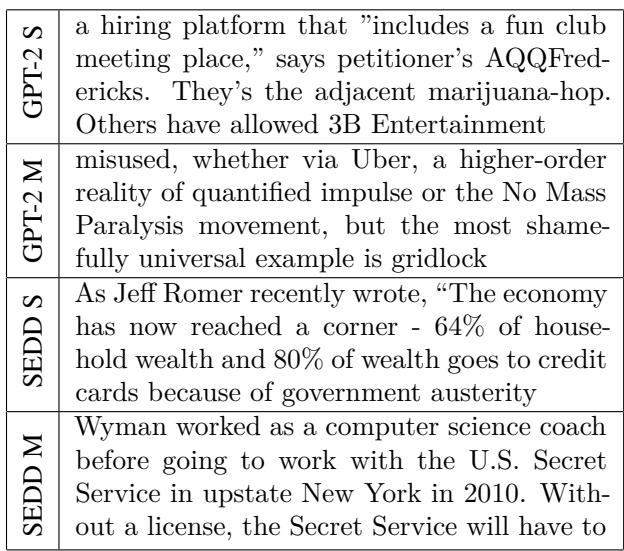
该比较使用 perplexity 评估小型模型无条件文本生成,表明 SEDD 样本优于 GPT-2 样本。SEDD 以少得多的网络评估次数达到有竞争力的质量,更长的采样步数预算可带来进一步改进。生成的示例也显示出从碎片化 GPT-2 文本到更连贯 SEDD 文本的趋势。在生成文本 perplexity 上,SEDD small 和 medium 模型优于 GPT-2 small 和 medium 模型。使用更多 SEDD 采样步骤遵循可预测的质量与步骤数权衡,并改进结果。示例输出表明 SEDD 比对应 GPT-2 样本生成更连贯的文本。
定性样本表明,条件生成可以在开头、末尾、中间或以分开的片段形式使用 prompt 文本。相关实验表明,这种灵活 prompting 可与有竞争力的语言生成质量兼容,包括相对比较 baseline 的强标准 prompting 结果。这一点值得注意,因为该方法不使用分布退火,也不使用显式的从左到右架构偏置。prompt token 可以放在开头、末尾、中间或分割位置。标准生成以及带有开头和结尾上下文的 infilling 都受到支持。标准 prompting 与比较的 baseline 相当,并在某一情况下更好。
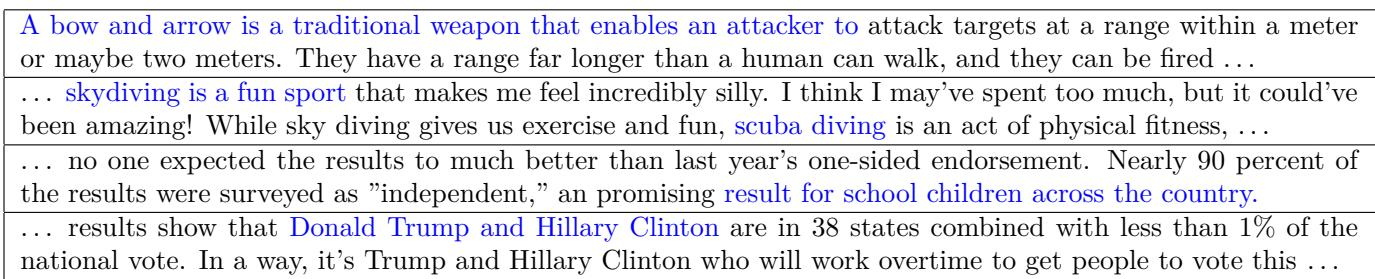
实验通过标准语料上的 zero-shot 无条件语言建模和小型模型文本生成评估 SEDD,将其 perplexity 和采样输出与 GPT-2、自回归 baseline 以及此前 discrete diffusion 模型比较。在这些设置中,吸收型 SEDD 被证明优于更早的 diffusion baseline,并在 likelihood 上接近或匹敌自回归性能,同时以更少的网络评估次数提供比 GPT-2 更连贯的生成文本。条件实验进一步证明,在不带从左到右架构偏置的情况下支持灵活 prompt 放置和 infilling,并获得有竞争力的生成质量。