Command Palette
Search for a command to run...
深度强化学习的异步方法
深度强化学习的异步方法
Volodymyr Mnih Adrià Puigdomènech Badia Mehdi Mirza Alex Graves Tim Harley Timothy P. Lillicrap David Silver Koray Kavukcuoglu
摘要
我们提出了一种概念简洁且轻量的深度强化学习框架,该框架采用异步梯度下降来优化深度神经网络控制器。我们给出了四种标准强化学习算法的异步变体,并表明并行的执行者-学习器对训练具有稳定作用,使得所有四种方法均能成功训练神经网络控制器。其中性能最优的方法——一种异步 actor-critic 变体——在 Atari 游戏领域超越了当时的最先进水平,且在单个多核 CPU 上仅用一半的训练时间(而非 GPU)。此外,我们还表明异步 actor-critic 在多种连续运动控制问题上同样有效,并成功完成了一项基于视觉输入在随机三维迷宫中导航的新任务。
一句话总结
来自蒙特利尔学习算法研究所(MILA)的研究人员提出一种轻量级框架,该框架使用异步梯度下降进行深度强化学习,并给出四种强化学习算法的异步变体,其中并行的 actor-learner 可稳定神经网络训练。其异步 actor-critic 方法在 Atari 任务上超越当时最优结果,同时只需单个多核 CPU 训练一半时间,而不需要 GPU。
核心贡献
-
论文引入一种轻量级异步深度强化学习框架,使用异步梯度下降优化深度神经网络控制器,并包含四种标准强化学习算法的异步变体。
-
该框架表明,并行 actor-learner 更新共享模型可稳定训练,使神经网络控制器能够在基于价值和基于策略的方法、off-policy 与 on-policy 算法、离散和连续控制域中成功学习。
-
异步 advantage actor-critic 方法在 16 个 CPU 核上达到 Atari 的最优性能,训练时间仅为 Nvidia K40 GPU 上 DQN 的一半,同时在连续电机控制任务和随机 3D 迷宫中的视觉导航上也取得成功。
引言
深度强化学习很重要,因为它能够直接从高维观测中学习控制策略,例如 Atari 游戏和连续电机控制任务。然而,将在线强化学习与深度神经网络结合往往不稳定,因为在线数据之间存在相关性且非平稳。早期方法使用经验回放来批处理和去相关数据,但这要求 off-policy 算法,并增加内存和计算成本。其他并行系统提升了训练速度,但依赖分布式部署或回放记忆。作者提出一种异步强化学习框架,其中多个 agent 在并行的环境实例中行动并更新共享模型,从而产生更多样、更平稳的数据,实现稳定学习。结果表明,这使基于深度网络的稳健 on-policy 和 off-policy 算法成为可能,包括异步 advantage actor-critic(A3C),并可使用标准多核 CPU。
方法
异步 RL 框架
作者利用一种异步强化学习框架,其中多个 actor-learner 线程在单台机器上并行运行。每个线程与自身的环境副本交互,根据局部探索策略选择动作,在若干时间步上累积梯度,然后将这些梯度应用到共享的网络参数上。整体设计让 learner 和 actor 留在同一台机器上,从而消除分布式参数服务器的通信开销,并实现 Hogwild 风格的异步更新。这使训练深度神经网络策略变得可行,不需要大型硬件需求或回放记忆。
参见文本中描述的框架:每个 actor-learner 独立运行,并周期性地对共享模型进行在线更新。通过让每个线程以不同方式探索,不同 actor-learner 施加的更新方向不太可能在时间上相关。这样,并行探索提供了与基于 DQN 的训练中经验回放类似的稳定作用。该框架包含 one-step Q-learning、one-step Sarsa、n-step Q-learning 和 advantage actor-critic 的变体,每个变体都围绕相同的异步 actor-learner 机制构建。
对于 one-step Q-learning 和 one-step Sarsa,每个 actor-learner 观察一个状态,使用探索策略采取动作,接收奖励,并计算时序差分损失的梯度。使用缓慢变化的目标网络来计算稳定目标。在 Q-learning 情况下,目标值由下一状态的目标网络值经折扣形成。在 one-step Sarsa 情况下,目标使用实际采取的下一动作:
r+γQ(s′,a′;θ−)其中 s′ 是下一状态,a′ 是在 s′ 中选择的动作,θ− 表示目标网络参数。在应用之前会在多个步骤上累积梯度。这种累积行为类似 mini-batch,并降低多个 actor-learner 互相覆盖更新的概率。该方法也允许在计算效率和数据效率之间进行权衡。
对于 n-step Q-learning,算法以前向视图运行。每个 actor-learner 不使用 eligibility traces 或后向视图,而是先使用其探索策略执行动作,最多执行 tmax 步,或直到到达终止状态。这会产生一条包含多个奖励、状态和动作的短轨迹。agent 然后计算该轨迹中每个状态动作对的 n-step return。第一个状态获得最长的可用 n-step return,下一个状态获得较短的 n-step return,依此类推,从而得到一组具有不同 horizon 的更新。这些累积的更新会在一次共享梯度步骤中一起应用。
advantage actor-critic 变体常称为 A3C,维护两个耦合组件:策略 π(at∣st;θ) 和值函数 V(st;θv)。实践中,这两者实现为共享神经网络的两个输出头。通常非输出层是共享的,而一个 softmax 输出为策略产生动作概率,一个线性输出预测状态值。策略和值函数在每 tmax 个动作后或到达终止状态时更新。
策略更新基于 advantage function,它估计一个动作比其状态期望值好多少。使用 n-step returns,advantage 可写为:
A(st,at;θ,θv)=i=0∑k−1γirt+i+γkV(st+k;θv)−V(st;θv)其中 k 是有效 n-step 长度,并以 tmax 为上界。相应的策略梯度具有如下形式:
∇θ′logπ(at∣st;θ′)A(st,at;θ,θv)值函数朝着相同的 n-step returns 训练。常见的 critic 目标为:
LV=21(Rt−V(st;θv))2其中 Rt 表示作为回归目标的 bootstrapped n-step return。
作者还在 actor-critic 目标中加入熵正则项。该项鼓励策略保持随机性,并阻止过早收敛到次优的确定性行为。加入熵正则的完整策略梯度变为:
∇θ′logπ(at∣st;θ′)(Rt−V(st;θv))+β∇θ′H(π(st;θ′))其中 H 是策略熵,β 控制熵奖励的强度。
异步框架支持不同优化设置。作者比较带动量的随机梯度下降、不共享统计量的 RMSProp,以及跨线程共享统计量的 RMSProp。non-centered RMSProp 更新为:
g=αg+(1−α)Δθ2 θ←θ−ηg+ϵΔθ其中所有操作均为逐元素操作,α 是衰减常数,η 是学习率,ϵ 是用于数值稳定性的较小常数。实验发现,在 actor-learner 线程间共享 RMSProp 统计量的变体在异步训练中尤其稳健。
实验
实验在 Atari、TORCS、MuJoCo 和 Labyrinth 上评估该框架,表明异步方法在 CPU 核上训练高效,且 A3C 通常表现最佳,包括更优的 Atari 结果、较强的赛车控制、连续电机任务和视觉迷宫探索。额外分析显示,并行 actor-learner 带来显著加速,one-step 方法也在数据效率上获益,并且算法在不同学习率和初始化下保持稳定和稳健。
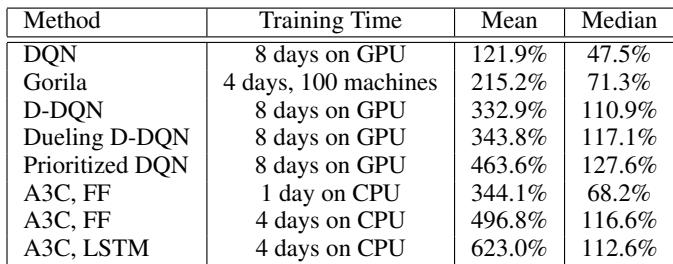
在 57 个 Atari 游戏上,在 CPU 核上训练的异步 advantage actor-critic agent 达到比所列 GPU 训练值方法更高的平均 human-normalized 分数。feedforward 版本随着训练时间增加显著改善,从中等 median 表现接近最强 GPU baseline,同时保持报告中结果的最高平均分数。训练四天的异步 feedforward agent 超过所有所列 GPU 训练 DQN 变体的平均性能。更长的异步训练显著提高 mean 和 median 分数,尤其对 feedforward agent 而言。prioritized DQN baseline 在 median 分数上仍然很强,接近训练四天的异步 feedforward agent。
在四种异步方法中,随着并行 actor-learner 数量增加,训练加速比一致提高,在 16 线程时增益最大。one-step Q-learning 和 one-step SARSA 扩展性尤其好,显示出超线性加速,表明存在超出纯并行化的数据效率提升。随着并行线程数增加,所有方法都取得显著加速。one-step Q-learning 和 one-step SARSA 比 n-step Q 和 A3C 扩展更强。额外的并行 actor-learner 有助于 one-step 方法,可能是通过降低 bias。
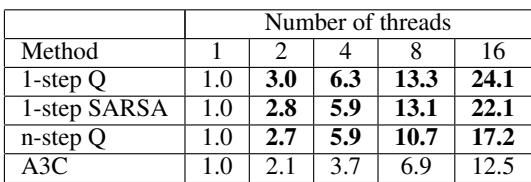
实验通过大规模 Atari 基准测试以及使用多个并行 actor-learner 的扩展性研究,评估异步强化学习方法。Atari 结果表明,异步 CPU 训练可实现与所列 GPU 训练值方法相当或更强的总体性能,其中更长时间训练尤其改善 feedforward agent。扩展性研究证实,额外的并行 actor-learner 会持续提高训练速度,其中 one-step 变体受益最大,并表现出可能反映超出纯并行化带来的性能提升的增益。