Command Palette
Search for a command to run...
信赖域策略优化
信赖域策略优化
John Schulman Sergey Levine Philipp Moritz Michael Jordan Pieter Abbeel
摘要
本文提出了一种具有单调改进保证的控制策略优化方法。通过对具有理论保证的方案进行若干近似,我们开发了一种实用算法,称为信赖域策略优化(Trust Region Policy Optimization, TRPO)。该算法能够有效优化大型非线性策略,例如神经网络。实验表明,TRPO 在多种任务上表现出稳健的性能:包括学习模拟机器人的游泳、跳跃和行走步态,以及以屏幕图像作为输入来游玩雅达利游戏。尽管 TRPO 的近似偏离了理论,它通常仍能给出单调改进,且对超参数的调整需求极少。
一句话总结
加州大学伯克利分校的研究人员提出信赖域策略优化(TRPO),这是一种实用算法,可在优化大型非线性策略(例如神经网络)时近似一种具有理论依据的机制,保证单调改进,并在机器人运动任务和 Atari 游戏上几乎无需调整超参数即展现出稳健性能。
核心贡献
-
引入信赖域策略优化(TRPO),这是一种优化大型非线性随机策略(包括神经网络策略)的实用算法;它在 KL 散度信赖域约束下更新策略,同时优化期望回报的局部替代目标。
-
分析 KL 散度惩罚策略更新,并证明信赖域方法可以保证策略的单调改进;该分析还将策略梯度和策略迭代方法视为在信赖域约束下优化目标时的极限情形。
-
在模拟机器人游泳、跳跃和行走以及使用原始屏幕图像的 Atari 游戏中展示了强实证结果,几乎无需超参数调整,并观察到单调改进。
引言
对于控制、机器人和游戏领域的强化学习,策略优化是核心,其目标是改进大型且表达能力强的策略,例如神经网络。已有方法包括策略迭代、策略梯度方法和无导数搜索,但实践中基于梯度的方法常常在表现上不及随机搜索,尽管具有更好的理论样本复杂度;而且朴素更新可能不稳定,因为策略变化会以复杂方式改变状态访问分布。作者引入信赖域策略优化,这是一种可扩展算法,在优化替代优势目标的同时用 KL 散度信赖域约束策略更新,从而获得单调改进保证,并给出实用的单路径和藤蔓变体。该方法可以训练大型非线性策略,并成功学习运动控制和 Atari 控制任务,同时在共同的信赖域框架下统一策略梯度和策略迭代。
方法
方法架构与优化流程
作者利用面向随机策略优化的信赖域框架。核心思想是用局部有效的替代目标替换原始策略性能目标,并只在该替代目标仍对真实目标保持可靠上界或下界的区域内改进策略。这将策略迭代转化为约束优化问题,可应用于神经网络等参数化策略。
理论基础是单调改进保证。对于上一策略 πi,方法构造如下替代函数
Mi(π)=Lπi(π)+CDKLmax(πi,π),其中 Lπi(π) 是基于优势的替代损失,DKLmax 约束旧策略和新策略之间最大的状态相关 KL 散度。真实目标被该替代函数界定,并且在当前策略处相等。因此,若每次更新都降低 Mi,真实目标就会单调改进。
对于参数化策略 πθ(a∣s),作者将该更新改写为关于参数 θ 的形式。涉及 CDKLmax 的理论惩罚项会产生非常小且难以调整的更新。相反,该方法使用如下信赖域约束:
θminimizeLθold(θ)subject toDKLρθold(θold,θ)≤δ,其中
DKLρ(θ1,θ2)=Es∼ρ[DKL(πθ1(⋅∣s)∥πθ2(⋅∣s))].该约束控制旧策略所访问状态上旧策略和新策略之间的平均 KL 散度。它避免在每个状态上单独施加散度界,同时仍然阻止大幅且不安全的策略变化。
随后从样本估计该优化问题。从替代损失出发,目标可以写为
θminimizeEs∼ρθold,a∼q[q(a∣s)πθ(a∣s)Qθold(s,a)]约束为
Es∼ρθold[DKL(πθold(⋅∣s)∥πθ(⋅∣s))]≤δ.这里,Qθold 替代优势函数,因为二者仅相差一个不改变优化方向的状态相关常数。动作期望通过对提议分布 q(a∣s) 的重要性采样处理。
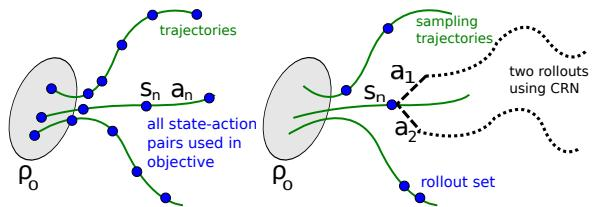
该方法提供两种样本估计方案。在单路径方案中,当前策略生成一条或多条轨迹,并将在这些轨迹中遇到的每个状态动作对用于目标。对于每个访问到的对,Q 值根据轨迹上未来成本或回报进行折扣估计得到。该方案不要求将环境重置到任意状态,因此适合真实物理系统。
在藤蔓方案中,当前策略首先生成较长轨迹形成主干路径。从访问到的状态中选择一个子集作为展开集合。对于该集合中的每个状态 sn,方法从分布 q 中采样 K 个动作,并对每个采样动作执行短展开以估计
Q^θold(sn,an,k).通过在 K 次展开之间使用公共随机数来降低这些估计的方差,即在可能的情况下使用同一噪声序列。对于连续动作问题,旧策略本身被用作 q;对于离散问题,通常更倾向于使用均匀分布或广泛探索的 q。单个展开状态对替代损失的贡献通过自归一化重要性采样估计量估计
Ln(θ)=∑k=1Kπθold(an,k∣sn)πθ(an,k∣sn)∑k=1Kπθold(an,k∣sn)πθ(an,k∣sn)Q^(sn,an,k).该估计量先对采样动作求平均,再对展开状态进一步求平均,以近似完整替代损失。藤蔓方法相比单路径估计产生更低方差的优势估计,但它需要更多模拟器调用,并且要求访问任意状态的重置能力。下面图示对比了这两种估计过程:
实际训练循环反复执行三个步骤。首先,使用单路径估计器或藤蔓估计器收集状态动作对及其价值的蒙特卡洛估计。其次,构造约束替代目标和平均 KL 约束的经验版本。第三,近似求解约束优化问题以更新策略参数。优化器使用由 KL 散度解析 Hessian 矩阵构成的 Fisher 信息矩阵,
Aij=N1n=1∑N∂θi∂θj∂2DKL(πθold(⋅∣sn)∥πθ(⋅∣sn)),而不是通过采样策略梯度的外积进行估计。这种解析构造在每个状态上对动作积分,避免存储稠密 Hessian 矩阵或大批次中的全部策略梯度。更新通过共轭梯度步和随后的线搜索获得,其中线搜索确保最终策略满足 KL 信赖域界。
实验
实验在 MuJoCo 运动和 Atari 图像控制上比较单路径 TRPO 和藤蔓 TRPO,包括消融和基线,检验采样行为、KL 约束的影响以及可扩展性。TRPO 生成高质量运动步态,并优于以往的策略优化方法;这表明固定 KL 约束比固定惩罚项更稳健,也表明平均 KL 近似是有效的。在 Atari 上,两种变体都能从原始图像学习合理策略,展示了在大尺度部分可观测任务中的广泛适用性。
Atari 结果表明,两种 TRPO 变体都能从原始图像学习非平凡控制,并在七个游戏上取得合理得分。它们并未在所有游戏上超越所有已有方法,但在使用通用策略搜索方法而非 Atari 专用方法的同时,在若干任务上保持竞争力。总体而言,单路径 TRPO 似乎比藤蔓 TRPO 更具持续竞争力,后者在不同游戏间波动更大。两种 TRPO 变体在 Atari 游戏中的得分均明显高于随机行为。TRPO 在某些游戏中与已有方法相当,但在另一些游戏中较弱。在这些评估中,单路径 TRPO 通常比藤蔓 TRPO 更稳定。
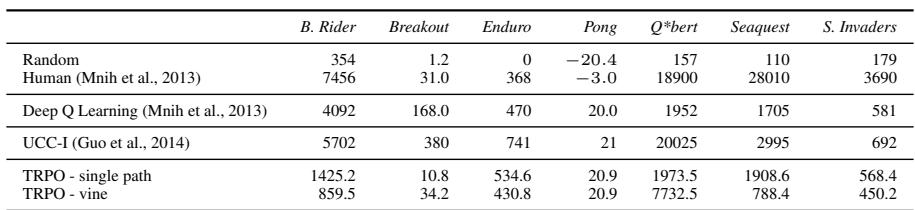
Atari 实验评估了在七个游戏中基于原始像素观测训练的信赖域策略优化变体。结果表明,两种变体都能学习明显高于随机水平的有意义控制策略,并在若干任务上与已有方法保持竞争力,尽管并非全面超越专用方法。单路径 TRPO 在不同游戏中通常比波动更大的藤蔓 TRPO 更稳定、更具竞争力。