Command Palette
Search for a command to run...
基于正则化流的变分推断
基于正则化流的变分推断
Danilo Jimenez Rezende Shakir Mohamed
摘要
近似后验分布的选择是变分推断的核心问题之一。变分推断的大多数应用为了实现高效推断,采用简单的后验近似分布族,侧重于平均场或其他简单结构化的近似。这种限制对变分方法所得推断的质量产生了显著影响。我们提出了一种新的方法来构造灵活、任意复杂且可扩展的近似后验分布。我们的近似分布通过正则化流构造而成:通过对简单初始密度施加一系列可逆变换,将其转化为更复杂的分布,直至达到所需的复杂程度。我们利用正则化流这一视角,发展了有限流和无穷小流的分类体系,并为构造丰富后验近似的方法提供了统一视角。我们证明了,使后验分布更好地匹配真实后验的理论优势,与摊销变分方法的可扩展性相结合,能够显著提升变分推断的性能与适用性。
一句话总结
Google DeepMind 提出在变分推断中,通过 normalizing flows 指定灵活且复杂度可任意设定的近似后验分布;该方法通过对简单初始密度施加一系列可逆变换构建 normalizing flows,统一了有限流与无穷小流类别,并表明当与摊销变分方法结合时,可提升推断质量。
核心贡献
-
提出在变分推断中使用 normalizing flows 指定近似后验分布。该方法通过可逆映射将简单初始密度转换为复杂的非高斯后验,从而得到更紧的修正变分下界,且仅增加线性时间的附加项。
-
发展了有限流与无穷小流两类 normalizing flows,并将相关后验近似方法统一视为特殊的流类型;文章还表明,在渐近情形下,无穷小流具有足够表达力,能够恢复真实后验分布。
-
实验表明,在摊销变分推断中,使用 general normalizing flows 和高效 Monte Carlo gradient estimation 时,系统性地优于其他后验近似方法;在评估问题上提升性能与适用性,同时保留可扩展性。
引言
变分推断是可扩展概率建模中的核心方法,支持用于文本分析、分类、图像生成以及物理或化学过程建模的大型系统。其实用能力受到后验近似选择的影响,因为简单类,例如 mean field 分布,往往无法表示真实后验,并可能低估不确定性或使参数估计产生偏差。作者利用 normalizing flows 构建灵活的近似后验,通过可逆映射转换简单分布,从而以更低的计算开销获得更紧的变分界,并得到一类能够在渐近情形下恢复真实后验的近似分布。
方法
作者将变分推断表述为在近似后验上的优化问题。对于观测 x、潜变量 z 和模型参数 θ,边际似然需要对 z 进行积分,而这通常难以计算。因此,作者引入变分后验 qϕ(z∣x),并优化 log marginal likelihood 的下界。所得下界常以自由能形式表示:
F(x)=Eqϕ(z∣x)[logqϕ(z∣x)−logpθ(x,z)].等价地,证据下界是该自由能的负值。它包含一项 reconstruction term 和一项 regularization term,后者将近似后验推向 prior。
作者使用 minibatches 和 stochastic gradient estimation 对该优化过程进行扩展。对于连续潜变量,作者使用 reparameterization 通过采样噪声计算梯度。若变分后验是高斯分布,则
z=μ+σϵ,ϵ∼N(0,I),其中 μ 和 σ 由神经网络产生。这使得采样操作可微,并允许使用标准 backpropagation 估计 expected log likelihood 的梯度。
核心架构模块是 inference network。与其为每个数据点分别优化变分参数,模型学习一个全局 recognition network,直接将观测映射到变分参数。这实现推断摊销,意味着该网络能够泛化到训练数据和测试数据。inference network 与深度潜在高斯生成模型配对。生成模型包含一个连续潜变量层级结构,
p(x,z1,…,zL)=p(x∣f0(z1))l=1∏Lp(zl∣fl(zl+1)),其中潜在依赖关系由确定性神经网络指定,先验为标准高斯分布。因此完整系统表现得像 encoder decoder 架构:inference network 将观测编码为潜变量,生成网络将这些潜变量解码回观测空间。
参见下方的框架图:
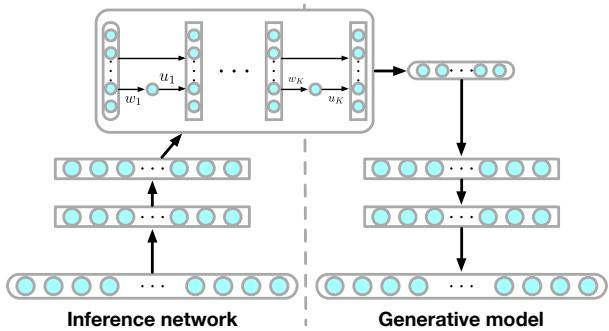
该系统左侧将观测映射为近似分布的参数,右侧表示生成模型,该模型在训练过程中接收潜变量样本。
为提高近似后验的灵活性,作者应用 normalizing flows。flow 从一个简单初始密度,例如高斯分布,开始,并重复应用可逆变换。若变换为 f1,…,fK,则最终潜变量样本为
zK=fK∘fK−1∘⋯∘f1(z0),变换后的密度由 change of variables rule 给出:
logqK(zK)=logq0(z0)−k=1∑Klogdet∂zk∂fk.即便基础密度很简单,该构造也能使变分后验呈现多峰、偏斜或其他复杂形态。
为支持可扩展推断,作者使用 Jacobian determinants 可在线性时间内计算的变换。一类是 planar flow,
f(z)=z+uh(w⊤z+b),其中 h 是平滑非线性函数,w、u 和 b 是可学习参数。该行列式计算为
det∂z∂f=1+u⊤h′(w⊤z+b)w,这仅需要内积运算,并且在潜维度 D 上按 O(D) 扩展。planar flows 会在超平面附近扩展或收缩密度。
另一类是 radial flow,
f(z)=z+βh(α,r)(z−z0),其中 r=∥z−z0∥,h(α,r)=1/(α+r),z0、α 和 β 是参数。这些映射会在参考点附近扩展或收缩密度。这些映射的行列式也具有计算成本较低的 closed form expressions。这些变换可以堆叠,将简单基础密度转换为高度结构化后验分布。
如下图所示:
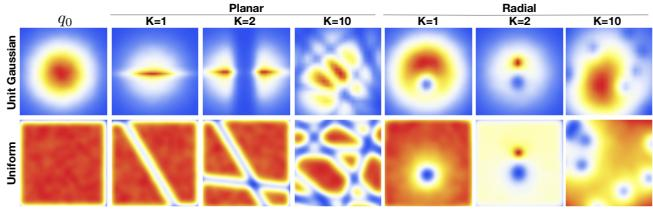
简单初始密度经过一次或多次 flow transformations 后,可以变得细长、多峰或具有空间结构。
基于 flow 的近似后验通过在初始分布下改写变分目标来优化。对于 planar flow,自由能可评估为
F(x)=Eq0(z0)[logq0(z0)−logpθ(x,zK)−k=1∑Klog1+uk⊤ψk(zk)].在 amortized setting 中,inference network 同时输出基础分布 q0 的参数和 flow transformations 的参数。训练期间,系统从基础密度中采样潜变量,将其通过 flow,评估变换后的潜变量密度和 generative likelihood,并分别计算相对于生成模型参数 θ 和推断参数 ϕ 的梯度。更新过程使用 stochastic gradient methods,并使用 preconditioners 为每个参数自适应调整步长。总体开销结合了 inference network 的成本、应用 flow 的成本以及累积 log determinant terms 的成本,使该方法能够与标准 large scale variational inference systems 相竞争。
实验
实验在 synthetic two-dimensional densities 和 image datasets 上评估 deep latent Gaussian models 中的 normalizing-flow 后验近似,并使用 annealed variational training objective。结果表明,flow-based approximations 能够捕捉复杂后验结构,例如多峰性和周期性,并且增加 flow length 可提升近似质量。结果还表明,学到的 planar flows 比 NICE 更节省参数,并能得到更强的后验近似和更好的基于似然性的模型评估。
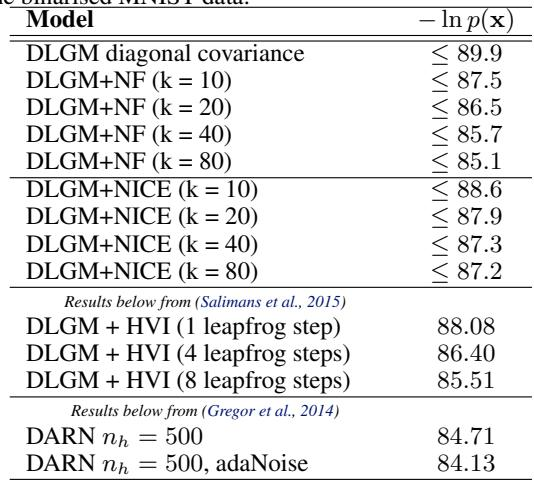
在二值化 MNIST 上,在 deep latent variable models 中使用 normalizing flow approximations 相比 diagonal covariance baseline 会降低测试负 log probabilities。增加 flow length 对两类 flow families 都带来单调改进,且在可比设置下 planar normalizing flows 优于 NICE。normalizing flow models 比 NICE volume preserving models 实现更低负 log probabilities。diagonal covariance baseline 在列出的条目中具有最弱的负 log probability。最佳结果出现在 normalizing flow 的最大 tested flow length 下。
该比较在 CIFAR-10 patches 上使用不同 flow lengths 的 planar normalizing flows 评估 deep latent Gaussian models。增加 flow length 会持续改善所报告的 likelihood metric,支持更好的后验近似。结果显示,在相同 model setup 下,更长的 flows 带来更好性能。更长的 planar normalizing flow lengths 会系统性地改善 CIFAR-10 test performance。更好的 test likelihoods 表明随着 flow length 增加,近似后验更好。比较保持 model setup 固定,仅改变 flow length。
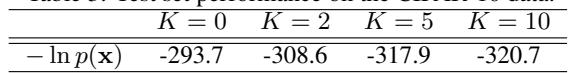
在二值化 MNIST 和 CIFAR-10 patches 上的实验使用 normalizing flow approximations 评估 deep latent variable models,并与 baseline 和 volume-preserving alternatives 进行比较。在 MNIST 上,flow-based models 比 diagonal covariance baseline 和 NICE 提供更好拟合,planar flows 表现更佳,且更长的 flows 带来稳定收益。CIFAR-10 的比较进一步表明,在相同 model setup 下,增加 planar flow length 会系统性地改善 test likelihood 和后验近似。