Command Palette
Search for a command to run...
批归一化:通过减少内部协变量偏移加速深度网络训练
批归一化:通过减少内部协变量偏移加速深度网络训练
Sergey Ioffe Christian Szegedy
摘要
深度神经网络的训练因每层输入分布在训练过程中随前一层参数的变化而改变,变得十分复杂。这一现象导致训练速度降低,需要更小的学习率和精细的参数初始化,且使得使用饱和非线性的模型极难训练。我们将此现象称为内部协变量偏移,并通过归一化层输入来解决该问题。我们的方法将归一化作为模型架构的一部分,并对每个训练小批量执行归一化,从而获得其优势。批归一化允许使用更高的学习率、降低对初始化的要求,在某些情况下还可免除对 Dropout 的需要。将该方法应用于一个最先进的图像分类模型,批归一化仅需 14 分之一的训练步数即可达到相同精度,并以显著优势超越原始模型。通过集成多个批归一化网络,我们在 ImageNet 分类任务上改进了已发表的最佳结果:Top-5 测试错误率达到 4.82%,超过了人类评估者的准确率。
一句话总结
Google 的批归一化(Batch Normalization)方法在模型结构中引入按小批量对每层输入进行归一化,以缓解内部协变量偏移,从而允许更高的学习率,并以比先前最先进模型少 14 倍的训练步数实现 4.82% 的 ImageNet top-5 错误率。
核心贡献
-
将批归一化作为模型结构内部的一种归一化机制引入,针对每个训练小批量对层输入进行归一化,减少因激活分布变化导致的不稳定性,并允许更高的学习率、对初始化不那么谨慎,以及通常不需要 Dropout。
-
给出构造、训练和推断批归一化网络的算法,包括学习得到的缩放参数和平移参数、对卷积层的支持,以及不依赖小批量统计量的确定性推断。
-
在一种最先进图像分类模型上应用批归一化后,模型以少 14 倍的训练步数达到并超过原始模型的准确率,同时集成模型在 ImageNet 上达到 4.82% 的 top-5 测试错误率,改进了已发表的最佳结果。
引言
作者研究使用随机梯度下降进行深度神经网络训练,其中使用小批量,是因为小批量能够在现代硬件上提供高效的梯度估计并加快优化。
先前方法的一个关键局限是,训练仍然对超参数和初始化敏感,并且在优化过程中每个层的输入分布会发生变化。作者将这种现象称为内部协变量偏移,它可能拖慢收敛、放大非线性函数的饱和,并导致梯度消失。
为解决这一问题,作者引入批归一化,对每个小批量内的层输入进行归一化,并使用可学习的缩放参数和平移参数来保留表示能力。这会稳定激活,改善梯度流动,允许更高的学习率,支持饱和型非线性,并在更低的 Dropout 需求下加速训练。
方法
作者聚焦于减少内部协变量偏移,并将其定义为随着训练推进,网络内部激活分布发生变化。在标准深度网络中,较早的层会随参数更新不断改变其输出,迫使较后的层适应非平稳输入分布。这可能拖慢优化、增加对初始化的敏感性,并使训练不稳定。所提方法通过将归一化变换插入网络本身,使得进入后续层的激活在整个训练过程中具有更稳定的一阶矩和二阶矩。
关键设计选择是让归一化成为模型中可微的一部分,而不是在梯度计算之外执行的一个独立预处理步骤。如果归一化在参数更新后施加,但在反向传播中被忽略,优化器可能会更新参数,而这些更新会立即被归一化步骤抵消。例如,若偏置被更新,随后减去均值会抵消该偏置的作用,则损失可能保持不变,而偏置却不断增大。通过将归一化嵌入前向计算,网络在知晓该变换的情况下学习,优化器也可以考虑参数变化如何影响归一化后的激活。
该方法对每个标量特征维度独立进行归一化。对于层输入向量 x=(x(1),…,x(d)),每个维度被标准化为
x(k)=Var[x(k)]x(k)−E[x(k)].该方法不是使用完整白化,因为完整白化需要计算协方差矩阵及其导数并进行求逆,而是分别对维度进行归一化。这显著降低了计算开销,同时仍能改善收敛。避免完整去相关,是因为它需要昂贵操作,并且当从小批量估计且小批量大小小于特征维度时可能不稳定。
简单归一化步骤可能限制层的表达能力,尤其是当归一化后的激活经过 sigmoid 等饱和型非线性时。为了保留网络的表示能力,归一化值随后经过一个学习得到的仿射变换:
y(k)=γ(k)x(k)+β(k).其中,γ(k) 和 β(k) 是学习得到的参数,用于缩放和平移每个激活维度。如果最优表示需要原始未归一化激活,则可以通过学习
γ(k)=Var[x(k)],β(k)=E[x(k)].来恢复它们。
因此,归一化并未迫使网络进入受限的函数族。它提供了一个可训练机制,必要时可以恢复恒等变换。
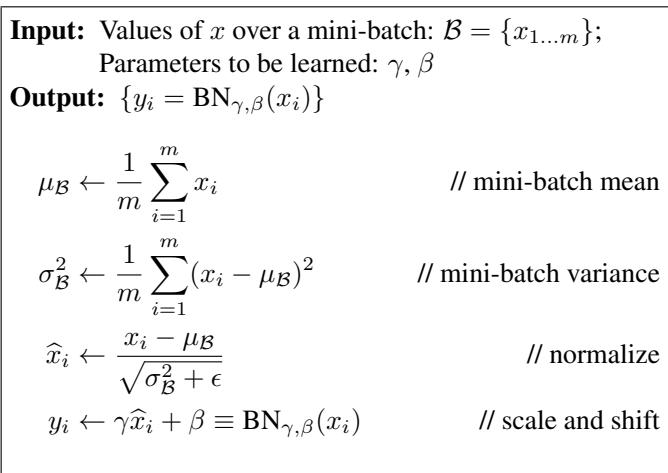
在随机训练期间,用于归一化的统计量在小批量上计算。考虑一个激活维度上的小批量 B={x1,…,xm}。批均值和批方差为
μB=m1i=1∑mxi,和
σB2=m1i=1∑m(xi−μB)2.归一化并变换后的值按如下方式计算
xi=σB2+ϵxi−μB,然后进行
yi=γxi+β.为保证数值稳定性,在方差中加入一个小的常数 ϵ。该变换通常称为批归一化变换,将小批量激活 {xi} 映射到变换后的激活 {yi}。由于这些统计量由用于优化的同一个小批量计算得到,因此归一化直接参与反向传播。梯度通过均值、方差、缩放参数和平移参数流动,使学习过程能够以与归一化步骤一致的方式调整模型。
反向传播使用链式法则,将梯度通过归一化和仿射变换传播。从损失 ℓ 开始,梯度首先流过仿射层:
∂xi∂ℓ=∂yi∂ℓγ.然后梯度累积到批量统计量中:
∂σB2∂ℓ=i=1∑m∂xi∂ℓ(xi−μB)(−21)(σB2+ϵ)−3/2,和
∂μB∂ℓ=i=1∑m∂xi∂ℓσB2+ϵ−1.相对于每个输入激活 xi 的梯度为
∂xi∂ℓ=∂xi∂ℓσB2+ϵ1+∂σB2∂ℓm2(xi−μB)+∂μB∂ℓm1.仿射参数接收梯度
∂γ∂ℓ=i=1∑m∂yi∂ℓxi,和
∂β∂ℓ=i=1∑m∂yi∂ℓ.这种可微性是方法的核心。归一化后的激活在优化期间不被视为固定常数。相反,它们嵌入在计算图中,使每一层都能在内部协变量偏移降低的输入分布上继续学习。
在推断阶段,该方法从小批量统计量改为固定总体统计量。归一化后的激活计算为
x=Var[x]+ϵx−E[x],其中均值和方差由训练阶段估计得到。这些估计可以在训练阶段使用移动平均或基于小批量统计量的无偏估计累积得到。由于推断阶段的均值和方差是固定的,归一化变为一个简单的线性操作。它可以与学习得到的缩放参数 γ 和平移参数 β 合并为单个仿射变换。这使得部署高效且确定,因为输出不再依赖于同一批量中的其他样本。
当应用于如下形式的标准层时
z=g(Wu+b),其中 g(⋅) 是 ReLU 或 sigmoid 等非线性激活函数,归一化被插入到非线性之前。变换后的预激活 x=Wu+b 被归一化。由于后续减去均值会移除任何常量平移,原始层偏置 b 可以被省略。其作用被学习得到的平移参数 β 吸收。所得到的层变为
z=g(BN(Wu)).这种放置方式优于直接对层输入 u 进行归一化。在训练期间,u 的分布经常变化,因为它可能由另一个非线性产生,因此约束其均值和方差可能无法完全稳定其高阶形状。预激活 Wu 更可能具有对称且稳定的分布,从而使归一化更有效。
对于卷积网络,归一化被调整为遵循卷积结构。不再对每个空间位置独立归一化,而是对小批量和空间位置上的同一特征图激活进行联合归一化。如果小批量大小为 m,且每个特征图的空间尺寸为 p×q,则给定特征图的有效批量大小为
m′=mpq.学习得到的参数 γ(k) 和 β(k) 在同一特征图内的空间位置间共享,而不是为每个位置分别学习。这保持了平移等变性,并确保同一特征图中的所有激活经历相同变换。
该方法还会改变网络的优化行为。通过稳定激活分布,它减少了信号在多层传播过程中参数小幅变化被放大的程度。这使得更大的学习率可以更安全地使用。归一化变换也使训练对参数尺度不太敏感。对于标量 a,
BN(Wu)=BN((aW)u),因为归一化移除了全局缩放。因此,增大 W 的幅度不会直接增大反向传播期间的梯度幅度。较大的权重甚至可能导致相对于权重矩阵的梯度更小,这有助于控制参数增长。这种行为使高学习率更稳定,并降低梯度爆炸或梯度消失的风险。
可以进一步调整训练过程,以利用归一化带来的正则化效果。由于每个训练样本都使用其所在小批量的统计量进行归一化,因此其变换后的表示依赖于同一批量中随机采样的其他样本。这会引入一种随机正则化。在实践中,这使得训练配置可以减少对其他正则化器的依赖。可以减小权重衰减,在某些架构中移除 Dropout,并使用更激进的学习率调度。由于网络训练更快,训练样本可以被较少次数地观察,同时可以减少增强或光度失真,使模型更专注于自然分布的样本。这些调整反映了该方法的中心设计:归一化不仅仅是一个预处理步骤,而是一个完整的可训练模块,可稳定优化、保留模型容量并重塑训练动态。
实验
实验首先使用一个简单的 MNIST 模型,表明批归一化能够稳定隐藏层激活分布,并相对于基线提高测试准确率。然后,在 ImageNet 上评估修改后的 Inception 网络,证明批归一化与调整后的训练设置相结合能够加速优化、提高可达到的准确率,并使原本困难的基于 sigmoid 的训练成为可能。最后,基于批归一化模型的集成达到了最先进的 ImageNet 分类性能。
批归一化变换使用小批量的均值和方差对激活进行标准化,然后施加可学习的缩放和平移。在报告的实验中,这降低了训练难度,并使模型能够以少得多的步数达到很强的验证准确率。它还支持更困难的配置,包括更高的学习率和 sigmoid 非线性。基线批归一化模型以不到一半的训练步数达到参考准确率。较高学习率的变体起初可能训练较慢,但最终达到更高准确率。在 sigmoid 激活下,归一化使模型获得有意义的准确率,而原始模型仍接近随机水平。
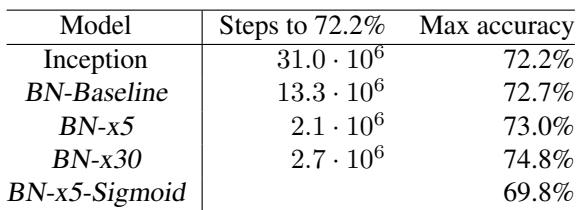
批归一化加速训练,并在验证准确率方面优于 Inception。批归一化模型以更少训练步数达到 Inception 的 72.2% 准确率,其中 BN-x5 所需步数最少,BN-x30 虽然早期收敛较慢,但达到最高准确率。使用批归一化后,sigmoid 变得可训练,但性能仍低于 ReLU 变体。批归一化以不到一半的训练步数匹配 Inception 的准确率。在批归一化变体中,BN-x5 最快达到 72.2% 准确率阈值。BN-x30 以较慢收敛换取最高最终准确率。不使用批归一化的 sigmoid 仍停留在随机准确率水平。
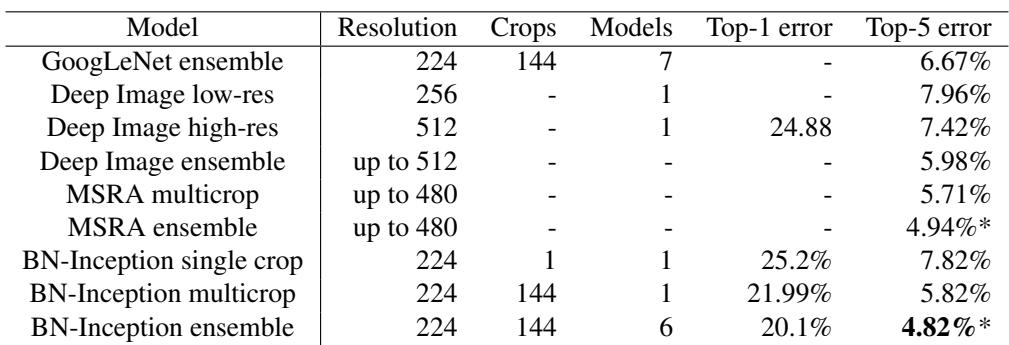
该表格比较了批归一化 Inception 模型与先前 ImageNet 分类结果。报告的单裁剪 BN-Inception 模型在 top-5 错误率上接近单模型 Deep Image。相关文字称,BN-Inception 集成在验证集上达到 4.9% 的 top-5 错误率,在测试服务器上达到 4.82%。该集成结果被描述为改进了此前已发表的最佳结果。BN-Inception 模型集成被描述为在先前报告的 top-5 错误率上创造了新的最先进结果。单裁剪 BN-Inception 结果弱于所展示的最强集成结果,这表明集成推断是准确率提升的主要来源。
实验通过比较训练收敛性、最终准确率、激活函数选择以及与先前模型的结果,评估了批归一化在 Inception 风格 ImageNet 分类器中的表现。结果显示,归一化显著降低优化难度、加速训练、支持更高学习率,并使 sigmoid 网络可训练。批归一化变体也达到有竞争力或更高的准确率,尽管有些变体侧重更快收敛,而另一些侧重更高最终性能,且集成推断提供了最强的整体 ImageNet 增益。