Command Palette
Search for a command to run...
THE POLAR EXPRESS:最优矩阵符号方法及其在 Muon 算法中的应用
THE POLAR EXPRESS:最优矩阵符号方法及其在 Muon 算法中的应用
Noah Amsel David Persson Christopher Musco Robert M. Gower
摘要
计算极分解及相关的矩阵符号函数是数值分析领域数十年来被广泛研究的经典问题。近年来,它已成为 Muon 优化器在深度神经网络训练中的一个重要子过程。然而,该应用的需求与经典设定截然不同:深度学习需要面向 GPU 的高效算法,优先追求高吞吐量而非高精度。我们提出了 Polar Express,一种计算极分解的新方法。与 Newton-Schulz 及其他经典多项式方法类似,我们的方法仅使用矩阵-矩阵乘法,因此在 GPU 上非常高效。受 Chen & Chow 以及 Nakatsukasa & Freund 早期工作的启发,Polar Express 通过求解极小极大优化问题来自适应地调整每次迭代的更新规则。我们证明该策略在最坏情况下最小化误差,使 Polar Express 在早期迭代和渐近阶段均能达到尽可能快的收敛速度。我们还解决了有限精度问题,使其可在 bfloat16 精度下实际使用。将该方法集成到 Muon 后,在 FineWeb 数据集上训练一到十亿 token 的 GPT-2 模型中,验证损失获得了持续提升,在多种学习率下均优于近期提出的替代方案。
一句话总结
纽约大学和 Flatiron Institute 的研究人员提出了 Polar Express,一种面向 GPU 的极分解方法。该方法在每次迭代中求解一个极小极大优化问题,从而在早期和渐近区域均实现可证明的最坏情形最优收敛;将其集成到用于 GPT-2 训练的 Muon 优化器中后,与近期替代方法相比,验证损失稳定改善。
核心贡献
- Polar Express 引入了一种极分解方法,该方法通过在每次迭代中求解极小极大问题来调整多项式更新,并仅使用矩阵-矩阵乘法,因而对基于 GPU 的 Muon 优化器高效。
- 该多项式序列被证明对符号函数给出最坏情形最优近似,具有超指数收敛性,并且仅五到十次迭代内即可快速推进。
- 兼容 bfloat16 的实现在一到一百亿个 FineWeb tokens 上的合成矩阵、GPT-2 梯度矩阵以及使用 Muon 训练的 GPT-2 模型上进行了评估;它在不同学习率下都能改善验证损失,并已被 NanoGPT speedrun 采纳。
引言
高级线性代数正日益成为深度学习的核心,在 Muon 等优化器中尤其如此。Muon 用基于梯度的矩阵的极因子替代通常的动量方向。对于方阵,该极因子等价于矩阵符号函数,并给出谱范数下的最速下降方向。对于大语言模型训练,计算必须快速、面向 GPU、内存高效,并且主要在低精度或中等精度下有用。
先前的方法面临实际限制。直接 SVD 在 GPU 上开销过高;许多经典极分解方法需要矩阵求逆、QR 分解或其他不易并行化的运算。Newton-Schulz 具有吸引力,因为它只使用矩阵-矩阵乘法,但初期收敛较慢。近期的启发式多项式迭代能够快速达到低精度估计,但不会收敛到真实极因子。
作者提出 Polar Express,一种新的面向 GPU 的迭代方法,用于近似矩阵极因子。该方法在每次迭代中调整多项式更新规则,从而平衡早期快速进展和后期精度。该方法使用为优化符号函数的最坏情形近似而设计的多项式,具有超指数收敛,并能在很少的迭代次数内产生有用的近似。将其应用到 Muon 中,Polar Express 在不同学习率下都改善了 GPT-2 训练的验证损失,并已被采纳到优化后的 NanoGPT 训练流程中。
方法
作者将方法设计为通过 GPU 上高效的运算来计算 polar(M):矩阵的线性组合和矩阵-矩阵乘法。由于矩阵乘法比线性组合更昂贵,算法被设计为尽量使用更少的矩阵乘法。对于奇异值分解为 M=UΣV⊤ 的矩阵,奇数次幂可以写成
M2q+1=UΣ2q+1V⊤=M(M⊤M)q.因此,对于奇多项式
p(x)=a0x+a1x3+⋯+aqx2q+1,该矩阵多项式可以评估为
p(M)=a0M+a1M(M⊤M)+⋯+aqM(M⊤M)q.核心设计选择是使用较低次数奇多项式的复合来近似 polar(M)。完整近似具有如下形式
p=pT∘pT−1∘⋯∘p1,矩阵迭代项通过递归方式生成:
X0=M,Xt=pt(Xt−1)for t=1,…,T.最终矩阵 XT 是对 polar(M) 的近似。如果每个组成多项式的次数均为奇数 d,该复合只需要 O(Td) 次矩阵乘法。标准的 Newton-Schulz 迭代是该框架的一个特例,但作者选择多项式以最小化最坏情形近似误差。
给定 M 奇异值的已知或估计下界 ℓ 和上界 u,目标是找到能够在最坏情形下最小化谱范数误差的复合。因为
polar(M)−p(M)=U(I−p(Σ))V⊤,并且谱范数具有酉不变性,该问题归约为一个标量一致逼近问题:找到一个复合奇多项式 p,使得对所有 x∈[ℓ,u],p(x) 都尽可能接近 1。形式化地,
p⋆=argp=pT∘pT−1∘⋯∘p1pt∈Pdoddminx∈[ℓ,u]max∣1−p(x)∣.该方法在多次迭代中以贪心方式求解该问题。对于当前区间 [ℓt,ut],选择一个 d 次奇多项式,最小化
x∈[ℓt,ut]max∣1−p(x)∣.该多项式将当前区间映射到一个新区间
[ℓt+1,ut+1],该新区间随后成为下一个多项式的目标区间。界可以使用下式更新:
ℓt+1=pt(ℓt),ut+1=2−ℓt+1.所得到的复合在所有由 T 个次数为 d 的奇多项式组成的复合中是最优的。最终近似满足
∥polar(M)−XT∥2≤x∈[ℓ,u]max∣1−p⋆(x)∣=1−ℓT+1.当奇异值经过归一化,使得 σ(M)⊂[ℓ,1] 且 d=2q+1 时,误差界具有更强的形式
∥polar(M)−XT∥2≤∣1−ℓ2∣(q+1)T,这表明随着 T 增大,收敛速度迅速提升。
如下图:
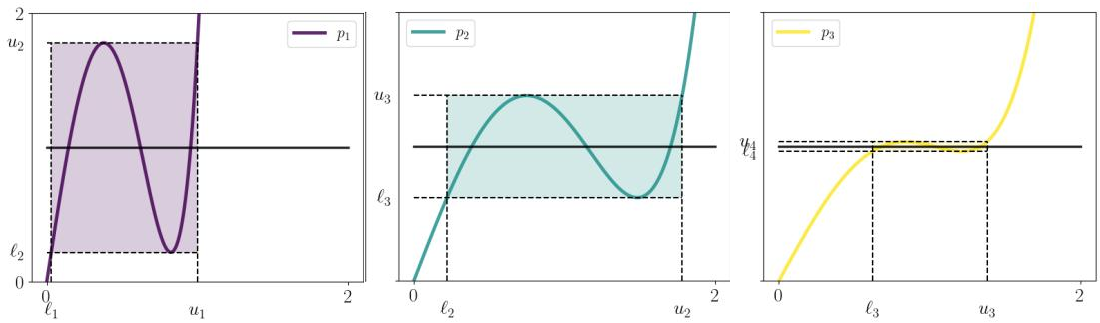
区间的演化展示了每个多项式如何缩小仍偏离 1 的奇异值范围。第一个多项式将原始奇异值区间映射到更靠近 1 的新区间,第二个多项式在该更新后的区间上作用,后续多项式继续细化近似。正是这种基于区间的视角使得该贪心构造对谱范数误差是最优的。
为找到每个多项式 pt,该方法求解一个极小极大近似问题:在所选定次数的所有奇多项式中,选择在当前区间 [ℓt,ut] 上一致逼近常数函数 1 的那个多项式。对于实践中使用的低次数,这可以通过显式方式完成,或使用从极小极大近似的等振荡性质推导出的简化求解器完成。完整的 Remez 风格过程也可以求解该问题,但由于目标函数是常数且次数较小,该方法使用一种专门的低次数构造,在相关设置下实现更简单,并在数学上等价。
该方法还需要奇异值的实际界。一种简单的上界是 ∥M∥F,即矩阵的 Frobenius 范数。实践中,输入矩阵按与该范数成正比的量重新缩放,并将上界设为 u=1。下界 ℓ 更难高效估计,因此作者为浮点工作负载选择一个较小的值,例如 ℓ=10−3,尤其是在 bfloat16 精度下运行时。较差的下界估计不会破坏收敛;它主要只会使收敛推迟少量迭代次数。
还存在针对有限精度算术的数值保护措施。如果舍入误差使奇异值看起来略高于当前上界,则每个多项式都可替换为 x↦pt(x/1.01),这实际上会扩大区间并避免不稳定。由于某些最优多项式在过程开始附近可能非单调,早期迭代也可以使用略微次优但振荡更小的多项式。这些改动以可忽略的近似质量损失稳定了离线系数计算。
整体流程包含离线阶段和在线阶段。在离线阶段,对于固定界 ℓ 和 u,多项式 p1,…,pT 被预先计算一次。在在线阶段,这些已存储的系数被复用于每一次矩阵更新。对于一个 5 次多项式
pt(x)=ax+bx3+cx5,矩阵迭代可以使用类似 Horner 的形式高效评估。令
Yt−1=Xt−1⊤Xt−1,更新为
Xt=Xt−1(aI+Yt−1(bI+cYt−1)).在推荐实现中,该复合应用于如下形式的归一化矩阵
∥M∥F+10−2M,并且少量迭代,通常五次或六次,就足以满足深度学习应用场景。
实验
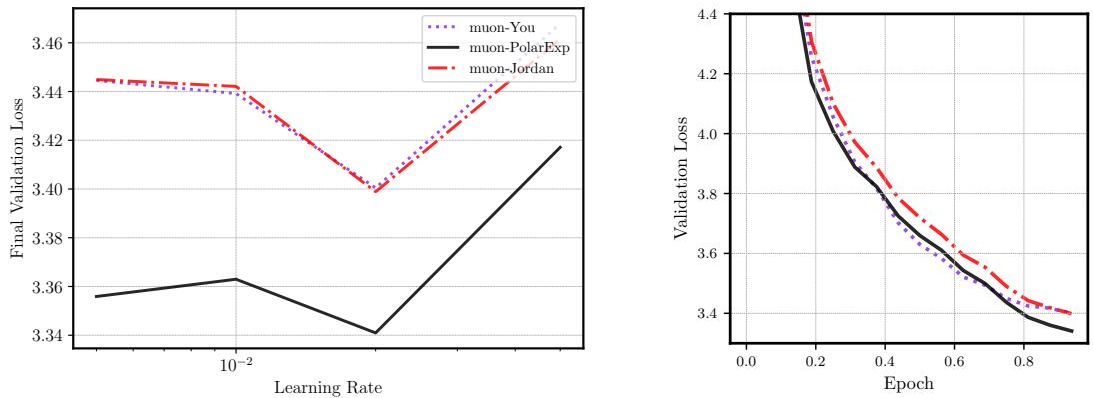
实验从两个角度评估 Polar Express:作为迭代极因子近似方法,以及作为 Muon 中的矩阵符号函数子程序;并与 Newton-Schulz、Jordan 方法和 You 方法进行比较。在合成矩阵和真实矩阵近似中,当 Polar Express 的下奇异值界合理时,它比基线更可靠、更快收敛;而当该界被错误估计时,它仍保持竞争力。在 GPT-2 训练中,将这些极近似子程序替换为 Polar Express 会持续改善验证损失和训练损失,且没有额外成本;消融实验表明,仅使用少量 Polar Express 迭代就足够了,而更高的精度或基于精确 SVD 的计算不会改善优化。在权重衰减和更长训练下,这些收益仍然存在,尽管差距会缩小。