Command Palette
Search for a command to run...
大语言模型在多轮对话中迷失方向
大语言模型在多轮对话中迷失方向
Philippe Laban Hiroaki Hayashi Yingbo Zhou Jennifer Neville
摘要
大语言模型(LLMs)是对话式交互界面。因此,LLMs 不仅在用户能够完整描述任务时提供辅助,还有潜力通过多轮对话交互帮助用户定义、探索和细化其需求。尽管对 LLM 对话日志的分析已证实用户指令中普遍存在任务描述不完整的情况,但 LLM 的评估工作主要集中在单轮、指令完全明确的设定上。本研究通过大规模模拟实验,对比了 LLM 在单轮与多轮设定下的性能表现。实验结果证实,所有参测的开源与闭源顶级 LLMs 在多轮对话中的性能均显著低于单轮设定,在六项生成任务上平均下降 39%。对 20 万余次模拟对话的分析表明,性能退化可分解为两个组成部分:胜任度的轻微损失和不可靠性的显著增加。我们发现,LLMs 常在早期轮次中做出假设并过早地尝试生成最终解答,且过度依赖这些解答。简而言之,我们发现 LLMs 在对话中一旦走错方向,便会迷失其中而无法恢复。
一句话总结
通过对跨六项生成任务的 200,000+ 会话进行大规模模拟,Microsoft Research 和 Salesforce Research 的研究人员证明,所有顶尖开放权重和闭源权重 LLM 在多轮场景中平均出现 39% 性能下降;这种退化主要由不可靠性增加所驱动,原因是模型过早锁定早期假设,并且无法恢复。
核心贡献
-
大规模模拟实验在同一组六项开放式生成任务上比较顶尖开放权重与闭源权重 LLM 的单轮和多轮欠指定会话表现,结果显示多轮交互平均性能下降 39%。
-
对 200,000+ 次模拟会话的分析将退化拆分为能力损失与不可靠性增加,并识别出一种 "lost in conversation" 模式:模型过早做出假设,生成冗长的最终尝试,并过度依赖此前错误的回答。
-
额外实验表明,agent 式拼接和更低解码温度并不能可靠恢复多轮鲁棒性,因此支持在 LLM 评估与开发中同时重视多轮可靠性和能力表现。
引言
LLM 越来越常充当会话助手,用户经常从模糊请求开始,并在多轮对话中澄清需求。这种场景很重要,因为许多真实用户,尤其是新手,无法从一开始就完整说明目标,因此多轮行为是实际要求,而非可选功能。先前的工作常把多轮会话评估为彼此隔离的子任务,这会遗漏欠指定问题,并可能高估模型能力。研究人员采用分片模拟方法,将现有单轮基准指令拆分为较小片段,并在多轮对话中逐步揭示,从而在单轮和多轮开放式设置中测试相同任务。其关键贡献是一项大规模评估,表明当指令逐步揭示时,LLM 会损失大量可靠性,这暴露出模型实际使用方式与当前评估方式之间的差距。
数据集
-
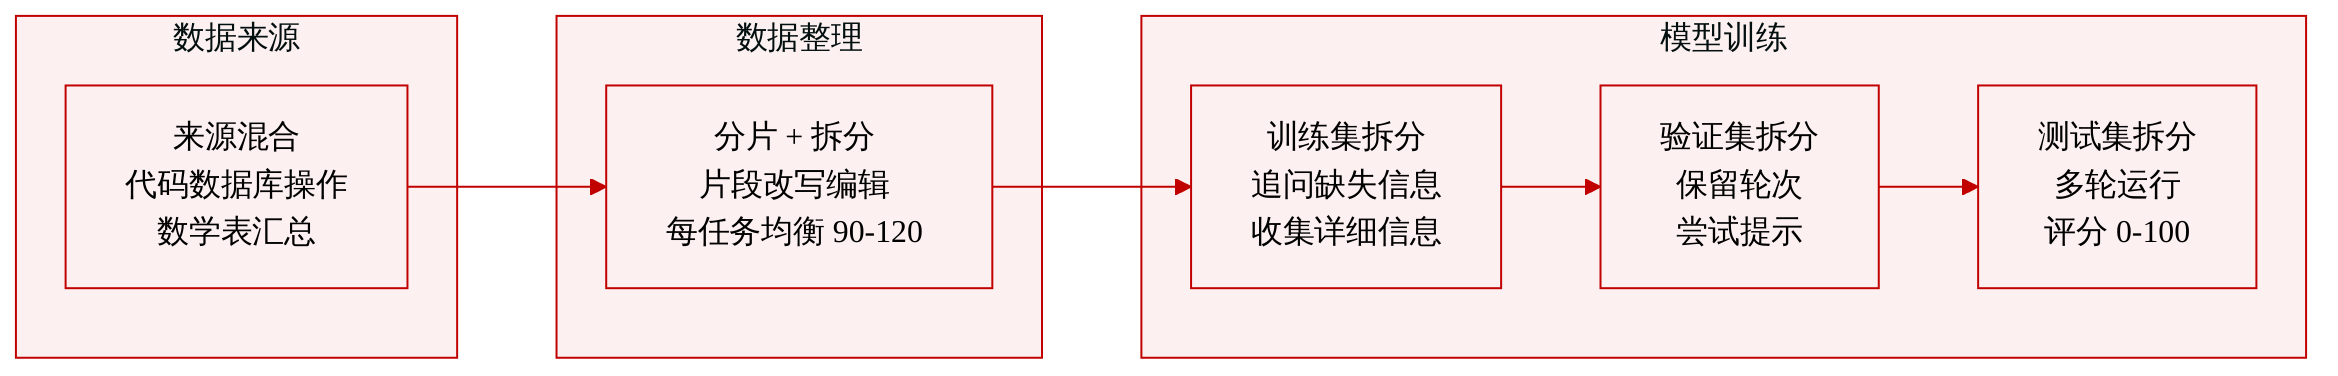
研究人员构建了分片指令数据集,用于模拟欠指定的多轮会话。该数据集通过把完全指定的单轮指令转换为多个分片构建,每个分片引入来自原始指令的一个自然信息要素。
-
最终数据集覆盖编程与非编程领域的六项生成任务:Code、Database、Actions、Math、Data-to-text 和 Summary。
-
对每项任务,研究人员准备 90 到 120 条分片指令,形成任务均衡的实验数据集,包含约 540 到 720 个指令示例。
-
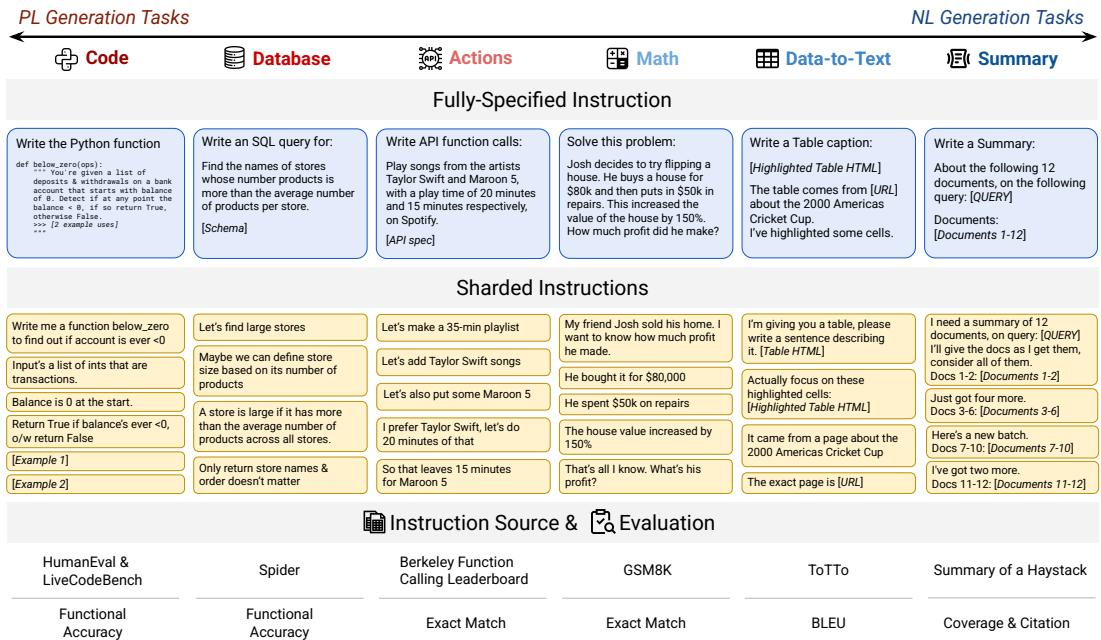
源数据来自成熟的单轮基准:
- Code:来自 HumanEval 和 LiveCodeBench 的指令。
- Database:来自 Spider 数据集的指令和数据库。
- Actions:来自 Berkeley Function Calling Leaderboard 的 API 模式与用户指令。
- Math:来自 GSM8K 的初等数学应用题。
- Data-to-text:来自 ToTTo 的表格到标题示例。
- Summary:来自 Summary of a Haystack 的指令和文档集。
-
分片示例通过包含四个阶段的半自动流程生成:分段、改写、验证和人工检查。
-
每条分片指令都必须满足信息保持、初始意图清晰以及顺序不敏感等属性。
-
在人工检查期间,每条分片指令都会被审阅。分片可以合并、拆分、重排或编辑,以提升自然度,并确保每个分片都像用户可能在单个会话轮次中合理提供的信息。
-
该处理步骤旨在创建自然的欠指定交互,而不是把原始完全指定指令改写成对抗式形式。
-
原始指令及其分片在信息上保持等价,但信息被明确拆分到各个分片中,因此模型必须在多轮对话中收集缺失细节。
-
研究人员在大规模模拟实验中使用该数据集,以评估模型能否通过多轮交互恢复与任务相关的信息。
-
评估复用原始基准指标。Code 与 Database 使用功能正确率,Actions 与 Math 使用语义等价性,Data-to-text 使用 BLEU,Summary 使用定制的 LLM-as-a-judge Joint Score。
-
二元正确性得分被映射到 0 到 100 量纲,以便比较和聚合所有任务。
方法
研究人员设计了一条模拟流水线,把完全指定的单轮任务转换为受控的多轮欠指定任务。该方法包含两个主要阶段:一个构造多轮指令变体的分片过程,以及一个使用这些变体运行多轮会话的模拟环境。
分片过程从原始指令开始,并将其拆分为多个分片,每个分片包含一小段自然形式的原始任务信息。有效的分片指令必须保持原始信息、呈现清晰的初始意图,并对分片揭示顺序保持鲁棒。研究人员通过包含分段、改写、验证和人工检查的半自动工作流构建分片指令。在人工审阅期间,研究人员合并、拆分、重排或改写分片,使每个分片都像真实用户在单个轮次中可能合理提供的信息,而不是原始提示的人工片段。完全指定指令及其分片变体的示例见下图。
核心模拟环境实现了包含三种角色的循环:被评估助手、用户模拟器和评估系统。助手是被测试模型,在会话开始前仅接收最小上下文,例如工具列表。它不会被告知任务将会欠指定或多轮,这使研究人员能够测量默认行为。用户模拟器可以访问完整分片指令和会话历史。在每个轮次,它最多揭示一个分片,并可轻微改写分片,使信息适应当前交互,例如用相关信息度最高的分片回答澄清问题。
助手回应后,策略分类器会把回复标为若干行为类别之一,包括澄清、拒绝、含糊回避、追问、讨论、内容缺失或回答尝试。如果回复被分类为回答尝试,系统会提取答案片段,例如代码块、SQL 查询或数字结果,以免评分受周围解释性文本影响。提取出的答案随后交给任务特定评估器,产生每个轮次的分数。非回答轮次会继续会话,但不立即评分。
下方框架图展示轮次如何依次经过信息揭示、响应生成、策略分类、可选答案提取和评估。
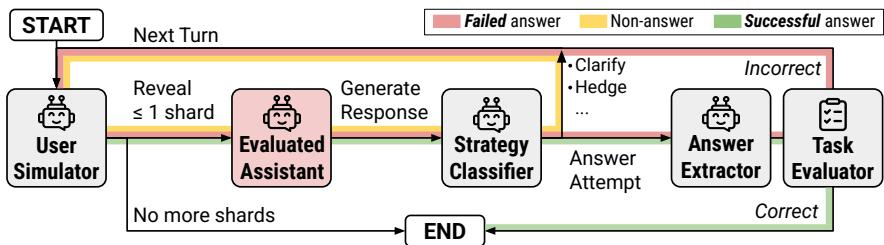
当模型给出正确答案,或没有剩余分片时,会话结束。最终分数是所有回答尝试中的最高分:
S=1≤i≤Nmaxsi其中 N 是分片数量,si 是第 i 轮获得的分数。该评分规则允许助手每个分片至多进行一次回答尝试,并以最佳尝试计分。研究人员通过人工审阅会话来验证模拟器,发现组件错误很少,支持使用该流水线进行系统化测量。
为隔离多轮欠指定的影响,研究人员构造了五种模拟类型。FULL 是单轮基线,一次性呈现原始指令。SHARDED 是主要设置,分片在多个轮次中逐步揭示。CONCAT 把所有分片放入首轮的单条项目符号列表中,保留改写后的分片形式,同时移除多轮揭示因素。RECAP 先运行 SHARDED 会话,然后增加最后的 recap 轮次,重新陈述所有分片,以测试对累积信息的简单总结能否恢复性能。SNOWBALL 在每个轮次揭示下一个分片,同时重复之前揭示的所有分片,以评估连续提醒是否能减少长交互中的记忆需求。
实验
实验跨六项多样化的生成任务模拟多轮会话,在多个模型和重复随机运行中比较完全指定、拼接和分片指令设置。结果表明,模型在单轮设置中表现可能很强,但在需求分散到多个轮次时显著退化;同时拼接指令仍接近原始性能,表明困难并不仅仅是信息缺失。退化主要由变异性增大和不可靠性增加驱动,而不是最佳情况能力表现的大幅损失;逐步分片表明,即使较短的欠指定多轮交互也会触发退化。recap、snowballing、更低解码温度或系统提示提示等辅助策略只能部分减轻该影响,表明需要原生多轮可靠性。
在各项被测试任务中,LLM 在完全指定设置下性能最高,而分片多轮会话导致显著退化。拼接指令总体上仍接近完全指定性能,表明分片设置中的下降主要不是由指令信息缺失造成的。相对完全指定设置,分片会话降低了每个模型和任务的平均性能。拼接设置通常能保持性能,但较小模型对改写的鲁棒性弱于较大模型。分片会话中的性能损失并不局限于较弱模型,因为更强系统也会出现大幅相对下降。
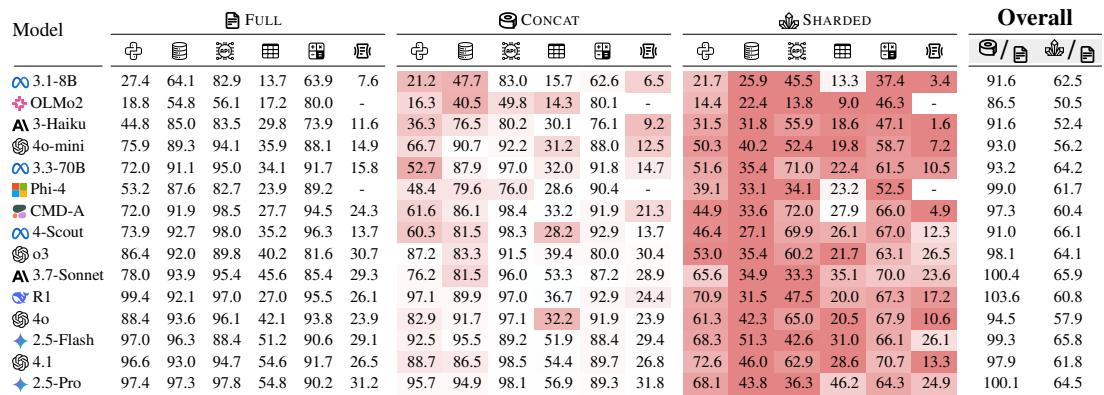
实验比较了各 LLM 在完全指定、拼接和分片多轮指定设置下的表现。完全指定设置带来最高性能,而分片会话使所有模型和任务的结果显著退化。拼接指令在很大程度上保持性能,表明退化来自信息碎片化,而不是指令内容缺失;较小模型对改写的鲁棒性更弱,且强模型也会受到影响。