Command Palette
Search for a command to run...
FASTER CASCADES VIA SPECULATIVE DECODING
FASTER CASCADES VIA SPECULATIVE DECODING
Harikrishna Narasimhan Wittawat Jitkrittum Ankit Singh Rawat Seungyeon Kim Neha Gupta Aditya Krishna Menon Sanjiv Kumar
摘要
Cascades and speculative decoding are two common approaches to improving language models' inference efficiency. Both approaches interleave two models of different sizes, but via fundamentally distinct mechanisms: cascades employ a deferral rule that invokes the larger model only for "hard" inputs, while speculative decoding uses speculative execution to primarily invoke the larger model in parallel scoring mode. These mechanisms offer different benefits: cascades offer compelling cost-quality trade-offs, often even outperforming the large model; speculative cascades offer impressive speed-ups, while guaranteeing quality-neutrality. In this paper, we leverage the best of both these approaches by designing new speculative cascading techniques that implement their deferral rule through speculative execution. We characterize the optimal deferral rule for our speculative cascades, and employ a plug-in approximation to the optimal rule. Experiments with Gemma and T5 models on a range of language benchmarks show that our approach yields better cost-quality trade-offs than cascading and speculative decoding baselines.
一句话总结
Google Research、Google DeepMind 和 Mistral AI 提出推测级联。该方法通过推测执行实现级联推迟规则,从而将级联的成本与质量权衡同推测解码的速度保证结合起来,并在语言基准上的 Gemma 和 T5 模型上优于两种基线。
核心贡献
- 提出推测级联,这是一种推理策略,通过推测执行实现级联式推迟,使较小模型处理容易的输入,仅在需要时通过草稿与验证步骤调用较大模型。
- 刻画推测级联的最优推迟规则,并采用插入式近似使该规则可用于两个语言模型之间的 token 级交错。
- 在语言基准上使用 Gemma 和 T5 模型进行的实验表明,与标准级联或标准推测解码等基线相比,该方法具有更好的成本与质量权衡。
引言
大语言模型在多种自然语言任务上提供强质量,但也会造成高推理延迟,这促使人们研究结合小模型与大模型以提升效率的方法。已有的高效推理策略具有互补优势:级联使用推迟规则,只将困难输入路由到较大模型;推测解码则用小模型草拟 tokens,并行验证它们,以近似较大模型的分布。作者利用这两种思想,设计了推测级联,通过草稿与验证步骤实现推迟规则,使较大模型能够并行决定接受或推迟。该方法相比标准顺序级联和标准推测解码能产生更好的成本与质量权衡。
方法
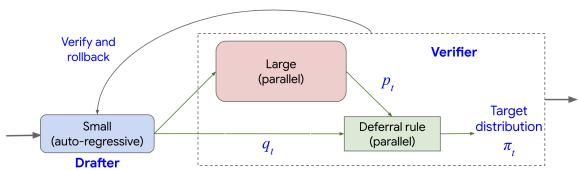
作者利用一个推测级联框架,将级联生成的质量权衡与推测解码的并行执行效率结合起来。该系统使用两个语言模型:较小的草拟器 q 和较大的验证器 p。在前缀 x<t 处,草拟器产生候选的下一 token 分布 qt(⋅),同时并行调用较大模型,对小模型生成的草稿 tokens 进行打分。输出分布由推迟函数或目标分布函数控制,该函数决定何时依赖 q,何时依赖 p。
token 级级联从标准推迟思想出发:对于每个前缀 x<t,计算 qt(⋅),只有当小模型置信度不足时才从 pt(⋅) 采样。例如,Chow 规则可写为
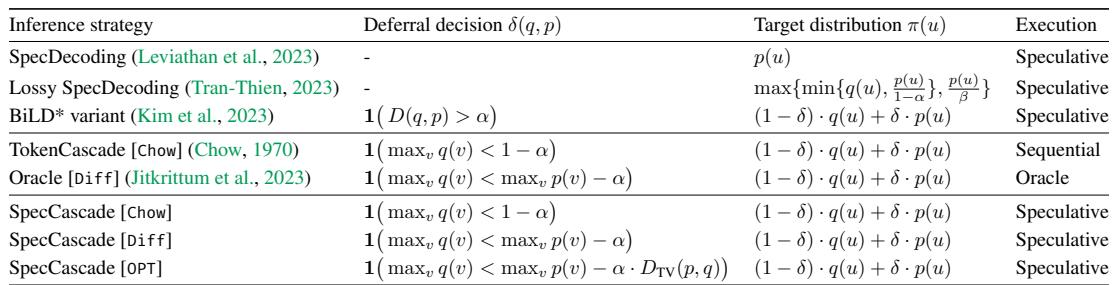
rChow(x<t)=1⟺v∈Vmaxqt(v)<1−α,其中 α 是推迟阈值。若规则不推迟,级联从 qt(⋅) 采样;若推迟,则从 pt(⋅) 采样。更一般地,oracle 式 diff 规则可以比较两个模型的置信度:
r^Diff(x<t)=1⟺vmaxqt(v)<vmaxpt(v)−α.该 diff 规则在严格的顺序 token 级级联中无法直接实现,因为评估它需要在每一步都调用大模型。不过,它可作为 oracle,用于理解级联所能达到的最佳成本与质量权衡。
如下图所示:
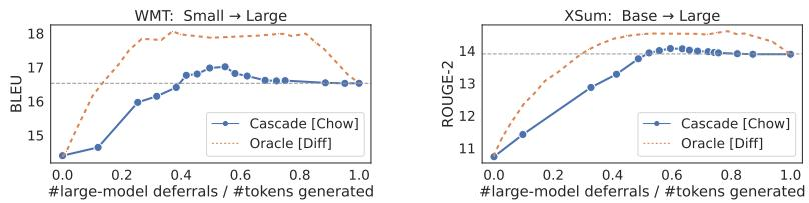
曲线表明,基于级联的生成可以覆盖很宽的成本与质量权衡范围。已生成 tokens 中推迟给较大模型的部分作为推理成本,不同推迟规则会描绘出不同的质量曲线。在某些区域,级联规则可以匹配甚至超过较大模型的质量;如果目标仍然是较大模型的分布,标准推测解码通常无法做到这一点。然而,顺序级联可能需要很多次推迟,因为每次推迟通常都要运行一次大模型来生成下一个 token,随后控制权又回到小模型。
为解决这一低效问题,作者通过引入由草拟器和验证器分布导出的目标分布 π=T(q,p) 来推广推测解码。小模型首先草拟一段 tokens。随后大模型并行对整个前缀打分。对于每个草稿 token xt,方法将 q(xt) 与目标概率 π(xt) 进行比较。若 q(xt)≤π(xt),则接受该 token。否则,以下概率拒绝它:
1−q(xt)π(xt).若被拒绝,则从由以下公式构造的归一化残差分布中采样一个替代 token:
max{0,π(⋅)−q(⋅)}.当 π=p 时,该过程包含标准推测解码,但它也支持更丰富的目标分布,这些分布有意偏离大模型,以获得不同的质量与成本权衡。
推测级联通过将基于推迟的级联表示为目标分布来实现这一思想。如果推迟规则 r(x<t) 在 qt 和 pt 之间进行选择,则产生的下一 token 分布可写为
π(v)=(1−r(x<t))qt(v)+r(x<t)pt(v).等价地,系统可以使用分布级决策函数 δ(q,p)∈{0,1} 并定义
Tδ(q,p)(v)=(1−δ(q,p))q(v)+δ(q,p)p(v).该形式化使得此前近似 oracle 式的规则也能推测执行。特别地,大模型可以对草拟前缀并行运行,从而可以评估同时依赖 qt 和 pt 的规则,例如 diff 规则,而无需传统级联带来的顺序开销。
该方法的一个关键模块是成本感知推迟规则。在推测级联中,推迟不仅因为调用大模型而产生成本,还因为推迟会改变目标分布,从而影响草稿 token 被拒绝的概率。对于目标分布
π=(1−r(x<t))qt+r(x<t)pt,从草拟器采样的 token 被拒绝的概率为
r(x<t)DTV(pt,qt),其中
DTV(p,q)=v∈V∑max{0,p(v)−q(v)}是两个分布之间的全变差距离。当两个模型非常一致时,推迟只会造成很少拒绝,成本相对较低。当它们严重不一致时,推迟会增加回滚的概率。
作者将推迟表述为损失与成本的权衡。自然的拉格朗日目标为
Lspec(r;x<t)=Ev∼P(⋅∣x<t)[(1−r(x<t))ℓ(v,qt)+r(x<t)(ℓ(v,pt)+αDTV(pt,qt))].最优规则具有如下形式
r∗(x<t)=1⟺E[ℓ(v,qt)]>E[ℓ(v,pt)]+αDTV(pt,qt).在 0-1 损失下,可以用模型给出的置信度估计替代期望损失,从而得到实用的插入式规则:
r^OPT(x<t)=1⟺vmaxqt(v)<vmaxpt(v)−αDTV(pt,qt).该规则比 Chow 规则更具自适应性,因为推迟的惩罚取决于当前前缀处草拟器与验证器的差异。
该框架还包含 token 特定交错模块。标准级联推迟基于分布级置信度,例如最大 token 概率,决定使用 qt 还是 pt。这种决策可能过于粗略,因为即使草拟器分布非常尖锐,采样的草稿 token 本身也可能较差。为解决这一问题,作者提出 token 特定推迟规则
r(x<t,v)∈{0,1},其中决策同时依赖前缀和候选 token v。目标分布变为
πToken(v)=qt(v)(1−r(x<t,v))+pt(v)η,其中
η=v′∈V∑r(x<t,v′)qt(v′)充当归一化项。这种构造将小模型的概率质量保留在被认为可接受的 tokens 上,并针对被认为有风险的 tokens 将概率质量转移到大模型。
若干插入式变体近似这一 token 特定规则。一个简单版本使用草拟器对候选 token 的概率:
r^TokenV1(x<t,v)=1⟺qt(v)<v′maxpt(v′)−α.另一个版本在大模型下评估候选 token:
r^TokenV2(x<t,v)=1⟺pt(v)<v′maxpt(v′)−α.一个乘性变体为
r^TokenV3(x<t,v)=1⟺pt(v)<v′maxpt(v′)(1−α).例如,使用 TokenV1 时,目标分布在 qt 概率高于阈值的 tokens 上保留草拟器分布,并用重新缩放后的 pt 版本替换剩余概率质量。这能实现两个模型更细粒度的交错,并能比直接使用固定有损推测目标提供更广的成本与质量权衡范围,尤其在低温度、P-sampling 或贪婪解码条件下。
实验
实验比较 token 级级联、标准推测解码和提出的推测级联,在翻译、摘要、推理、编码和问答任务上使用 T5 和 Gemma 模型,并在不同采样和少样本设置下进行。权衡分析表明,级联可以面向任务标签分布,而不只是匹配大模型,并且有时能超过大模型质量;而推测解码则优先保持大模型保真度和并行执行。在 T5 和 Gemma 设置中,推测级联,尤其是带有 token 特定推迟时,通常比顺序级联或标准推测解码提供更灵活、更好的成本与质量权衡,尽管它们使用更多总计算量。
上述推理策略比较 token 目标分布,这些分布要么匹配较大模型,要么通过推迟决策混合小模型与大模型概率。推迟规则依赖草拟器置信度、模型分歧或验证器优势;执行方式可以是顺序式、oracle 式或推测式。该框架支持推测级联,旨在改善成本与质量权衡,同时保留较多较大模型质量。标准推测解码以大模型分布为目标,而有损变体则放松精确匹配。SpecCascade 方法使用由二元推迟决策控制的混合小模型与大模型概率。在 Gemma 少样本评估中,基于 token 的 SpecCascade 通常能以较低拒绝率匹配或超过较大模型质量。
实验在翻译和摘要任务上比较推测级联、顺序级联和推测解码,并同时使用匹配较大模型的延迟以及在大模型延迟下的最佳质量。推测级联在翻译上表现出最明显的收益:它能在延迟预算内提供强质量,并在匹配大模型质量时有时具有更低延迟。这种权衡依赖任务,部分摘要结果中顺序级联或有损推测解码更优。推测级联在 WMT 上提供最强的相对优势,尤其在质量受大模型延迟约束时。有损推测解码可以在延迟预算内提供最高质量,而推测级联仍接近且具有竞争力。
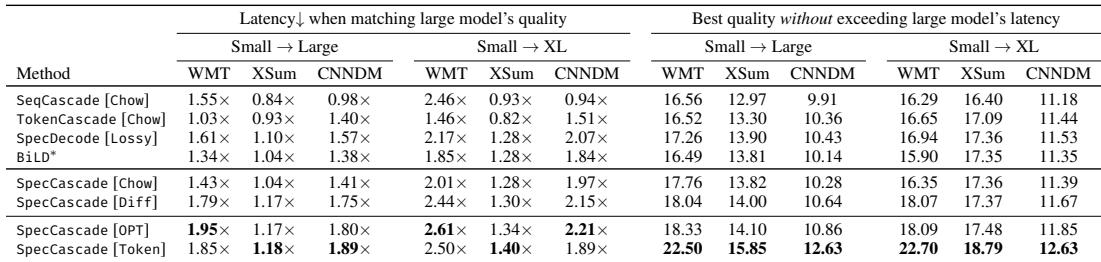
评估在翻译和摘要任务上比较推测级联与顺序级联以及标准或有损推测解码,重点考察延迟约束下的质量,而不是孤立指标。在少样本 Gemma 设置和任务评估中,推测级联通常保留大部分大模型质量,同时降低拒绝率,并提供有利的成本与质量权衡。收益在翻译上最强,尤其当大模型延迟是限制因素时;而摘要可能更偏好顺序级联或有损推测解码,具体取决于预算。