Command Palette
Search for a command to run...
LEARNING DYNAMICS OF LLM FINETUNING
LEARNING DYNAMICS OF LLM FINETUNING
Yi Ren Danica J. Sutherland
摘要
Learning dynamics, which describes how the learning of specific training examples influences the model's predictions on other examples, gives us a powerful tool for understanding the behavior of deep learning systems. We study the learning dynamics of large language models during different types of finetuning, by analyzing the step-wise decomposition of how influence accumulates among different potential responses. Our framework allows a uniform interpretation of many interesting observations about the training of popular algorithms for both instruction tuning and preference tuning. In particular, we propose a hypothetical explanation of why specific types of hallucination are strengthened after finetuning, e.g., the model might use phrases or facts in the response for question B to answer question A, or the model might keep repeating similar simple phrases when generating responses. We also extend our framework and highlight a unique "squeezing effect" to explain a previously observed phenomenon in off-policy direct preference optimization (DPO), where running DPO for too long makes even the desired outputs less likely. This framework also provides insights into where the benefits of on-policy DPO and other variants come from. The analysis not only provides a novel perspective of understanding LLM's finetuning but also inspires a simple, effective method to improve alignment performance. Code for experiments is available at https://github.com/Joshua-Ren/Learning_dynamics_LLM.
一句话总结
不列颠哥伦比亚大学与 Amii 提出了一个框架,用于分析大语言模型微调的学习动态,通过分解影响如何在候选回复之间累积,从而统一解释幻觉强化、离策略 DPO 中的挤压效应,以及同策略 DPO 的优势,并启发一种简单的对齐性能提升方法。
核心贡献
-
论文为大语言模型微调提出了一种逐步学习动态框架,该框架分解模型预测变化,并统一分析指令微调、直接偏好优化及其变体,以及基于强化学习的方法。
-
该框架解释了一些违反直觉的微调行为,包括幻觉增强、生成回复中反复出现简单短语,以及在离策略直接偏好优化中使期望输出概率降低的挤压效应。
-
受该分析启发,论文提出了一种简单的对齐性能提升方法,并提供了实验代码。
引言
大语言模型通常通过指令微调和偏好微调进行对齐,以更可靠地遵循人类指令和偏好。以往的分析通常关注训练目标、终点行为或与强化学习的联系,但对微调过程中模型预测如何逐步演化解释较少。作者利用学习动态推导了监督微调、DPO 变体和基于强化学习方法下预测变化的统一分解。该框架解释了输出重复、幻觉和离策略 DPO 中置信度衰减等违反直觉行为,并识别出梯度上升带来的挤压效应,进而启发了一种更好的对齐方法。
数据集
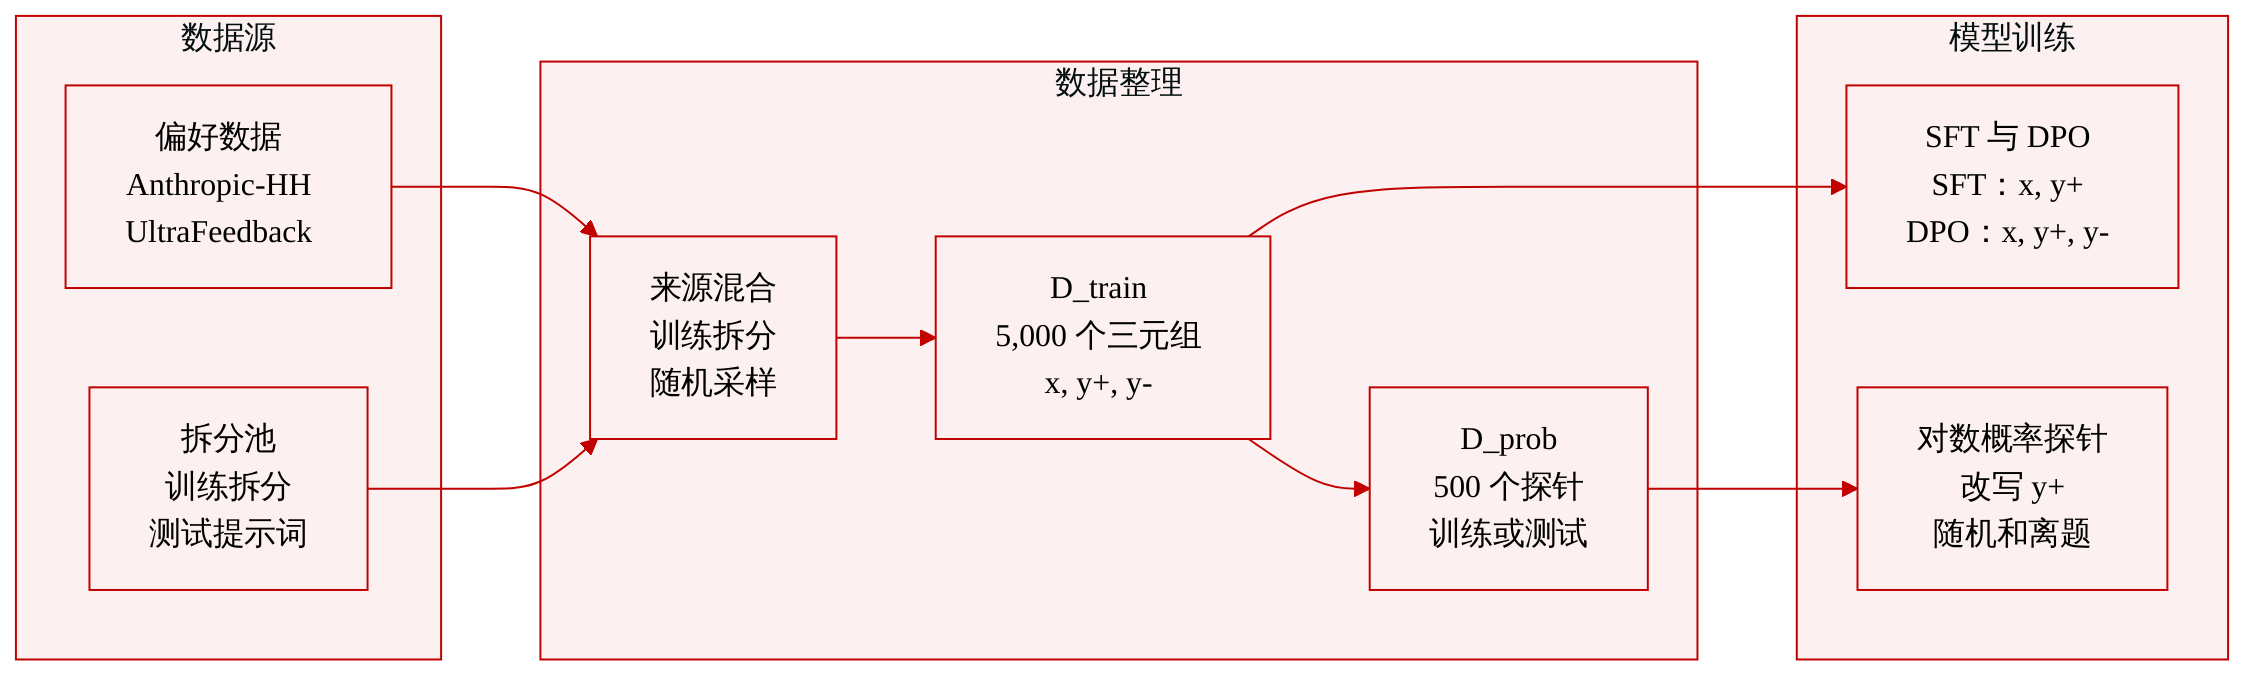
-
作者使用两个人类偏好数据集 Anthropic-HH 和 UltraFeedback 构建一个小型训练子集,用于实验分析。
-
主训练集 D_train 包含从训练划分中随机抽取的 5,000 个样本。每个样本包含三个组件:提示或问题 x、更偏好的回复 y+、以及更不偏好的回复 y-。
-
论文以两种方式使用该数据。监督微调仅使用 x 和 y+。DPO 风格学习使用全部三个字段:x、y+ 和 y-。
-
为更详细地研究学习动态,作者通过从 D_train 随机抽取 500 个样本创建了一个探测数据集 D_prob。
-
对于每个探测提示 x,他们生成若干额外回复类型,以检查模型如何在不同输出上分配概率。这些包括 y+ 的改写、对另一个问题 x' 的无关回复,以及与 y+ 词长相同且随机生成的英文句子。
-
在附录消融实验中,作者还考虑了一种探测变体,其中提示来自测试集。
-
探测集用于检查不同回复类型在对数概率上随训练发生的变化,从而比标准训练样本更细致地观察预测如何演化。
方法
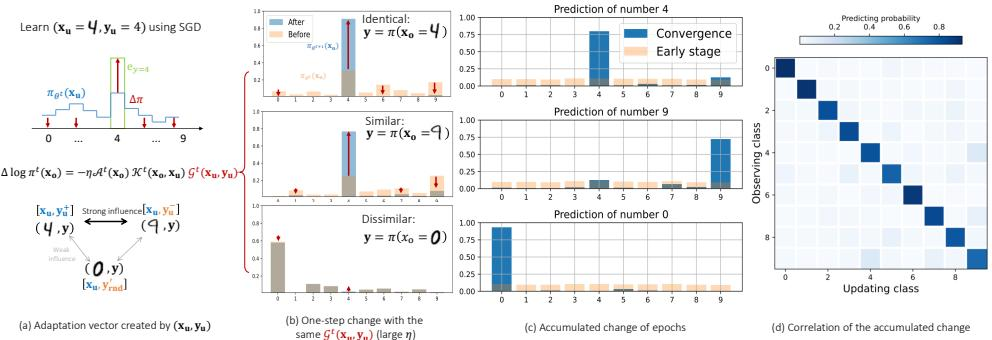
作者利用一个学习动态框架,将更新样本 (xu,yu) 上的一次梯度更新与观察样本 xo 上的预测变化联系起来。对于产生 logits z=hθ(x) 然后应用 softmax 得到 πθ 的模型,学习率为 η 的梯度下降步可写为
Δθ=−η∇θL(fθ(xu),yu).该框架通过测量模型在另一输入上置信度的变化来跟踪 resulting change
Δlogπt(y∣xo)≜logπθt+1(y∣xo)−logπθt(y∣xo).对于单个预测向量,这一每步变化可分解为三个可解释因子:
V×1Δlogπt(y∣xo)=−ηV×VAt(xo)V×VKt(xo,xu)V×1Gt(xu,yu)+O(η2).这里,
At(xo)=∇zlogπθt(y∣xo)=I−1πθt⊤(xo),因此该项只取决于当前预测分布。该项
Kt(xo,xu)=∇θz(xo)∇θz(xu)⊤是 logit 网络的经验神经正切核,充当更新输入与观察输入之间的模型特定局部相似度。最后一项
Gt(xu,yu)=∇zL(xu,yu)由损失决定,并提供更新的方向和强度。对于带有硬标签的交叉熵损失,该项从当前预测分布指向目标 one-hot 分布。
该分析假设,在训练期间,从 xu 学习对不同观察输入的相对影响相当稳定。在该假设下,Kt 的幅值可解释为相似度信号。如果 ∥Kt∥F 很大,则可以预期从 xu 学习会强影响模型在 xo 上的预测。如果它很小,影响则较弱。下面 MNIST 示例说明了这一直觉:对某个数字的一次更新会提升同一数字的概率,间接提升来自其他类别的相似数字的概率,并对不相似输入影响很小。
同一分解被扩展到大语言模型微调,将提示和回复视为一个拼接序列。令
χ=[x,y],其中 y=[y1+,…,yL+] 是长度为 L 的补全。模型输出 logits
z=hθ(χ),z 的每一列由 softmax 归一化,以产生下一个 token 的条件分布。因果掩码确保 token l 的预测不使用未来 tokens y>l。通过这一构造,经验核成为跨 token 位置的张量,
Kt(χo,χu)∈RV×V×L,第 m 个观察 token 的对数概率变化可写为
[Δlogπt(y∣χo)]m=−l=1∑Lη[At(χo)]m[Kt(χo,χu)]l[Gt(χu)]l+O(η2).对于监督微调,损失是期望回复的负对数似然:
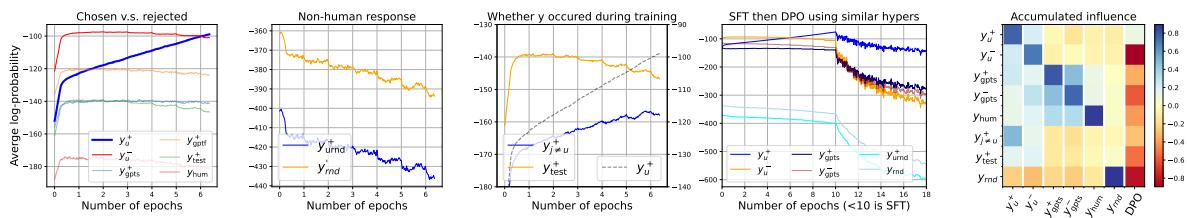
LSFT(xu,yu+)=−l=1∑Llogπ(y=yl+∣y<l+,xu).相应残差项大致是模型当前预测分布与目标 token 分布之间的差异。因此,监督微调对期望回复 yu+ 产生向上的压力,对经验核下与 yu+ 相似的回复产生较弱的间接向上压力,并对剩余概率质量产生向下的压力,因为分布必须求和为一。下面的 SFT 动态展示了不同回复类型在这些组合压力下的移动。
偏好微调改变了更新的几何结构,因为它引入正梯度和负梯度。对于直接偏好优化,损失比较选定回复 yu+ 和拒绝回复 yu−,相对于参考策略 πref:
LDPO(θ)=−E(xu,yu+,yu−)∼D[logσ(βlogπref(yu+∣χu+)πθt(yu+∣χu+)−βlogπref(yu−∣χu−)πθt(yu−∣χu−))].在 teacher forcing 下,每步更新可分解为两个竞争项:
[Δlogπt(y∣χo)]m=−l=1∑Lη[At(χo)]m([Kt(χo,χu+)]lGDPO+t−[Kt(χo,χu−)]lGDPO−t)+O(η2).残差项为
GDPO+t=β(1−a)(πθt(y∣χu+)−yu+), GDPO−t=β(1−a)(πθt(y∣χu−)−yu−).标量 a 反映了当前策略相对于参考策略在多大程度上已经分离了选定回复与拒绝回复。随着边距增大,更新强度自动降低。系数 β 控制正则化效应:当模型落后于参考分离时,较大的 β 可以增强更新;但当模型已经实现正边距时,它也可以抑制更新。下面的图示总结了监督微调、直接偏好优化和相关偏好方法诱导的不同更新向量。
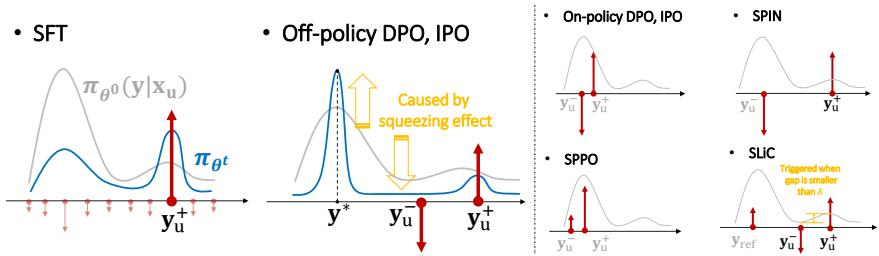
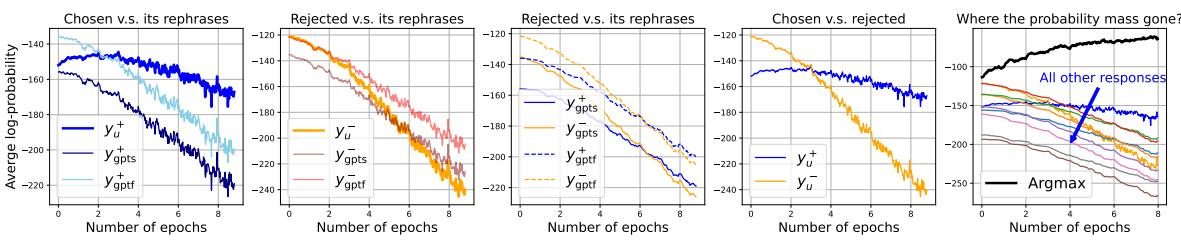
偏好微调引入的关键额外现象是挤压效应。当对低概率回复 yu− 施加强负梯度时,在尖锐的预训练分布下,softmax 归一化会将移去的概率质量重新分配给原本最自信的输出。令
y∗=argi∈[V]∖{yu−}maxπθt(y=i).则更新保证 πθt+1(y=yu−) 减小,而移去的大部分内容被挤压进 πθt+1(y=y∗)。这产生富者愈富模式:高概率区域倾向于增加,低概率区域倾向于减少,更尖的初始分布会强化这一效应。在实际偏好微调中,许多被追踪的回复,包括选定回复、拒绝回复和改写,都可能在 log 概率上衰减,而概率质量则累积在当前 argmax 或贪婪解码回复中。下面离策略 DPO 曲线使这一概率质量流动变得可见。
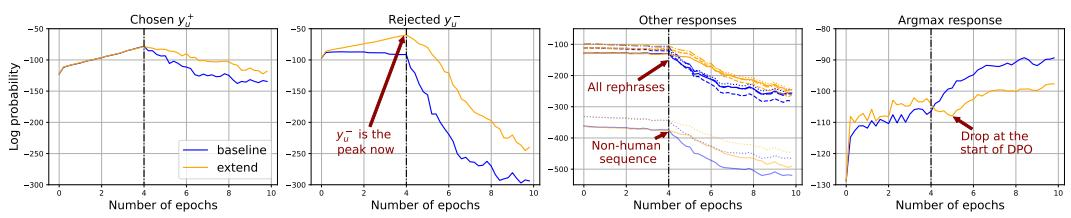
基于这一机制,作者提出了一个扩展的微调流程。流程不是仅在 [xu;yu+] 上进行监督微调,而是在监督阶段也训练 [xu;yu−]。这会在偏好优化阶段开始前提升拒绝回复及其局部邻域的概率。因此,当直接偏好优化随后对 yu− 应用负梯度时,该梯度作用于分布中更合理的区域,而不是极低的概率谷。由此得到的监督微调阶段同时拉高选定区域和拒绝区域,随后的偏好阶段则可以用更弱的挤压效应压低拒绝回复。下面的学习动态比较了基线流程与这一扩展训练设计。
实验
实验使用偏好数据集和若干小语言模型,并辅以代表回复的探测数据集,检查 SFT 和 DPO 如何更新不同回复类型上的可能性。它们证实,SFT 直接强化偏好回复,并间接影响相似回复,而无关训练目标会提升跨问题置信度,这提供了类似幻觉行为的机制。DPO 分析表明,偏好与不偏好回复上的梯度会传播到邻近回复并产生不断增长的偏好边距,同时揭示了一种可能锐化过度自信退化输出的挤压效应。包含不偏好回复的增广 SFT 阶段可缓解这一挤压效应,并在随后的 DPO 训练后带来更好的生成质量。
在 DPO 期间,扩展 SFT 流程在 ChatGPT 和 Claude 的评价中都优于基线,尽管在 DPO 之前胜率较低。改进出现在 DPO 训练之后,在中间 epoch 具有最强优势,随后虽有下降,但仍领先于基线。这些结果支持了这样的观点:在 SFT 期间包含负向回复可以缓解挤压效应并提升最终偏好性能。扩展 SFT 流程在 DPO 之前的评审偏好中落后于基线。DPO 之后,它相对于基线在 ChatGPT 和 Claude 上都获得一致的偏好优势。该优势在中间 DPO epoch 最大,随后减小但仍保持有利。
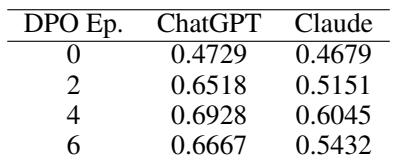
实验比较了包含负向回复的扩展 SFT 流程和使用 ChatGPT 与 Claude 偏好判断的基线(在 DPO 期间)。尽管扩展流程在 DPO 前不被偏好,但它在 DPO 后变得一致地被偏好,最强优势出现在中间训练 epoch,随后部分下降。这些定性结果提示,在 SFT 期间纳入负向回复可以减少挤压效应并带来更好的最终偏好结果。