Command Palette
Search for a command to run...
ALPHAEDIT: NULL-SPACE CONSTRAINED KNOWLEDGE EDITING FOR LANGUAGE MODELS
ALPHAEDIT: NULL-SPACE CONSTRAINED KNOWLEDGE EDITING FOR LANGUAGE MODELS
Junfeng Fang Houcheng Jiang Kun Wang Yunshan Ma Jie Shi Xiang Wang Xiangnan He Tat-Seng Chua
摘要
Large language models (LLMs) often exhibit hallucinations, producing incorrect or outdated knowledge. Hence, model editing methods have emerged to enable targeted knowledge updates. To achieve this, a prevailing paradigm is the locating-then-editing approach, which first locates influential parameters and then edits them by introducing a perturbation. While effective, current studies have demonstrated that this perturbation inevitably disrupts the originally preserved knowledge within LLMs, especially in sequential editing scenarios. To address this, we introduce AlphaEdit, a novel solution that projects perturbation into the null space of the preserved knowledge before applying it to the parameters. We theoretically prove that this projection ensures the output of post-edited LLMs remains unchanged when querying about the preserved knowledge, thereby mitigating the issue of disruption. Extensive experiments on various LLMs, including LLaMA3, GPT2-XL, and GPT-J, show that AlphaEdit boosts the performance of most locating-then-editing methods by an average of 36.7% with a single line of additional code for projection solely. Our code is available at: https://github.com/jianghoucheng/AlphaEdit.
一句话总结
来自中国科学技术大学和新加坡国立大学的研究人员提出了 AlphaEdit,该方法将参数扰动投影到保留知识的零空间中,以防止在顺序编辑大语言模型的过程中发生破坏;该方法从理论上保证保留查询的输出不变,并将现有定位再编辑方法平均提升 36.7%。
核心贡献
- 论文提出 AlphaEdit,在将参数扰动应用于大语言模型之前,先将其投影到保留知识键矩阵的零空间中,从而在减少既有知识干扰的同时实现定向知识更新。
- 该方法给出了理论表述,表明这种零空间投影能够保持针对保留知识的查询输出不变,同时仍允许更新被编辑知识;并且该投影可用一行代码加入。
- 在 LLaMA3、GPT2-XL 和 GPT-J 上的实验表明,AlphaEdit 使多数定位再编辑方法平均提升 36.7%,在保留知识的同时改善编辑性能。
引言
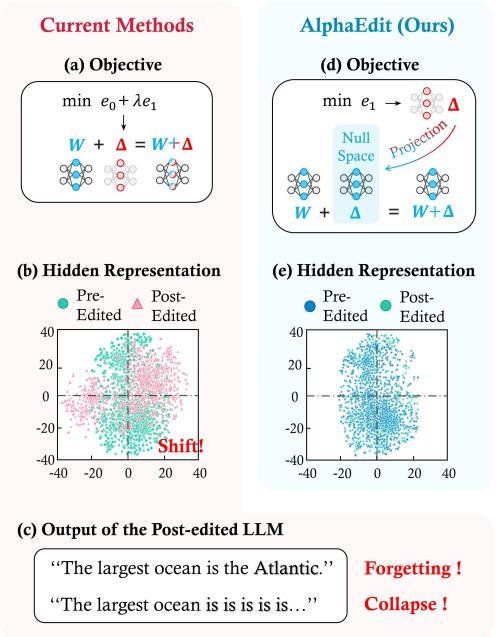
大语言模型能够存储和回忆大量知识,但常常生成过时或错误的事实,而在资源受限环境中,完整微调通常成本过高。模型编辑方法通过以尽可能小的改动更新特定存储知识来应对这一问题,尤其是调整前馈层权重的参数修改式定位再编辑方法。一个关键限制是,现有方法难以在更新目标知识与保留既有知识之间取得平衡:过度最小化更新误差可能会改变隐藏表示、过拟合新事实,并在顺序编辑过程中导致遗忘或模型崩塌。作者提出 AlphaEdit,它从目标函数中移除保留知识损失项,并将参数更新投影到保留键矩阵的零空间中。这能在更新事实的同时保留模型的隐藏表示分布,并且可作为简单的即插即用增强,将现有编辑方法平均提升 36.7%。
方法
作者将 AlphaEdit 提出为一种基于投影的模型编辑方法。其核心思想是,将参数更新限制在保留知识上不激活的子空间中,而不是通过分离的损失项来平衡知识更新与知识保留。设 W 为待编辑的选定权重矩阵,设 (K0,V0) 为保留键值关联,设 (K1,V1) 为当前需要更新的知识。
该方法首先定义左零空间。矩阵 B 属于 A 的左零空间,当且仅当
BA=0.如果可加扰动 Δ′ 满足 Δ′K0=0,那么将其应用于原始参数得到
(W+Δ′)K0=WK0+Δ′K0=WK0=V0.因此,投影后的扰动不会改变与保留知识相关联的输出。AlphaEdit 因而首先构造一个投影矩阵,在候选扰动被应用于模型之前,将其映射到保留知识的零空间中。
直接投影到 K0 的零空间代价高昂,因为 K0 可能具有非常大的列数。作者转而使用协方差矩阵 K0K0T∈Rd0×d0 的零空间,因为当 d0 远小于保留样本数量时,这个较小的矩阵与 K0 共享相同的零空间,同时处理起来代价低得多。作者计算
{U,Λ,UT}=SVD(K0K0T),其中,U 的列向量是 K0K0T 的特征向量。对应非零特征值的特征向量被移除,剩余子矩阵 U^ 用于定义投影矩阵
P=U^U^T.该矩阵将扰动的列向量映射到 K0 的零空间中。因此,对于投影扰动 ΔP,该更新保留原始键值关联:
(W+ΔP)K0=WK0=V0.在获得该投影后,作者修改了通常的模型编辑目标。与其同时最小化待更新知识上的误差和保留知识上的误差,他们将原始扰动 Δ~ 替换为投影扰动 Δ~P。由于投影已经保证 K0 被保留,可以移除显式保留项。他们还加入正则项 ∥Δ~P∥2 来稳定解,得到
Δ=Δ~argmin(∥(W+Δ~P)K1−V1∥2+∥Δ~P∥2).对于顺序编辑,该方法还会保护已被先前编辑更新过的知识。设 (Kp,Vp) 为先前更新过的键值关联。相应的保护项为
∥(W+Δ~P)Kp−Vp∥2.因为之前的编辑已经使 WKp=Vp,该项简化为
∥Δ~PKp∥2.因此,顺序编辑目标变为
Δ=Δ~argmin(∥(W+Δ~P)K1−V1∥2+∥Δ~P∥2+∥Δ~PKp∥2).作者将当前编辑残差定义为
R=V1−WK1.通过求解对应的正规方程,得到闭式投影扰动:
ΔAlphaEdit=RK1TP(KpKpTP+K1K1TP+I)−1.该更新旨在将当前知识纳入模型,同时保持保留知识和先前更新知识稳定。与 MEMIT 等常见闭式编辑方案的关键区别,在于将投影矩阵 P 插入更新路径中。作为比较,标准未投影解具有如下形式
ΔMEMIT=RK1T(KpKpT+K1K1T+K0K0T)−1.AlphaEdit 变体用投影零空间约束替换了显式保留项。可参考框架图。
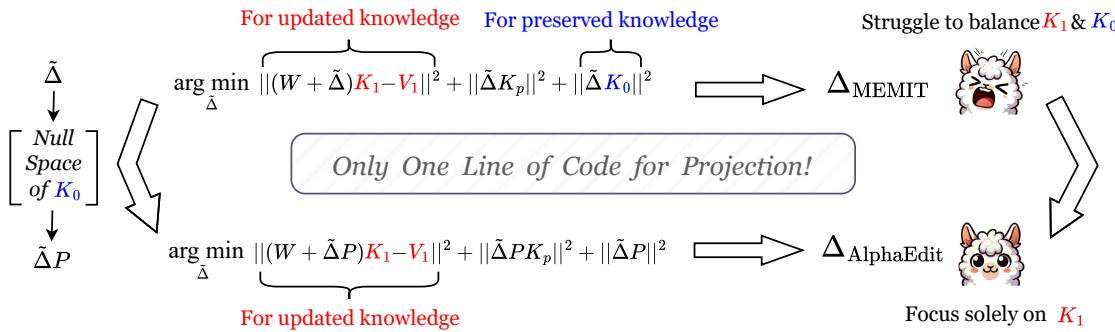
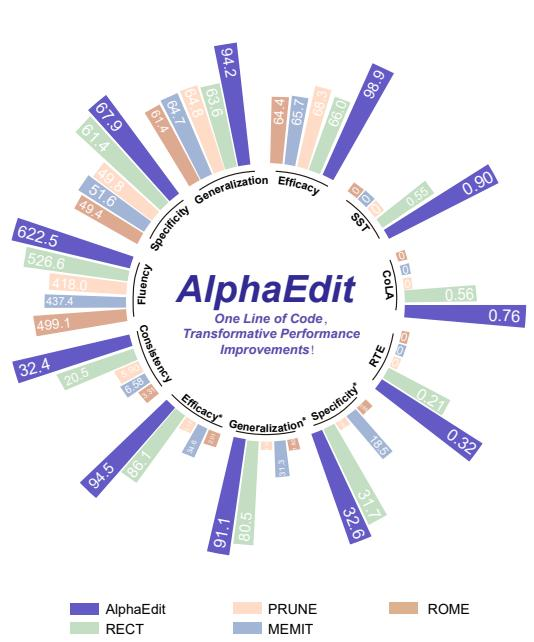
投影矩阵 P 仅取决于保留知识,而不取决于具体执行的更新。因此,它可以计算一次并在许多编辑操作中复用。这使得相对于现有编辑流程的额外计算开销很小。如下图所示,这种简单面向投影的修改能够带来更强的编辑性能,同时在评估设置中保持通用能力。
实验
实验在多个大语言模型和编辑基线上评估了 AlphaEdit 的顺序知识编辑、通用能力保持和隐藏表示稳定性。结果表明,AlphaEdit 更好地平衡知识更新、知识保留和流畅性,而基线方法通常会降低通用能力并扭曲内部表示。该投影策略也改善了现有编辑方法,表明其具有广泛适用性和有效性。
AlphaEdit 在多个基座模型上的顺序知识编辑中取得最强综合结果,在更新有效性和泛化方面提升尤为明显。它还更好地保留生成质量,提升流畅性和一致性,同时避免若干基线中出现的严重退化。这些趋势表明,更好地平衡知识更新与保留是其优势的核心。AlphaEdit 在几乎所有测量的编辑指标和基座模型上都优于基线。该方法缩小了编辑有效性与泛化之间的权衡,在 LLaMA3 上的提升尤其显著。若干基线在顺序编辑过程中大幅失去泛化或一致性,而 AlphaEdit 保持更强的整体保持能力。
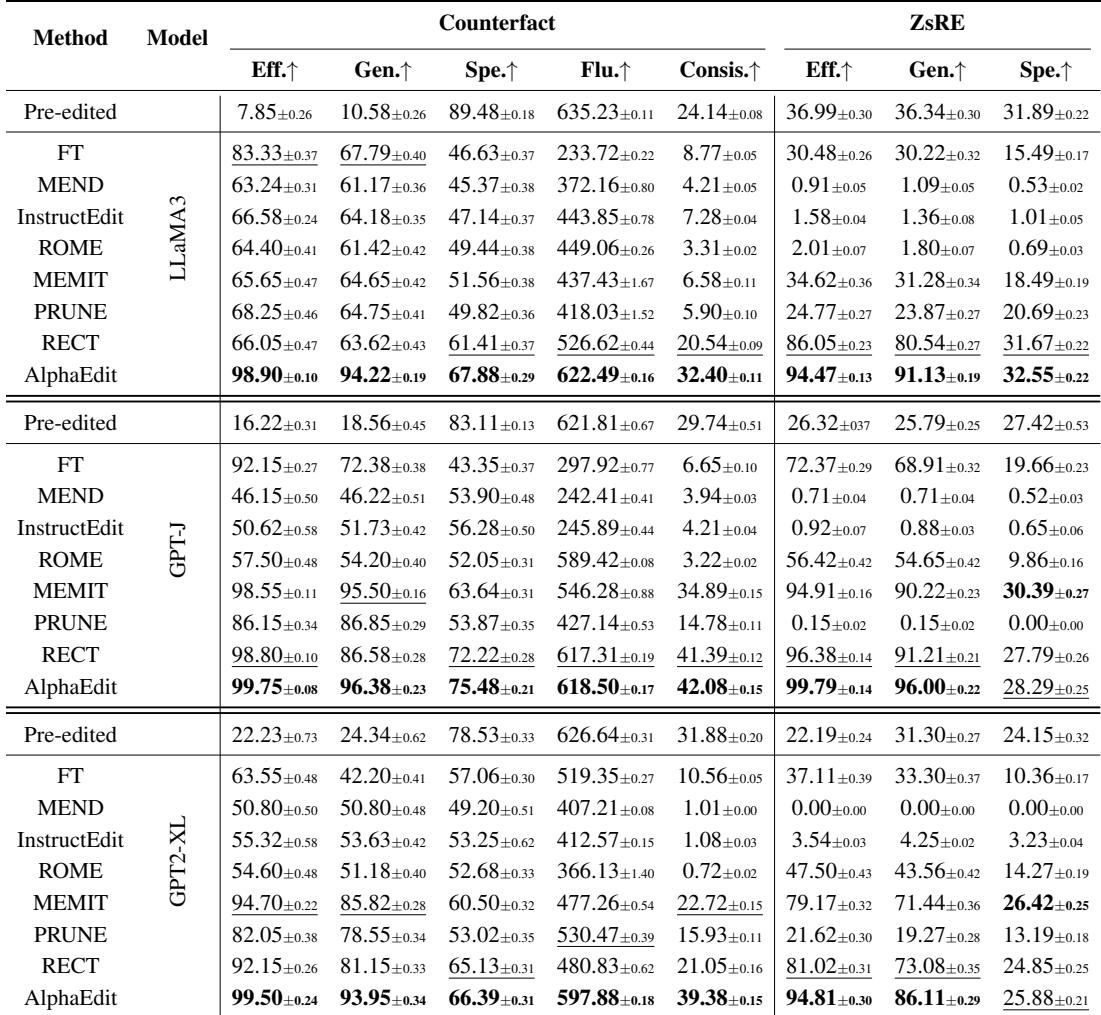
实验评估了多个基座模型上的顺序知识编辑,结果表明 AlphaEdit 通过提升更新有效性和泛化,同时保持生成质量,取得最强综合性能。与基线相比,它更好地平衡了知识更新与保留,在 LLaMA3 上的提升尤为显著。结果说明,保持流畅性和一致性是其优势的核心,而若干基线在顺序编辑过程中急剧退化。