Command Palette
Search for a command to run...
SAM 2:在图像和视频中分割一切
SAM 2:在图像和视频中分割一切
摘要
我们提出了 Segment Anything Model 2(SAM 2),这是一个基础模型,旨在解决图像和视频中的可提示视觉分割问题。我们构建了一个数据引擎,通过用户交互来改进模型和数据,从而收集了迄今为止最大的视频分割数据集。我们的模型是一个简单的 Transformer 架构,带有流式内存,用于实时视频处理。基于我们的数据训练的 SAM 2 在广泛的任务上展现出强大的性能。在视频分割方面,我们观察到更高的准确性,并且比先前方法减少了 3 倍的交互次数。在图像分割方面,我们的模型比 Segment Anything Model(SAM)更准确且快 6 倍。我们相信,我们的数据、模型和见解将成为视频分割及相关感知任务的一个重要里程碑。我们正在发布我们的主要模型、数据集、交互式演示和代码。
一句话总结
Meta FAIR 推出了 SAM 2,这是一个用于图像和视频中可提示视觉分割的基础模型,基于带流式记忆的 transformer 架构、数据引擎以及最大的视频分割数据集构建,以 3× 更少的交互次数实现更好的视频精度,同时图像分割速度比 SAM 快 6×。
核心贡献
- 本文介绍了 SAM 2,一个用于图像和视频视觉分割的可提示基础模型,基于简单的 transformer 架构和流式记忆构建,支持实时视频处理。
- 本文提出了数据引擎和 SA-V 数据集,这是迄今最大的视频分割数据集,不仅覆盖完整对象,还广泛涵盖对象部分,其 mask 数量比先前的视频分割数据集多一个数量级以上。
- 实验结果表明,SAM 2 以比先前方法少 3× 的交互次数实现更好的视频分割精度,在图像分割方面比 SAM 更精确且快 6×,模型、数据集、交互演示和代码均已公开。
引言
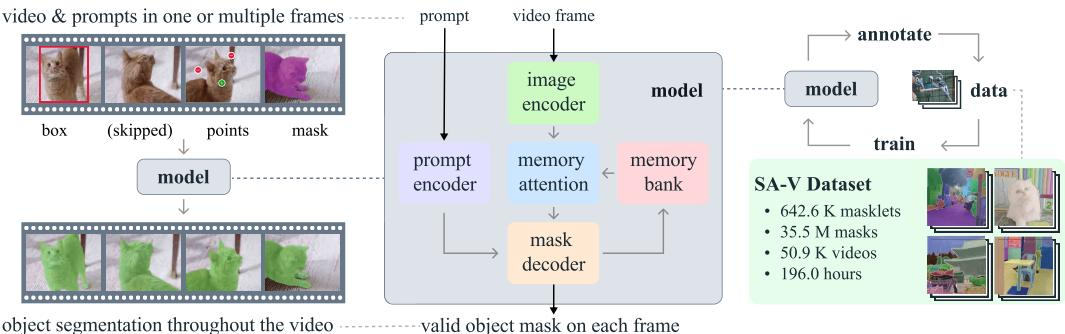
作者解决了仅限图像分割的局限性,这种分割方式无法满足 AR/VR、机器人、自动驾驶汽车和视频编辑等应用所需的时间维度。先前的视频分割模型和数据集难以应对外观变化、遮挡、较低的视频质量以及缺乏交互式精修的问题,并且无法实现"分割视频中的一切"的通用性。作为主要贡献,作者引入了 SAM 2,这是一个统一的可提示视觉分割模型,适用于图像和视频,利用记忆机制实现时间一致性,同时提出了新的 PVS 任务和包含 3550 万个 mask 的 SA-V 数据集。SAM 2 以 3 倍更少的交互次数实现更高精度,在图像上比 SAM 快 6 倍,同时优于先前的视频分割基准。
数据集
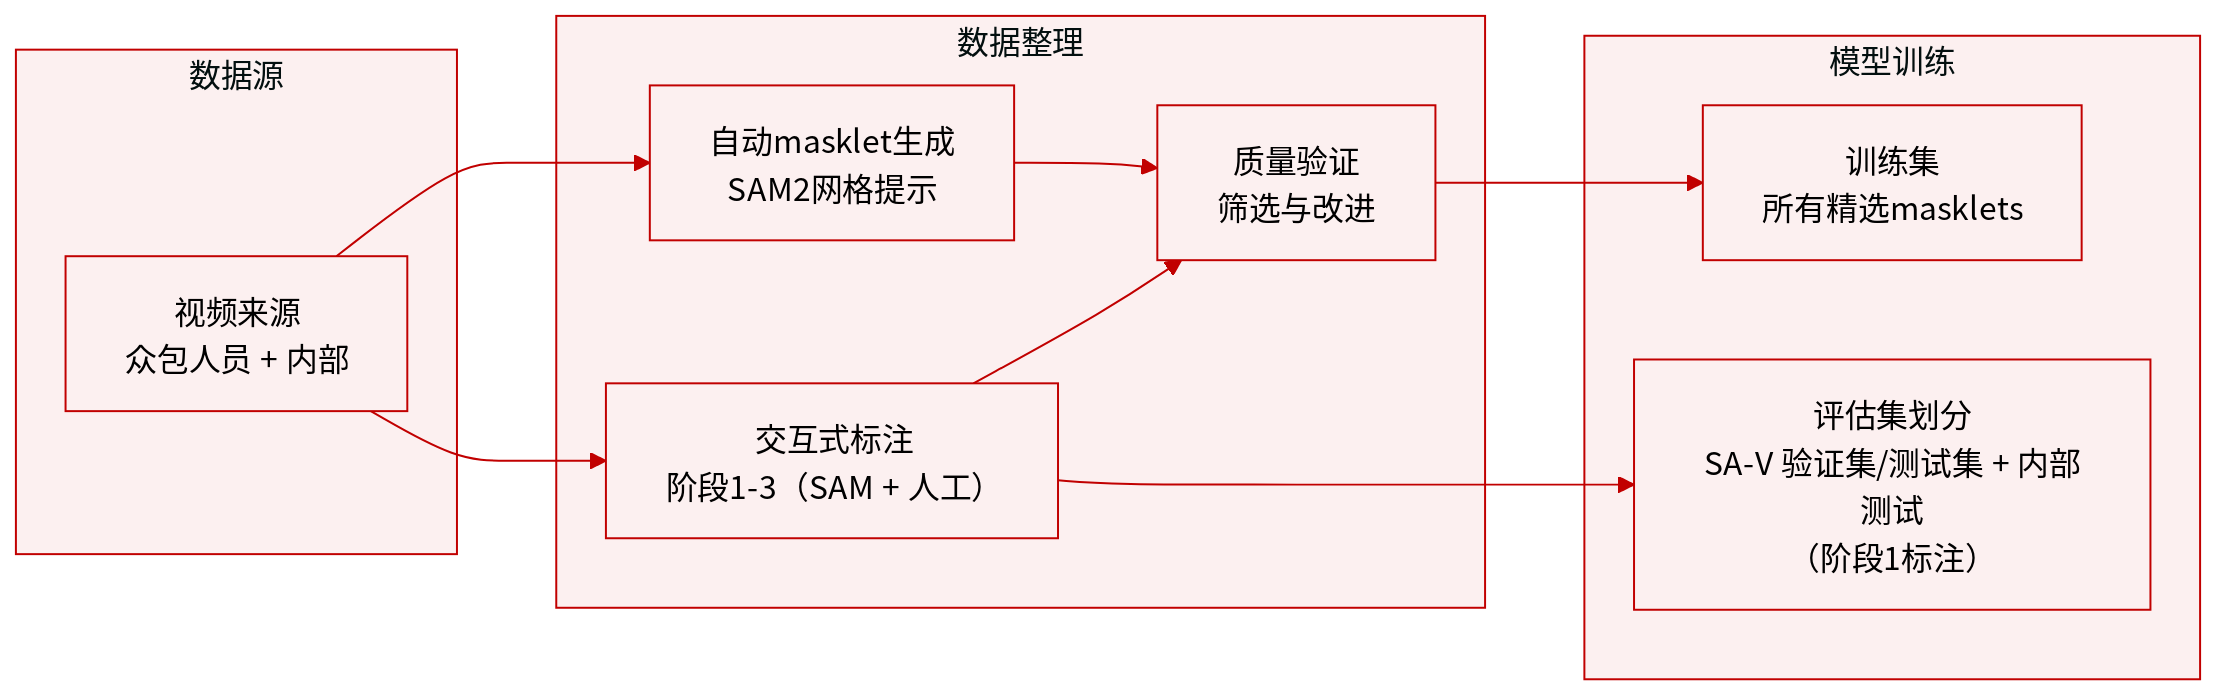
作者构建了一个名为 SA-V 的大规模视频分割数据集,以支持在视频中"分割一切"的目标。该数据集通过数据引擎收集,将交互式模型置于标注流程中,与人工标注者协同工作。标注过程对 masklet 不施加语义约束,标注覆盖完整对象和对象部分。
数据集构成与来源
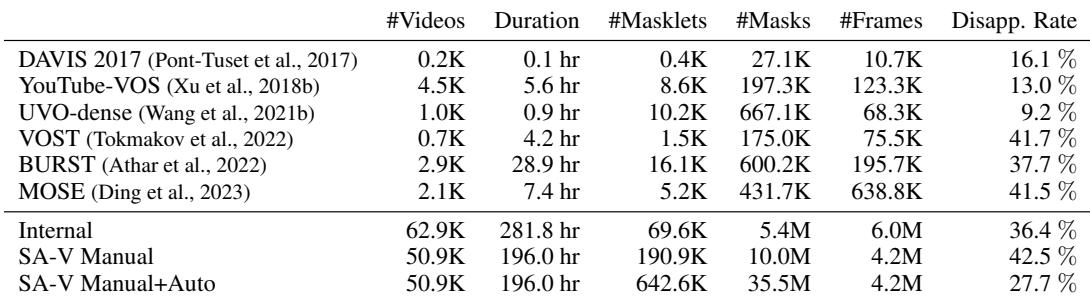
- SA-V 数据集包含 50.9K 个视频和 642.6K 个 masklet,以宽松许可证发布。
- 视频由众包工作者新收集,包含 54% 的室内场景和 46% 的室外场景,平均时长为 14 秒。
- 标注包含 190.9K 个手动 masklet 和 451.7K 个自动 masklet。
- 标注 mask 数量是任何现有 VOS 数据集的 53 倍(不含自动标注时为 15 倍)。
- 数据集中手动 masklet 的消失率为 42.5%,即 masklet 在至少一帧中消失后重新出现,这与现有数据集相当。
数据引擎阶段
作者使用三阶段数据引擎,每个阶段都提高了模型对标注者的辅助程度。
- 阶段 1(逐帧 SAM):标注者使用基于图像的交互式 SAM 以 6 FPS 的速度逐帧标注 mask,并使用像素级精确的手动编辑工具。该阶段没有时间传播,因此逐帧标注质量高但吞吐量较低。该阶段从 1.4K 个视频中收集了 16K 个 masklet,平均每帧标注时间为 37.8 秒。阶段 1 还用于标注 SA-V 验证集和测试集,以避免评估过程中来自 SAM 2 的偏差。
- 阶段 2(SAM + SAM 2 Mask):SAM 2 被引入标注流程,并接受 mask 作为提示。标注者首先在第一帧中生成空间 mask,然后进行时间传播。标注者可以在后续帧中修正预测并重新传播。SAM 2 Mask 在此阶段被重新训练两次。阶段 2 收集了 63.5K 个 masklet,标注时间降至每帧 7.4 秒,比阶段 1 提速 5.1 倍。
- 阶段 3(SAM 2):功能完整的 SAM 2 接受点和 mask 作为提示,并使用时间记忆生成预测。标注者只需偶尔进行精修点击,而无需从头标注。SAM 2 在阶段 3 中被重新训练五次。该阶段收集了 197.0K 个 masklet,标注时间为每帧 4.5 秒,比阶段 1 提速 8.4 倍,同时保持相当的质量。
质量验证与自动 masklet 生成
- 一组独立的标注者将每个 masklet 验证为"合格"(正确且一致地追踪目标对象)或"不合格"。不合格的 masklet 会被送回进行精修,而追踪定义不明确对象的 masklet 会被拒绝。
- 为增加标注多样性,作者通过在第一帧中使用规则网格点提示 SAM 2 来生成自动 masklet。生成的 masklet 通过验证步骤进行过滤。合格的自动 masklet 被添加到数据集中,不合格的会被采样并发送给标注者进行精修,这也有助于识别模型的失败案例。
数据集划分与内部数据
- SA-V 的训练、验证和测试划分基于视频作者及其地理位置进行创建,以最小化相似对象的重叠。
- 验证集包含 155 个视频和 293 个 masklet,测试集包含 150 个视频和 278 个 masklet。两者均侧重于具有挑战性的场景,包括快速移动对象、复杂遮挡以及消失或重现模式。
- 作者还使用了包含许可视频数据的内部数据集,包括阶段 2 和阶段 3 标注的 62.9K 个视频和 69.6K 个 masklet 用于训练,以及阶段 1 标注的 96 个视频和 189 个 masklet 用于测试。
数据在模型中的使用方式
- 数据引擎阶段被迭代用于重新训练 SAM 2,每个阶段收集的标注都会添加到训练集中。
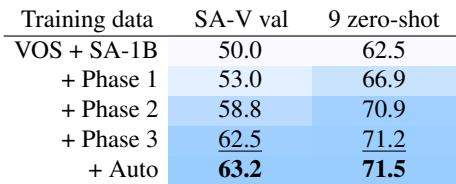
- 作者在保持训练迭代次数不变的情况下比较每个阶段后的模型性能,并观察到在域内 SA-V 验证集和九个零样本基准上,使用第一帧上的三次点击进行提示时均有一致的改进。
方法
作者提出了 SAM 2,这是将 Segment Anything Model (SAM) 推广到视频领域的模型。系统以流式方式处理视频帧,支持实时处理任意长度的视频。该架构将空间分割能力与时间记忆机制相结合,以保持跨帧的对象一致性。
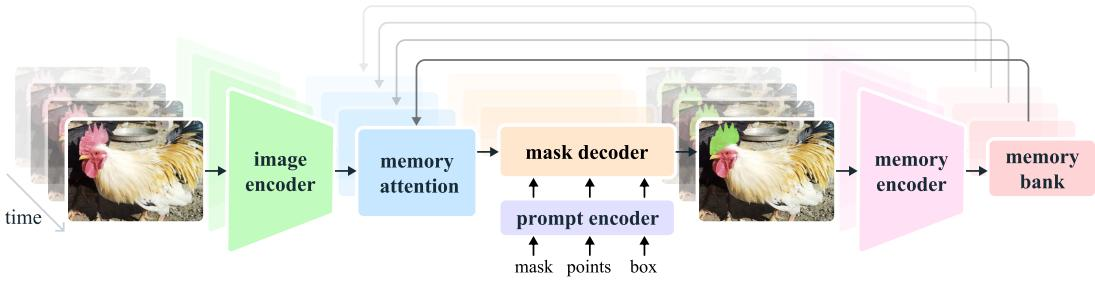
该流程从图像编码器开始,图像编码器每次交互仅运行一次。作者采用分层、MAE 预训练的 Hiera 编码器为每帧生成无条件的特征 token。这种分层设计有助于提取解码所需的多尺度特征。
架构的核心是记忆注意力模块。该组件基于过去预测和提示的记忆来调节当前帧的特征。记忆注意力由堆叠的 transformer 块组成,这些块执行自注意力,然后对记忆库进行交叉注意力。记忆库使用 FIFO 队列结构保留过去预测的信息,最多存储 N 个最近的无提示帧记忆和最多 M 个有提示帧记忆。这些记忆以空间特征图的形式维护。此外,系统存储轻量级的对象指针向量,从 mask 解码器输出中捕获高级语义信息。注意力机制还将时间位置信息嵌入到最近帧的记忆中,以表示短期对象运动。
在注意力机制之后,提示编码器和 mask 解码器生成分割输出。提示编码器接受点、框或 mask 来定义目标对象的空间范围。稀疏提示使用位置编码与学习到的嵌入相加进行编码,而 mask 通过卷积进行嵌入。mask 解码器利用"双向"transformer 块迭代更新提示和帧嵌入。为处理目标对象在部分帧中缺失(例如遮挡期间)的可能性,解码器包含一个额外的头来预测对象是否存在。该设计还包含来自分层图像编码器的跳跃连接,为 mask 解码提供高分辨率嵌入。在存在歧义的情况下,模型会预测多个 mask,并在后续提示未解决不确定性时传播预测交并比 (IoU) 最高的那个 mask。
预测之后,记忆编码器处理结果以供后续使用。它通过卷积模块对输出 mask 进行下采样,并使用轻量级卷积层将其与图像编码器的无条件帧嵌入融合。融合后的表示随后存储在记忆库中。
模型在图像和视频数据上联合训练。训练过程通过采样帧序列并随机选择帧进行初始提示来模拟交互式提示。这些提示可以是真实 mask、正向点击或边界框。训练目标是顺序预测真实 masklet,使模型能够从修正点击中学习并迭代改进其预测。
实验
实验表明,SAM 2 在零样本可提示视频分割方面优于先前方法,在离线和在线设置下的多个基准上以超过 3 倍的更少交互次数实现更高精度。在零样本图像分割中,SAM 2 在比 SAM 快 6 倍的同时提高了精度,并且在图像和视频数据混合上训练可获得进一步提升。在半监督视频对象分割中,SAM 2 以实时推理速度超越了最先进的方法,更大的图像编码器始终带来更好的精度,包括在长期和开放世界视频基准上。
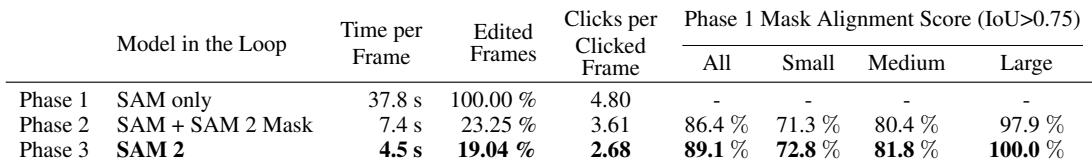
该表格比较了三个数据标注阶段,展示了随着流程中模型的演进,效率和质量逐步提升。使用功能完整的 SAM 2 的阶段 3 实现了最快的标注时间和最低的手动编辑工作量,同时在所有 mask 尺寸上保持或提高了 mask 对齐精度。每帧标注时间从阶段 1 的 37.8 秒降至阶段 2 的 7.4 秒,并进一步降至阶段 3 的 4.5 秒,大约提速 8.4 倍。每个 masklet 的编辑帧比例从阶段 1 的 100% 急剧下降至阶段 2 的 23.25% 和阶段 3 的 19.04%,表明手动干预显著减少。每个被点击帧的手动点击次数从阶段 1 的 4.80 降至阶段 2 的 3.61 和阶段 3 的 2.68,同时所有 mask 尺寸的 mask 对齐度相比阶段 1 都有所提升,在阶段 3 中大型 mask 的对齐度达到 100%。
添加来自连续数据引擎阶段的数据会逐步提高 SA-V 验证集和零样本 VOS 加 SA-1B 组合基准上的分割精度。最大的提升来自引入阶段 2 和阶段 3 的数据,完全交互式的 SAM 2 阶段产生了接近最终的性能。包含额外的自动数据提供了小幅度的进一步提升。从无阶段数据到阶段 1 数据,SA-V 验证集精度提高了 3 个百分点,组合基准提高了 4.4 个百分点。与仅使用阶段 1 数据相比,阶段 2 数据在 SA-V 验证集上增加了 5.8 个百分点,在组合基准上增加了 4.0 个百分点。阶段 3 数据在 SA-V 验证集上贡献了最大的单阶段提升,增加了 3.7 个百分点,同时组合基准进一步提高了 0.3 个百分点。添加自动生成的数据带来了最终的边际改进,SA-V 验证集达到 63.2,组合基准达到 71.5。
所比较的开源视频对象分割数据集在规模上差异很大,其中内部数据在视频数量、时长和 mask 数量方面以显著优势位居首位。各数据集的消失率也有显著差异,有些数据集消失率相对较低,另一些则超过 40%。内部数据集在视频数量、总时长和 mask 数量方面比所有开源替代方案大数个数量级。各数据集的消失率从低于 10% 到超过 40% 不等,其中 VOST 和 MOSE 的消失率最高。时长较长的数据集往往具有较高的消失率,但内部数据集尽管规模庞大,仍保持中等水平的消失率。
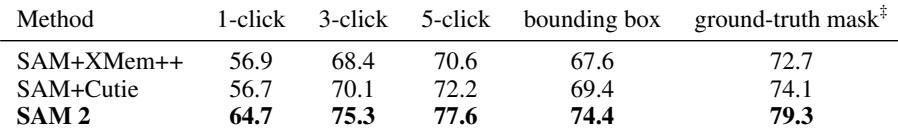
在 17 个视频数据集上,SAM 2 在每种提示类型(包括 1、3 和 5 次点击、边界框和真实 mask)上都比 SAM+XMem++ 和 SAM+Cutie 实现更高的零样本分割精度。精度随着点击次数的增加而持续提高,基于 mask 的提示产生最佳结果,SAM 2 在所有设置中均处于领先地位。SAM 2 在所有提示类型上都优于两个基线,在更高交互水平下提升最大。使用真实 mask 作为提示对所有方法都能实现最高精度,SAM 2 在此设置下保持最佳性能。
SAM 2 在原始 23 个数据集上超过 SAM 的平均零样本精度,同时运行速度超过其六倍,并且通过在图像和视频数据混合上训练可获得进一步提升,尤其是对于零样本视频数据集。使用 SA-1B 数据的 SAM 2 将 23 个标准数据集上的 1 次点击 mIoU 从 58.1 提高到 58.9。在混合数据上训练将 23 个数据集的平均值提高到 61.9,并将 14 个额外视频数据集上的性能从 56.6 提升到 69.6。SAM 2 以 130.1 FPS 运行,比 21.7 FPS 的 SAM 大约快六倍。
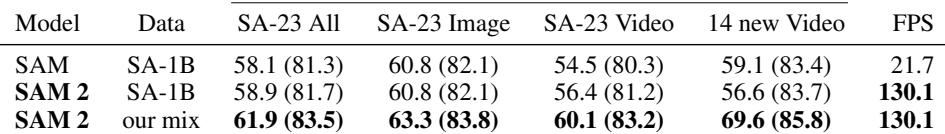
实验评估了用于训练 SAM 2 的迭代数据引擎,表明每个阶段都逐步减少标注工作量和时间,同时保持或提高 mask 对齐度,其中完整的 SAM 2 阶段效率最高。添加来自连续阶段的数据持续提高了验证集和零样本基准上的分割精度,其中交互阶段带来的提升最大。SAM 2 在各种提示类型和数据集上也优于先前基线,同时显著快于 SAM。总体而言,结果证实了通过交互式模型在环阶段扩展数据是实现强大、高效视频分割的关键。