Command Palette
Search for a command to run...
单次训练过程中的 Data Shapley
单次训练过程中的 Data Shapley
Jiachen T. Wang Prateek Mittal Dawn Song Ruoxi Jia
摘要
Data Shapley 为机器学习场景中的数据贡献归因提供了一种原则性框架。然而,传统的 Data Shapley 定义要求在不同数据子集上重新训练模型,这对于大规模模型而言计算上不可行。此外,这种基于重新训练的定义无法评估数据对特定模型训练过程的贡献,而这在实践中往往是人们所关注的。本文提出了一种新概念——In-Run Data Shapley,它无需重新训练模型,专门用于评估数据对特定目标模型的贡献。In-Run Data Shapley 在每次梯度更新迭代中计算 Shapley 值,并在整个训练过程中累加这些值。我们提出了若干技术,使 In-Run Data Shapley 能够高效扩展到基础模型的规模。在其最优化的实现中,我们的方法相比标准模型训练仅引入可忽略不计的运行时开销。这一显著的效率提升使得在基础模型预训练阶段进行数据归因成为可能。我们展示了若干案例研究,为预训练数据的贡献提供了新的见解,并讨论了其对生成式 AI 领域版权问题及预训练数据管理的启示。
一句话总结
普林斯顿大学、加州大学伯克利分校和弗吉尼亚理工大学提出 In-Run Data Shapley,一种在每次梯度更新迭代计算 Shapley 值并在单次训练过程中累积这些值的方法,从而无需重新训练模型,且运行时开销可忽略不计,使基础模型预训练规模的数据归因成为可能,并通过案例研究为生成式 AI 的版权问题和预训练数据整理提供见解。
核心贡献
- 本文提出 In-Run Data Shapley,在每次梯度更新迭代计算 Shapley 值,并在特定训练过程中累积这些值,无需在大量数据子集上重新训练模型。
- 高效的 ghost 系列计算技术将 In-Run Data Shapley 扩展到基础模型预训练,优化后的实现相比标准模型训练仅增加可忽略不计的运行时间开销。
- 实验与案例研究证明预训练数据贡献归因,为生成式 AI 版权与预训练数据整理提供相关见解。
引言
-
作者关注大语言模型等基础模型的数据归因,因为在公平补偿、版权分析、监管风险以及过滤低质量或有害数据方面,了解每个训练来源的影响非常重要。
-
现有 Shapley 值框架为归因提供了理论上的公平基础,但先前方法通常需要反复重新训练,在基础模型规模上计算不可行,并且是针对通用训练算法而非实际正在训练的模型对数据进行打分。
-
作者提出 In-Run Data Shapley,通过在训练过程中用泰勒展开近似一步模型变化,并高效计算所需的梯度点积或梯度 Hessian 梯度交互,来估计训练期间的 Shapley 贡献,使 GPT-2 和 Pythia-410M 等模型的归因成为可能。
数据集
-
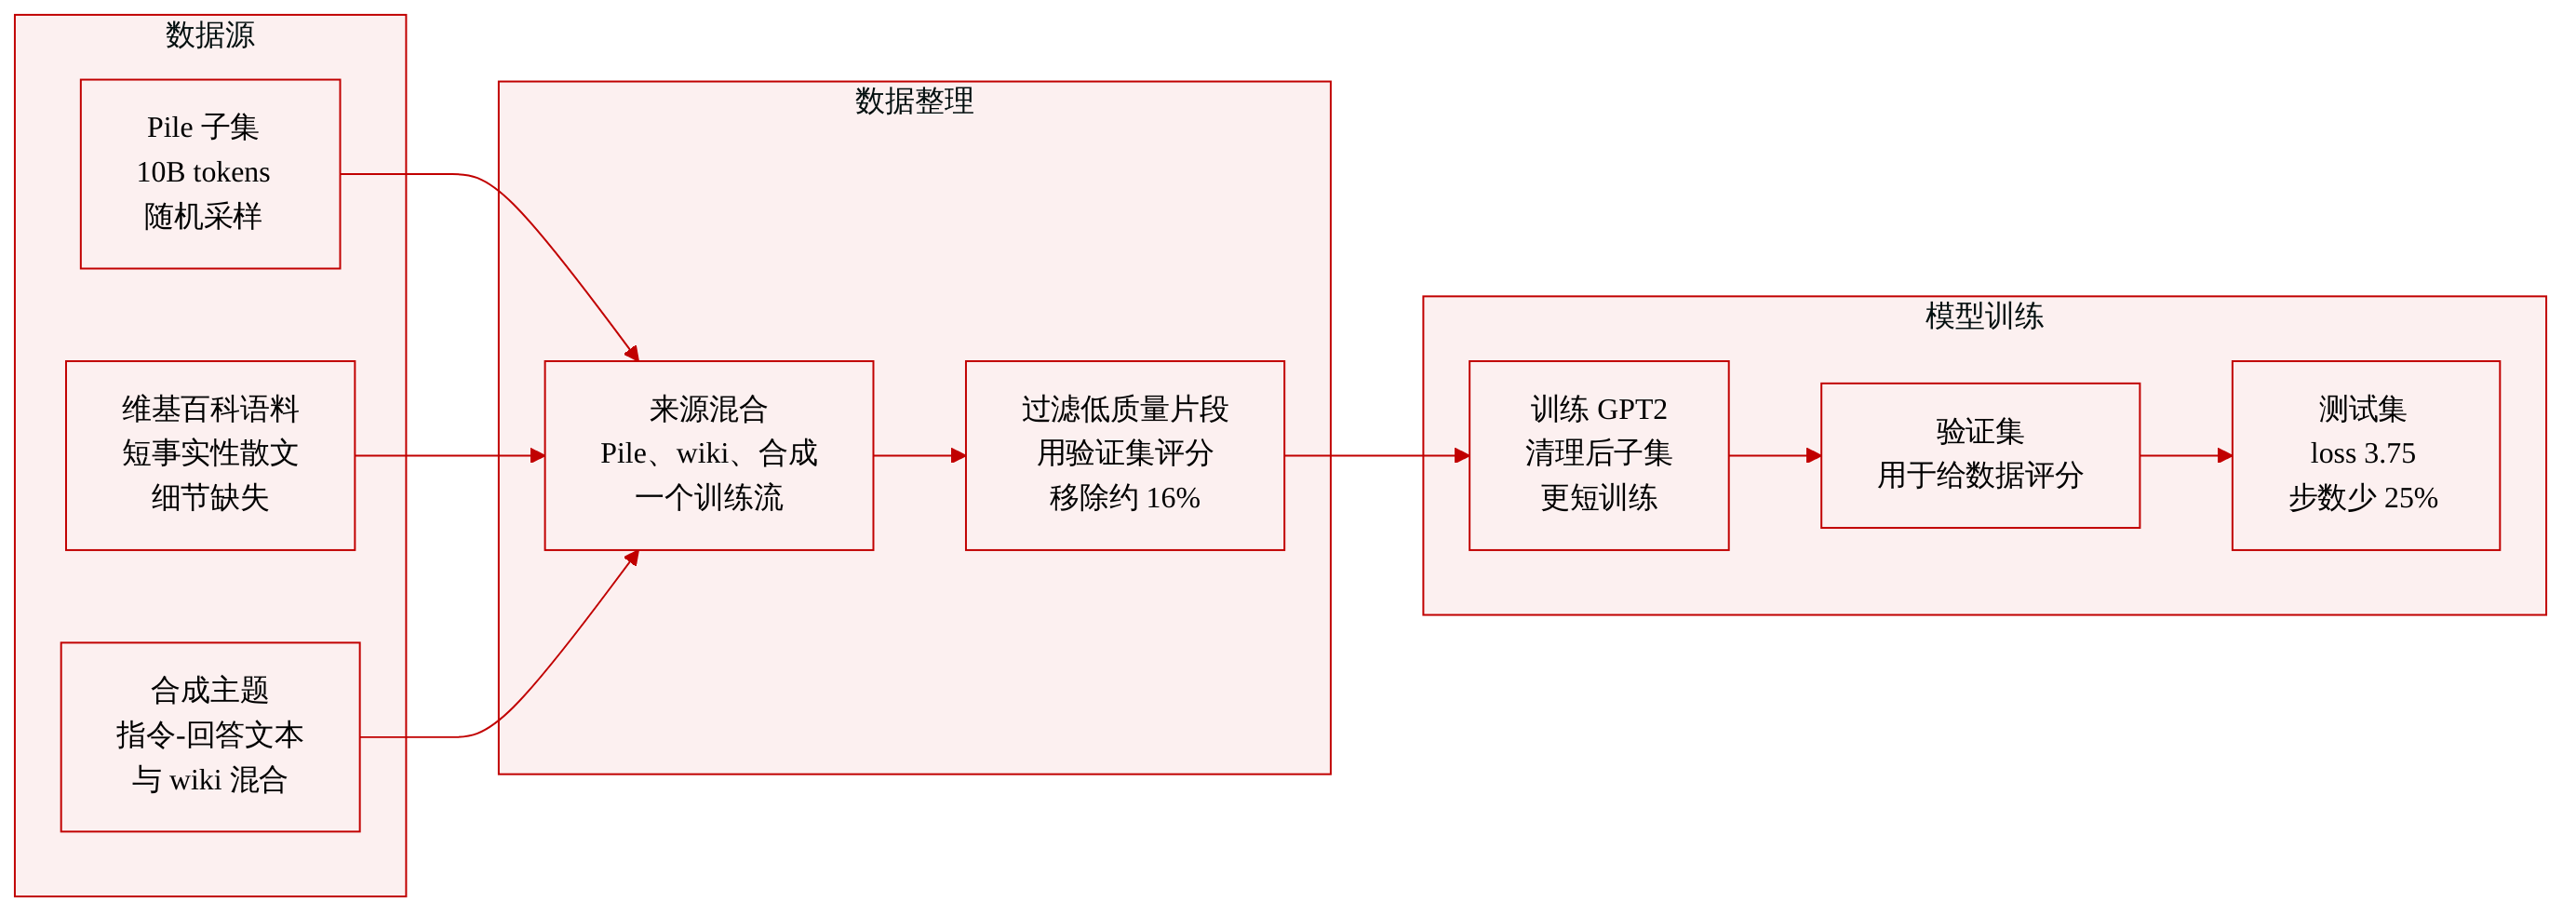
作者使用 Pile 子集作为案例研究中的主要训练语料。他们从 Pile 中均匀采样约 10B tokens,在该子集上训练 GPT2 模型,并针对 Pile 验证集对训练点进行打分。随后,他们移除所有归因值为负的语料,并在清洗后的子集上重新训练。清洗后的数据在约少 25% 的训练迭代下达到 3.75 的测试损失,且约 16% 的子集获得负的二阶归因值。该处理将归因分数视为过滤低质量或有害训练样本的信号。
-
作者还提到原始维基百科语料。它似乎包含简短的事实性或百科全书式散文段落,示例是一段人物传记或历史片段。摘录未报告语料大小、精确过滤规则、模式、训练划分或混合比例。
-
作者在原始维基百科语料下包含一个合成的“相似主题”语料。它包含主题对齐的生成文本,包括指令答案式段落和短相关领域片段。摘录未说明其总大小、过滤过程、元数据字段,或如何混入训练。
-
摘录未描述非 Pile 语料的裁剪策略、元数据构建或正式数据划分。包括规模、过滤和重训练影响的定量使用细节仅针对 Pile 实验提供。
方法
作者提出名为 In-Run Data Shapley 的数据归因框架。中心设计原则是避免在训练数据的指数级多个子集上重新训练模型。相反,该方法将单次训练视为一系列梯度更新步骤,并将每一步的损失变化归因于参与该步骤的数据点。这形成“分而治之”框架:原先在整个训练过程中评估训练集价值这一高层问题被分解为许多小的局部归因问题,每个 mini-batch 更新对应一个。数据点的最终分数是其在所有被采样迭代中贡献的总和。
核心思想从通常的随机训练设置开始。参数为 wt 的深度学习模型通过在数据集 Dtr={zi}i=1N 上最小化训练损失(例如 ∑iℓ(w,zi))进行训练。在第 t 次迭代,采样一个 mini-batch Bt⊆Dtr,参数按如下更新
wt+1:=wt−ηtz∈Bt∑∇ℓ(wt,z),其中 ηt 是学习率。因此,完整训练过程产生检查点序列 {w0,w1,…,wT}。
为衡量子集 S 对单次更新的影响,作者定义局部效用函数。对于验证点 z(val),第 t 次迭代中的效用是在梯度更新中只使用 S 而非完整 batch Bt 时,验证损失的反事实变化:
U(t)(S;z(val)):=ℓ(wt+1(S),z(val))−ℓ(wt,z(val)),其中
wt+1(S):=wt−ηtz∈S∑∇ℓ(wt,z).该局部效用定义在 batch Bt 上。它可以通过对 Bt 之外的点赋予零影响而扩展到完整训练集。由此得到的每迭代 Shapley 值只捕捉每个被采样点对该次梯度更新的即时贡献。由于 batch 采样过程在训练过程中固定,该效用函数对此次迭代成为确定性的,并且也能通过基于已实现状态的条件化来编码其他形式的训练随机性,例如 dropout。
该方法随后在整个训练过程中聚合这些局部效用。全局效用函数定义为
U(S;z(val))=t=0∑T−1U(t)(S;z(val)).这表示在模型沿相同检查点轨迹和 batch 实现这一反事实假设下,在所有更新中使用子集 S 造成的累积验证损失变化。由于 Shapley 值对于效用函数是线性的,全局归因就是局部归因之和:
ϕz(U)=t=0∑T−1ϕz(U(t)).因此,训练点的最终 In-Run Data Shapley 分数是它在所出现的所有梯度更新中产生的累积贡献。如果模型在验证集 D(val) 而非单个验证点上评估,作者利用同样的线性性质,通过累加所有验证点的分数来计算总归因。
该方法的关键部分为使 Shapley 计算可处理。直接对 mini-batch 的所有子集评估 U(t)(S) 不可行。作者因此通过在当前模型参数 wt 处的泰勒展开近似局部效用。一阶近似为
U(1)(t)(S)=∇ℓ(wt,z(val))⋅(wt+1(S)−wt).将梯度更新形式代入可得
U(1)(t)(S)=−ηtz∈S∑∇ℓ(wt,z(val))⋅∇ℓ(wt,z).该近似在子集 S 上具有可加性,因此允许闭合形式的 Shapley 值:
ϕz(U(1)(t))=−ηt∇ℓ(wt,z(val))⋅∇ℓ(wt,z).在整个训练过程中累积得到一阶 In-Run Data Shapley 估计器:
ϕz(U)≈t=0∑T−1ϕz(U(1)(t)).在该公式下,当数据点在当前检查点处的梯度方向与验证点的梯度方向一致时,它获得正的归因。负归因表示该训练点把模型推向使验证损失增加的方向。该一阶分数与梯度对齐归因密切相关,但 In-Run Data Shapley 视角将其澄清为一阶近似效用的 Shapley 值。
该方法还包含二阶近似。局部效用的泰勒展开包含一个曲率项,涉及 wt 处验证损失的 Hessian:
Ht(z(val)):=∇2ℓ(wt,z(val)).二阶局部效用写为
U(2)(t)(S)=21(wt+1(S)−wt)⊺Ht(z(val))(wt+1(S)−wt).在二阶近似 U(t)≈U(1)(t)+21U(2)(t) 下,Shapley 值仍具有闭合形式结构。训练点 z 的分数包含两个主要部分:
ϕz(U)≈t=0∑T−1direct influence of z−ηt∇ℓ(wt,z(val))⋅∇ℓ(wt,z)+21interaction termϕz(U(2)(t)).交互项可展开为
21ϕz(U(2)(t))=2ηt2∇ℓ(wt,z)⊺Ht(z(val))zj∈Bt∑∇ℓ(wt,zj).该交互项捕捉同一 batch 中其他训练点的存在如何影响 z 的归因值。直观上,如果 batch 中包含许多相似或重复的点,交互项会在它们之间重新分配价值,防止单个冗余副本获得过大的贡献。因此,二阶方法既衡量数据点相对于验证目标的有用性,也衡量其在 batch 中的独特性。
高效计算模块是让该方法可实践的核心。一阶估计器的直接实现需要计算 batch 中每个数据点的单独梯度,难以利用常规 mini-batch GPU 训练。作者用 “ghost dot product” 技术解决此问题。该名称反映单独梯度向量从未被显式物化。相反,该方法复用反向传播过程中已经产生的量。
对于线性层,输出可以写成
s=aW,其中 W 是权重矩阵,a 是 mini-batch 输入,s 是预激活输出。对于样本 i,其损失相对于 W 的梯度可以表示为输入激活与其输出梯度的外积:
∂W∂ℓ(i)=∂s(i)∂ℓ(i)⊗a(i).为计算两个样本梯度的点积,可以针对外积结构的点积分解为较小激活张量与输出梯度张量的点积。对于两个样本,
∂W∂ℓ(1)⊙∂W∂ℓ(2)=((a(1))Ta(2))((∂s(1)∂ℓ(1))T∂s(2)∂ℓ(2)).a(i) 和 ∂ℓ(i)/∂s(i) 在反向传播过程中均已可用。因此,一阶归因所需的成对梯度点积可以在训练 batch 的同一次反向传播内计算。为纳入验证点,可以对合并损失执行反向传播
z∈Bt∑ℓ(z)+ℓ(z(val)),这避免仅为验证点进行单独反向传播。这一设计是一阶 In-Run Data Shapley 方法能在标准训练之外仅增加极少额外时间内运行的主要原因。
对于二阶估计器,挑战更大,因为交互项需要梯度 Hessian 梯度乘积。作者开发了相关的 “ghost” 计算,通过每次迭代额外一次反向传播获得这些乘积。该技术不形成每个样本或每个数据点的完整梯度尺寸向量,而是利用神经网络梯度的分层结构,并复用中间激活和输出梯度。因此,二阶方法每次训练迭代大约需要两次反向传播:一次用于合并的训练与验证计算,另一次额外用于二阶交互项。这仍比直接构造所有逐样本梯度和完整二阶曲率量便宜得多。
整体训练工作流可视为加入归因记账的标准深度学习循环。每次迭代,系统采样一个 batch,执行通常的前向传播,记录或复用归因所需的激活和输出梯度信息,计算局部一阶贡献项,可选地计算二阶交互项,累积每个数据点的分数,并应用常规参数更新。训练结束后,累积的逐数据点分数构成该训练产生的特定模型检查点的 In-Run Data Shapley 归因。
实验
实验从运行效率、近似保真度以及语言模型预训练期间的实际数据归因三个方面评估 In-Run Data Shapley。实验表明该方法计算可行,能准确近似 Shapley 值,并能识别负贡献训练数据;与基于 influence function 的过滤相比,移除这些数据可改善收敛。额外案例研究表明数据价值会随训练阶段变化,并且在输出被高度改写时仍能检测到相关训练语料,表明模型行为可以在无需逐字记忆的情况下受到影响。
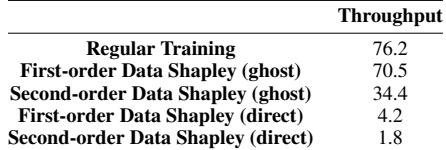
运行时间评估显示,使用 ghost dot product 吞吐量的 first order In Run Data Shapley 接近常规训练吞吐量。由于额外反向传播,second order ghost 计算比常规训练慢约两倍,但两种 ghost 变体均明显快于直接逐样本梯度实现。这些效率趋势使一阶和二阶 In-Run Data Shapley 比朴素方法更实际。ghost dot product 保持一阶 Data Shapley 吞吐量接近常规训练吞吐量。ghost vector Hessian vector product 使二阶 Data Shapley 吞吐量约为常规训练的一半。直接实现在一阶和二阶计算中的吞吐量均远低于 ghost 实现。
该实验比较不同排名归因分数在验证数据从释义到主题改写变化时如何对原始语料排序。In-Run Data Shapley 和 influence function 在密切相关或语义相似的案例中使原始语料排名很高,而 BM25 在词汇重叠消失后明显减弱。influence function 给出的原始语料排名略低于 In-Run Data Shapley,这与噪声较大的留一法估计一致。语义归因可以在改写或主题相关数据中揭示原始语料。BM25 更依赖逐字相似性,而不是更广泛的相关贡献。In-Run Data Shapley 在释义案例中比 influence function 更倾向于将原始语料排名更高。
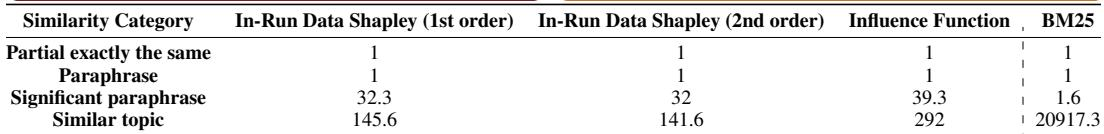
实验同时评估 In-Run Data Shapley 相对于 influence function 和 BM25 的运行效率和排名行为。结果表明,基于 ghost 的计算使一阶和二阶归因比直接逐样本实现更实际,因为 ghost 方法保持接近常规训练的吞吐量。排名测试进一步表明,语义归因方法能够在被改写或主题改写的验证数据下识别原始语料,而 BM25 过度依赖词汇重叠,并在该重叠消失时明显变弱。